
Token Cleaning:告别冗余,LLM 指令微调进入“Token 原子级”时代
Token cleaning: Fine-grained data selection for llm supervised fine-tuning
本文提出了 Token Cleaning,一种针对大语言模型指令微调(SFT)的细粒度数据选择方法。通过对比基础模型与参考模型的 Token 级影响(Influence),该方法能有效识别并过滤掉冗余或无信息的 Token,在 3B-8B 规模模型上实现了显著的性能提升。
TL;DR
在 Supervised Fine-Tuning (SFT) 阶段,并非所有的 Token 都生而平等。本文提出了一种 Token Cleaning 管线,通过计算 Token 级的影响力得分,精准剔除那些“毫无养分”的冗余 Token。实验证明,即使是在精选的高质量数据集中,过滤掉 30%-40% 的 Token 反而能让模型在 downstream 任务上表现得更好。
背景:样本级清洗的局限性
目前学术界和工业界的共识是:SFT 数据质量远比数量重要(Quality > Quantity)。现有的 SFT 数据筛选方法(如难度评估、语义多样性过滤)大多是以“样本”为最小单位的。
然而,作者指出:即便是一个高质量的回答,也充满了噪声。
- 预训练残留:预训练阶段已经学烂了的常用表达(如 "The", "is", "I'm sorry but...")。
- 冗余信息:与任务核心逻辑无关的连接词或背景套话。
- 噪声干扰:这些 Token 在训练时会产生梯度偏移,稀释了关键任务信号。
核心直觉:从噪声标签视角看 SFT
如果我们把 SFT 看作是一个“标签预测”过程,那么每个 Token 就是一个标签。既然并不是每个 Token 都有助于模型对齐,那么那些无信息的 Token 就可以被视为噪声标签。
影响力驱动的评分机制 (Influence-Guided Scoring)
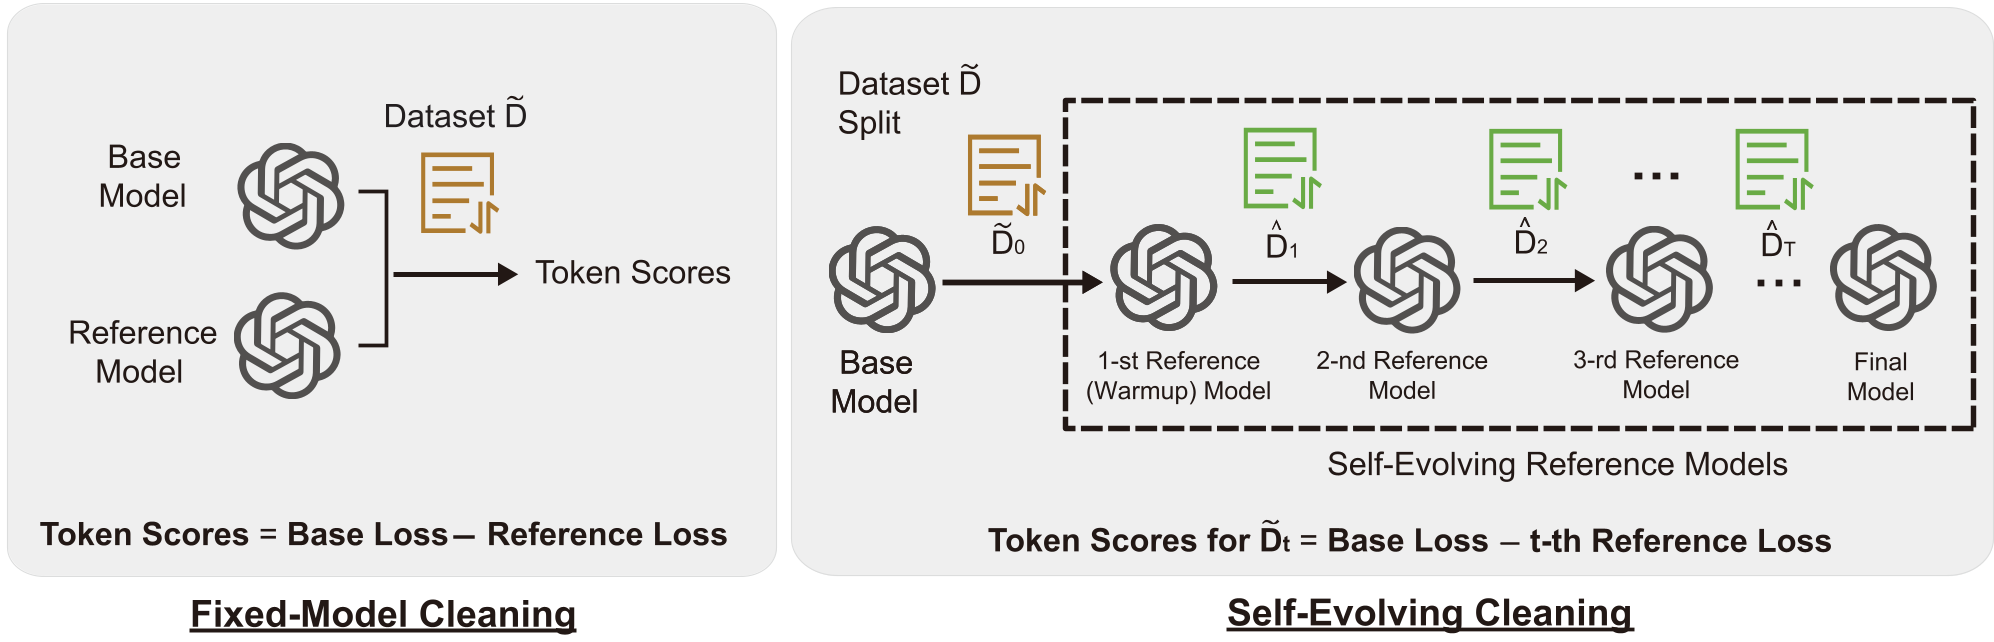
如何判断一个 Token 是不是“好”的?作者使用了 Influence 概念: 其中 是原始的基础模型, 是微调后的参考模型。
- 如果 对该 Token 的预测效果远好于 ,说明这个 Token 蕴含了大量微调阶段才学到的“新知识”,质量高。
- 如果两者表现一致,说明这只是个预训练模型早就会了的“通用 Token”,价值低。
两种进化路线
- Fixed-Model Cleaning:固定参考模型,对全量数据一次性“收割”。
- Self-Evolving Cleaning:边练边选。先用一部分数据热身,用热身得到的模型去清洗下一批数据,迭代演化。作者发现这种方式能产生“马太效应”:强的任务领域清洗得越来越准,模型在关键任务上的表现显著拉升。
实验战绩与深度洞察
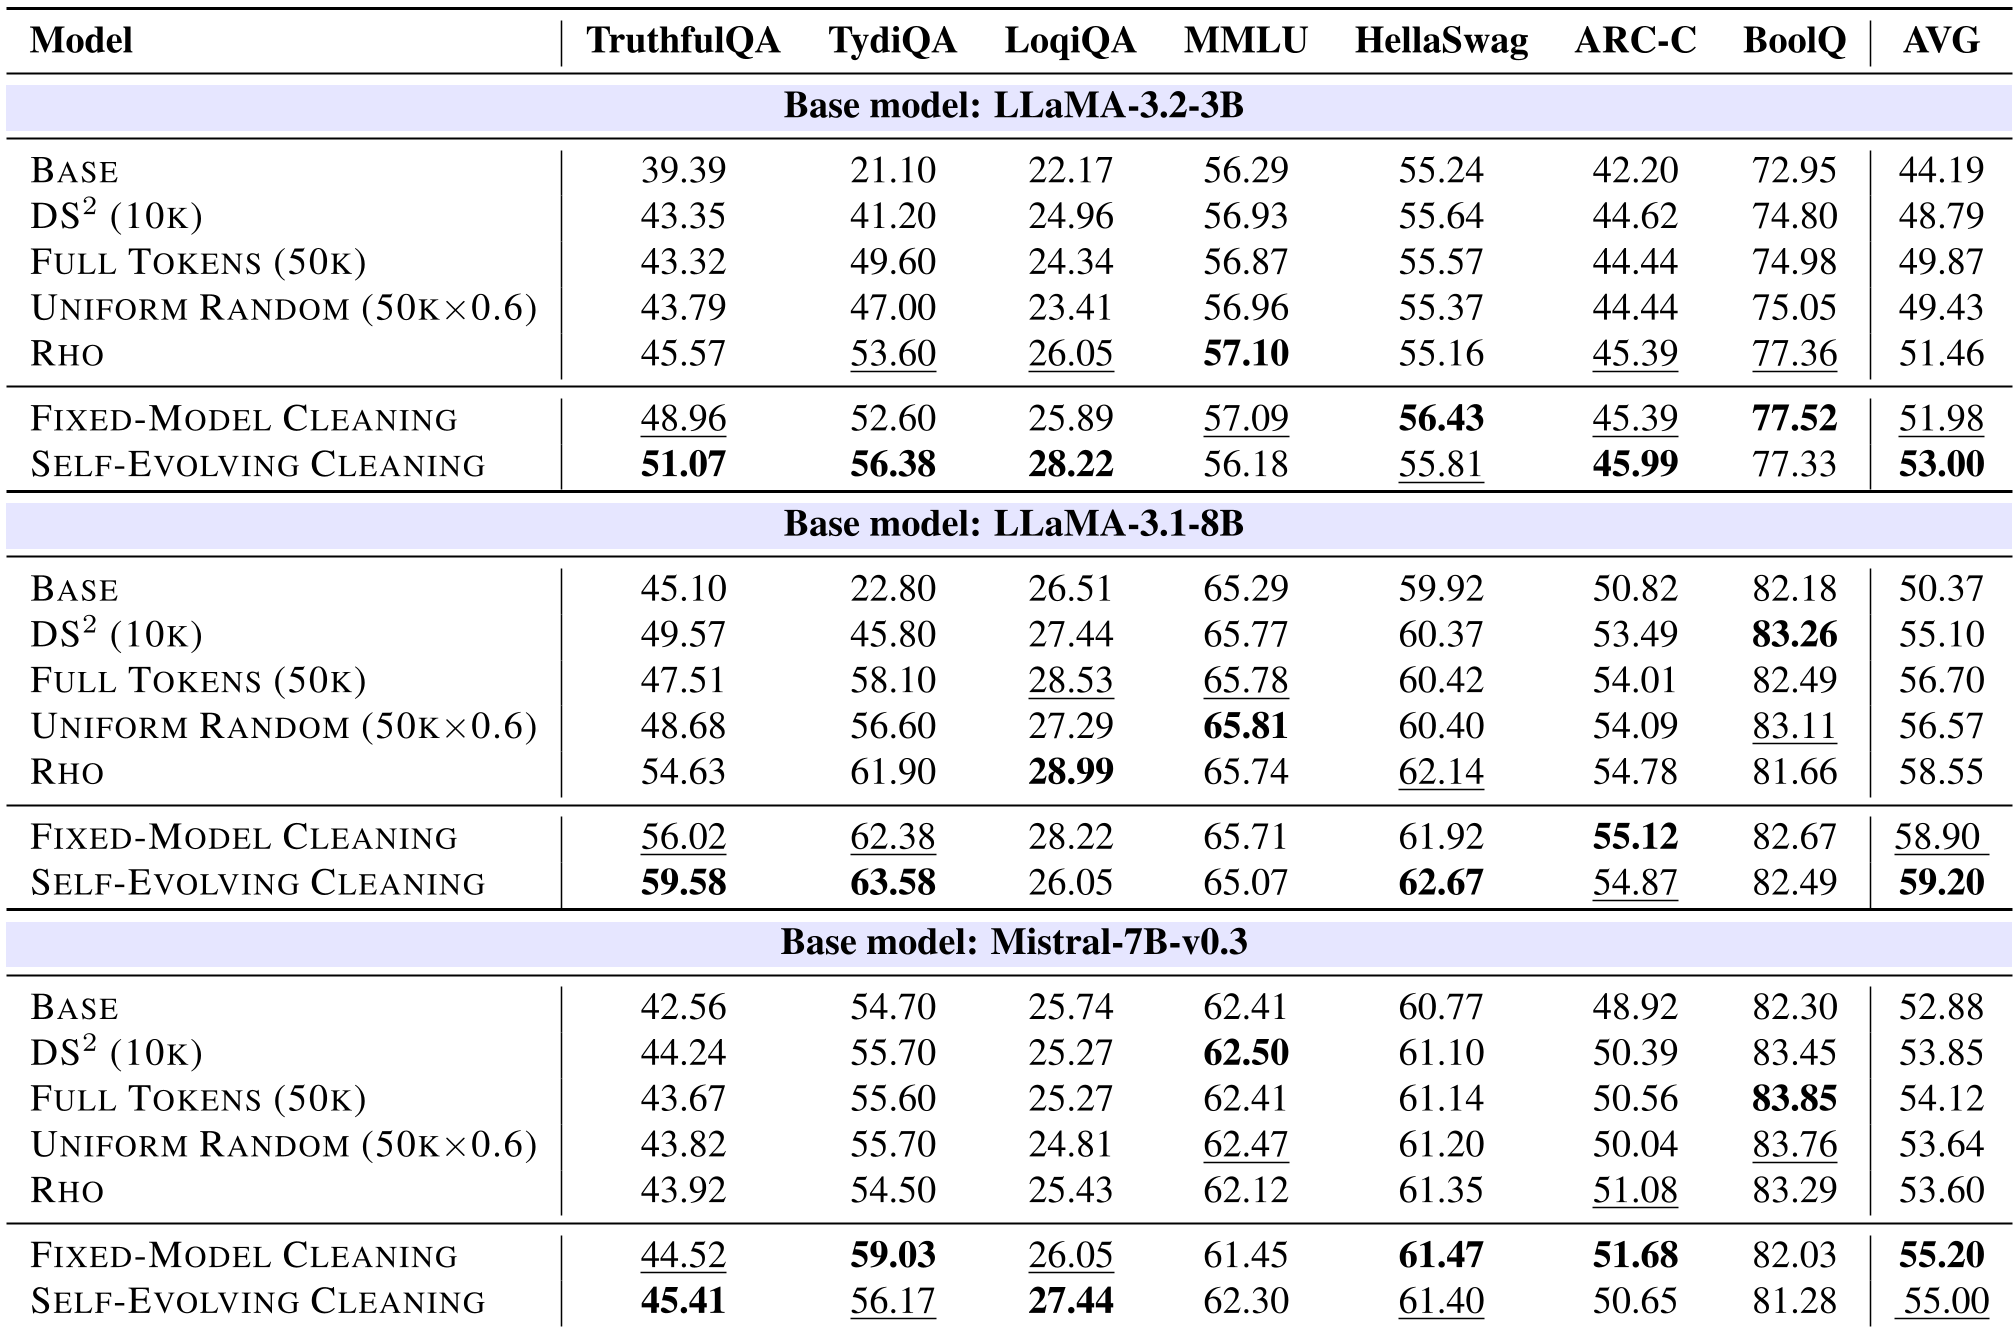
作者在 LLaMA-3.2-3B、LLaMA-3.1-8B 和 Mistral-7B 上进行了广泛测试。
1. 全球排名优于局部排名
相比于此前的 RHO 方法(在每个样本内固定比例删除 Token),本文支持 Global Ranking(全数据集 Token 统一排队)。这样可以彻底放弃整个坏样本,而保留好样本中几乎所有的 Token。
2. 70% 是魔数
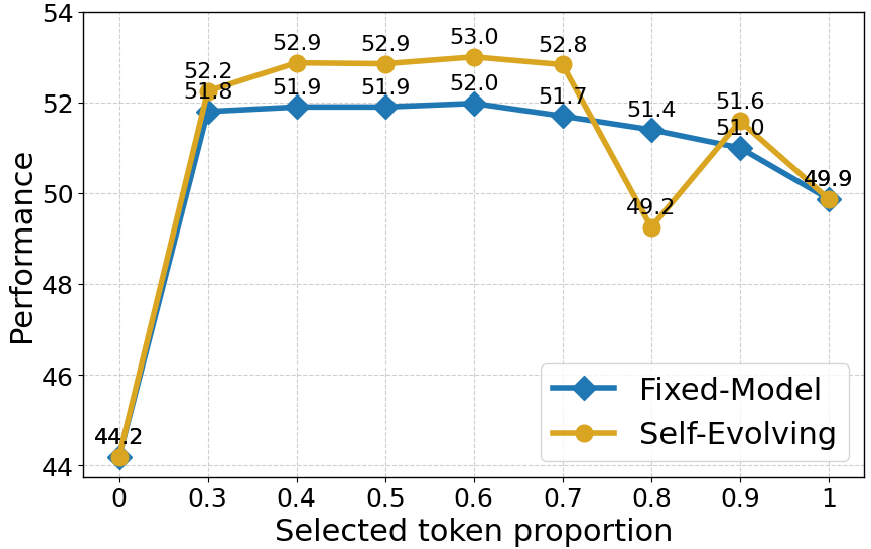
通过消融实验(Ablation Study),作者发现保留 60%-70% 的 Token 能达到性能峰值。这不仅节省了计算资源(虽然目前实现主要关注效果,训练时间缩减尚不明显),更重要的是证明了 SFT 阶段数据存在极大的“通胀”。
结论:少即是多 (Less is More)
Token Cleaning 并非简单的“删减”,它本质上是提升信噪比 (SNR)。
- 理论贡献:本文提供了严谨的误差上界证明(Theorem 5.1),解释了为什么数据质量的提升可以补偿数据数量的减少。
- 实践意义:它为未来高效 SFT 提供了一个新思路——我们不需要全量微调 response 中的每一个词,只需聚焦于那些能带给模型“启发”的关键 Token。
局限与展望
尽管性能优秀,但目前的 Token Cleaning 在训练效率(Training Speedup)上仍有提升空间。目前的实现是基于 Mask 的,虽然屏蔽了 Loss 计算,但计算图中依然保留了这些 Token。未来如何实现真正的“稀疏训练”以大幅缩短 SFT 时间,是该领域极具潜力的研究方向。