
TIP:别再浪费显存了!找出那 20% 真正让 LLM 变聪明的 Token
TIP: Token Importance in On-Policy Distillation
本文提出了 TIP (Token Importance in On-Policy Distillation),一种基于学生模型信息熵和师生差异性的双轴分类法。通过该方法识别并仅在关键 Token(如“过度自信”的错误点)上进行训练,在 MATH-500 和 AIME 等基准测试中,仅使用 10%-20% 的 Token 即可达到或超过全量 Token 训练的效果,同时显著降低显存开销。
TL;DR
大模型的策略内蒸馏(On-Policy Distillation, OPD)通常非常耗费资源,因为每一轮训练都要处理学生模型生成的冗长序列。TIP 论文揭示了一个惊人的事实:LLM 学习的本质在于纠偏。 通过结合“学生模型的困惑度(Entropy)”和“老师的反对意见(Divergence)”,我们只需要训练序列中不到 20% 的关键 Token,就能获得比全量训练更好的效果,且显存占用直接腰斩。
痛点深挖:困惑度(Entropy)的“致命盲点”
在以往的研究中,大家普遍认为“高熵(High Entropy)”的 Token 最重要,因为那代表模型还不确定,需要学习。但 TIP 团队指出,这只对了一半。
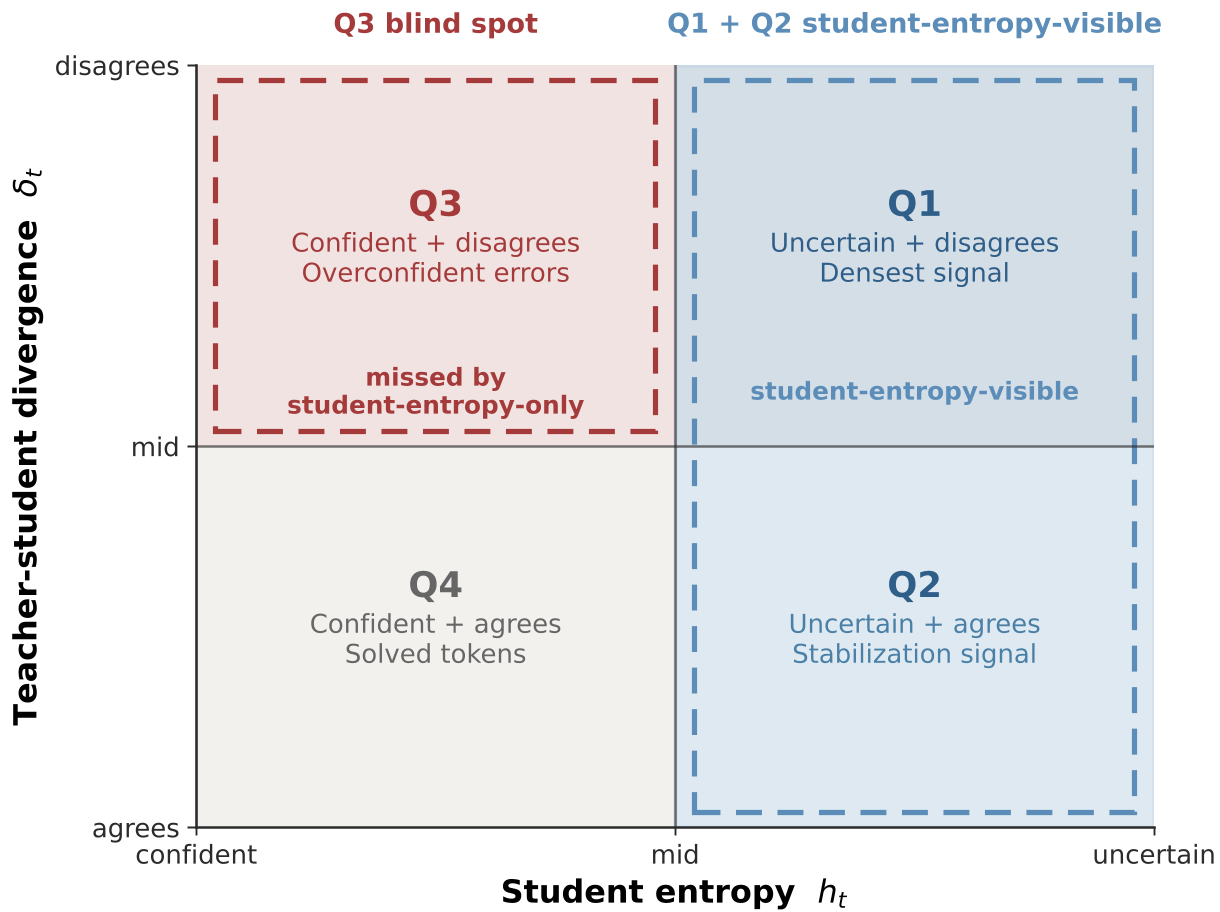
现有的选择机制对 Q3 象限(低熵但高差异) 视而不见。想象一下,一个学生非常自信地算错了一道数学题(低熵),如果只训练他感到困惑的地方(高熵),这个严重的错误点就会被跳过。论文指出,这种“过度自信的错误”包含着密度极高的校准信号,是区分“好模型”与“强模型”的关键。
核心方法:TIP 两轴分类法
作者将 Token 空间划分为四个象限:
- Q1 (高熵, 高差异):学生不确定且做错了,急需纠错。
- Q2 (高熵, 低差异):学生不确定但猜对了,需要巩固。
- Q3 (低熵, 高差异):过度自信的盲点,学生确信自己是对的但被老师当头一棒。
- Q4 (低熵, 低差异):已完全掌握,继续训练只会浪费算力。
为了自动过滤 Q4 并保留 Q3,作者提出了 Soft-OR 评分: 这个公式巧妙地实现了:只要“熵”或“差异性”其中一个高,Token 就会被选中。它不需要任何超参数调节,且计算开销几乎为零(因为 KL 散度本身就是蒸馏的 Loss,顺手就能存下来)。
实验结果:以少胜多的艺术
研究团队在数学竞赛(MATH-500, AIME)和复杂的智能体规划(DeepPlanning)上验证了该方法。
1. 突破性能瓶颈
在推理能力极强的 Qwen3-4B 模型上:
- 100% Token 训练:MATH 分数 76.7。
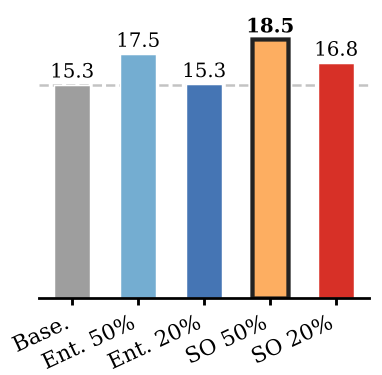
- 50% Soft-OR 采样:MATH 分数提升至 79.1。 这说明剔除 Q4 象限的“废话 Token”不仅省钱,还能减少梯度中的噪声,让学习更聚焦。
2. 恐怖的显存优化
由于只需要对一小部分 Token 计算梯度(Backward),显存占用大幅下降。实验显示,在保留 50% Token 时,显存从 72GB 降至 38GB。这意味着原本需要 8 张 H200 才能跑的任务,现在单机 4 张卡甚至更少就能搞定。
深度洞察:为什么 Q3(过度自信)在推理任务中如此致命?
作者给出了一个非常直观的例子: 在数学推导中,如果学生模型在第一步就自信地写错了一个正负号(Q3),后续的所有推导即使逻辑正确也是南辕北辙。在 Agent 规划中更是如此,一个自信但错误的行程预订会导致整个计划崩溃。TIP 通过精准捕捉这些“自信的转折点”,实现了极高的训练效率。
局限性与展望
虽然 TIP 在 70B 以下的模型上表现优异,但在万亿参数规模或极其漫长的 Agent 思考链(Reasoning Trajectory)中,Q3 象限的分布是否会发生漂移仍需验证。此外,这种基于 Token 级别的动态修剪,对于现在的固定张量计算框架(如 PyTorch)虽然能通过 Mask 节省梯度计算,但前向传播(Forward)的计算量依然存在。
总结: TIP 告诉我们,LLM 训练不需要“题海战术”,抓住那 20% 让它产生怀疑和被纠错的时刻,才是通往更强智能的捷径。