
SAE-SPLADE:将检索维度从“单词”升维至“概念”
From Tokens to Concepts: Leveraging SAE for SPLADE
本文提出了 SAE-SPLADE,一种将稀疏自编码器(SAE)与稀疏检索模型 SPLADE 结合的新型架构。通过将原本依赖 Token 词表的投影层替换为基于 SAE 学习到的语义概念(Latent Concepts)空间,该方法在保持 SOTA 检索精度的同时,显著提升了检索效率和多语言适应性。
TL;DR
在信息检索(IR)领域,SPLADE 曾凭其出色的稀疏表示和词表扩展能力坐稳了第一梯队的交椅。然而,传统的 SPLADE 始终被困在“Token”的笼子里。本文介绍的 SAE-SPLADE 尝试了一项大胆的革新:利用**稀疏自编码器(SAE)**从预训练模型中挖掘出超越单词的“语义概念”,并以此作为检索的基本单位。结果证明,这种转向不仅让模型运行得更快(QD-FLOPs 降低 50% 以上),而且在处理多语言和复杂语义时更加游刃有余。
痛点深挖:Token 词表的原罪
目前的 Learned Sparse Retrieval (LSR) 模型大多是“戴着枷锁跳舞”。其投影层直接映射到 BERT 的词表上。这种方式存在天然缺陷:
- 语义鸿沟:同一个词(如 'bank')在不同语境下意义迥异,而 Token 层面的匹配无法区分“银行”还是“河岸”。
- 效率冗余:为了覆盖语义,模型不得不进行大量的项扩展(Term Expansion),导致索引膨胀。
- 跨语言障碍:中文的“苹果”和英文的“Apple”在词表中是完全隔离的 ID,导致模型必须依赖复杂的对齐技术才能进行多语言检索。
核心机制:SAE 带来的语义词表
SAE-SPLADE 的核心直觉是:如果我们将隐藏状态投影到一个极其稀疏但维度极高的“概念空间”中,每个维度代表一个特定的语义特征,检索效率会如何?
1. 架构重构
作者摒弃了原有的 MLM Head,改为在预训练模型的 Layer 6 之后接入 SAE Encoder。这个过程分两步走:
- SAE 预训练:在 MS MARCO 上重建 Token 嵌入,学习出一套过完备(Overcomplete)的基向量。
- 任务微调:将 SAE 编码器作为检索头,结合 KL 散度和 MarginMSE 蒸馏损失进行针对检索任务的 fine-tuning。
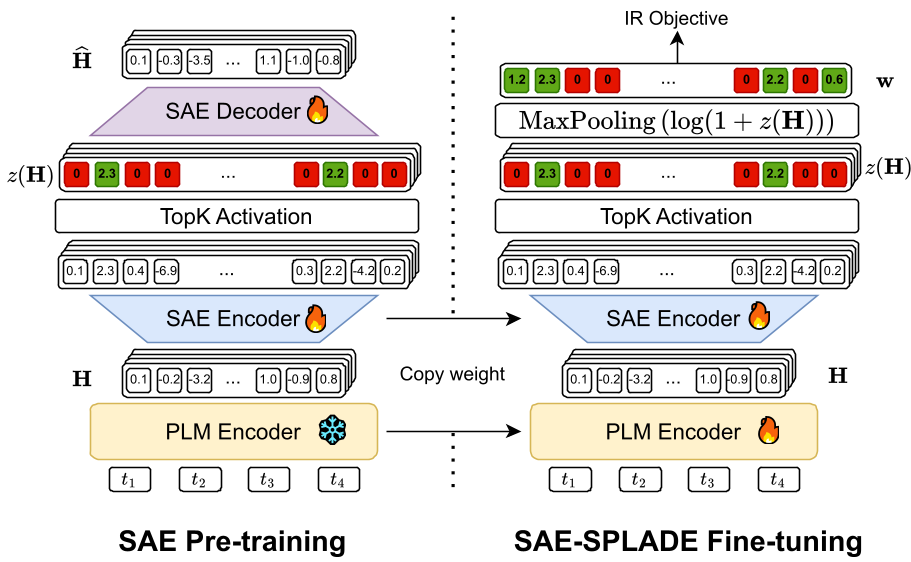 图 1:SAE-SPLADE 架构。左侧为 SAE 预训练阶段,右侧为集成到 SPLADE 框架后的检索微调阶段。
2. Top-k 约束的力量
与传统正则化不同,SAE-SPLADE 引入了强制的 Top-k 激活机制。在每个 Token 级别只保留最重要的 个语义维度。实验发现,即便 值很小(如 ),模型也能捕捉到核心语义,并在 QD-FLOPs 指标上展现出极高的压缩比。
实验与结果:效能的双重突破
1. 效率惊人
在评估检索效率的关键指标 QD-FLOPs 上,SAE-SPLADE 表现抢眼。
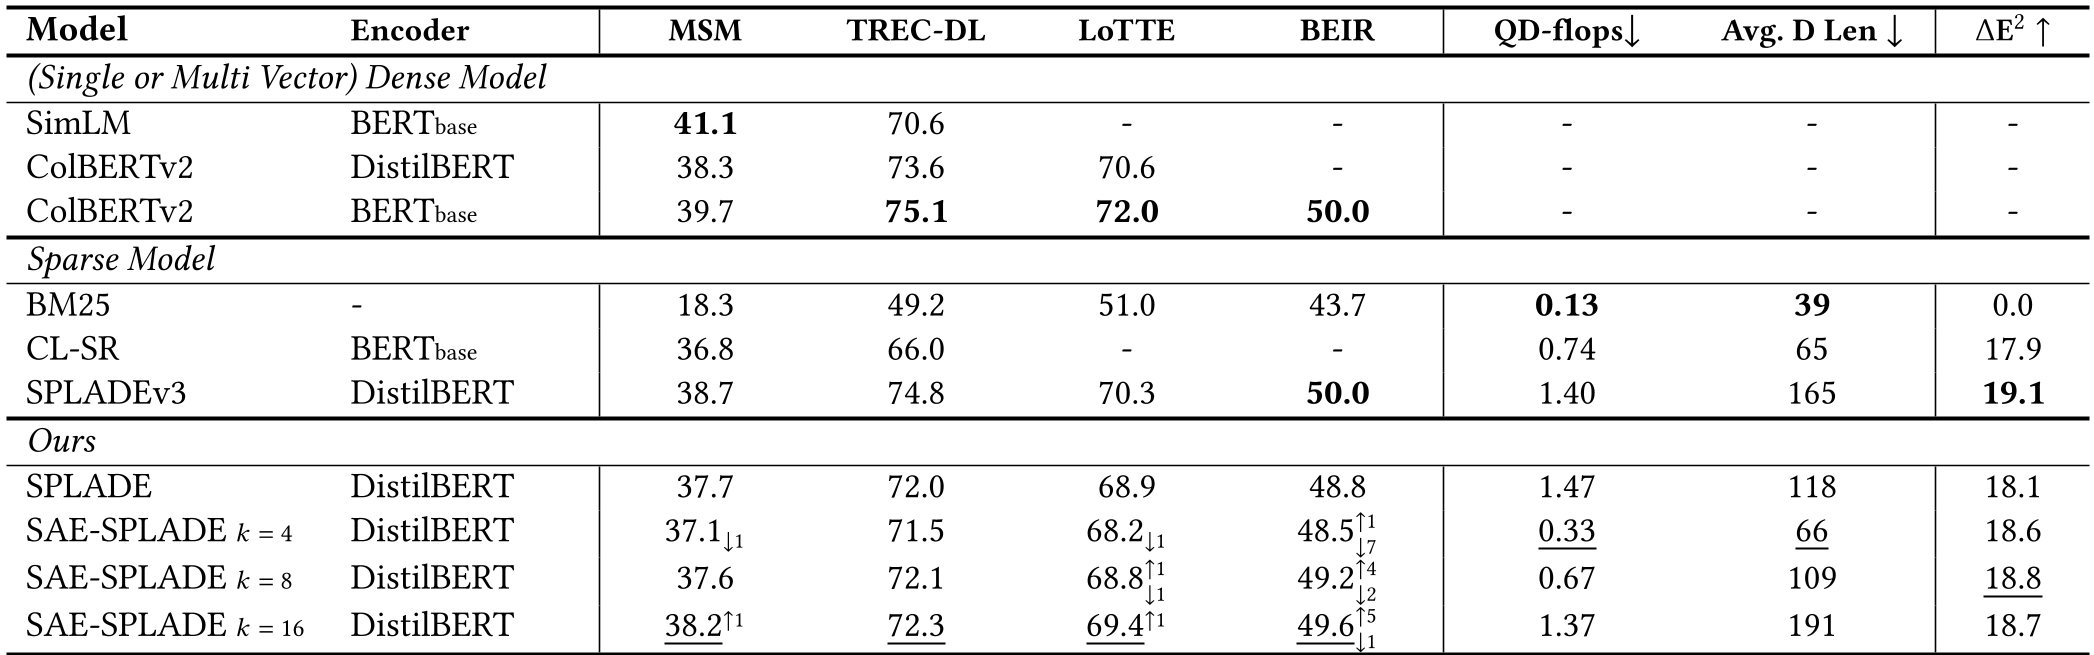 表 3:SAE-SPLADE 与 SPLADE 及其他基线的对比。可以看到 的 SAE-SPLADE 在保持 MRR 的同时,FLOPs 仅为原版的一半。
2. 多语言的天然亲和力
在 mMARCO 多语言数据集上的分析显示,SAE-SPLADE 在不同语言间(如中、英、俄)激活的潜在概念重合度显著高于传统 SPLADE 的 Token 重合度。这意味着 SAE 成功提取出了一些“跨语言”的通用特征,例如“宇宙学”这一概念。
3. 可解释性:从单词到概念
作者通过定性分析揭示了 Latent 背后代表的含义:
- Latent 6470: 对应饮食(Cuisine),它关联了 'dish', 'soup', 'sauce', 'spices' 等一系列相关词。
- Latent 48320: 对应烹饪方法,集合了 'fry', 'pork', 'cook', 'boil'。 这种聚类效应使得模型在检索时,不再是单纯的“关键词匹配”,而更像是“语义匹配”。
深度洞察:为什么 SAE 有效?
论文通过消融实验给出了一个有趣的结论:MLM 虽好,但非必需。SAE 通过重构隐藏状态,提供了一种比 MLM 更纯粹的语义压缩方式。此外,作者提出的新度量指标 为行业提供了一个平衡“精度-效率”的新标尺,这比单纯看 nDCG 更具工业参考价值。
总结与未来展望
SAE-SPLADE 证明了机械的词表匹配正逐渐向灵活的概念建模过渡。虽然目前与最顶尖的 Late-interaction 模型(如 ColBERTv2)在绝对精度上仍有细微差距,但其极致的存储潜力和极低的检索延迟,使其成为大规模工业级 SOTA 检索器的强力竞争者。
未来的路:作者指出,如何将 SAE 更好地扩展到像 Llama-3 这样的 Causal LLM 上,以及如何进一步弥合 SAE 重构目标与 IR 检索目标之间的冲突,将是接下来该领域最前沿的战壕。