
Toto 2.0:时间序列预测正式进入 Scaling 时代
Toto 2.0: Time Series Forecasting Enters the Scaling Era
本文推出了 Toto 2.0,这是一个包含 5 个尺寸(从 4M 到 2.5B 参数)的时间序列基础模型(TSFM)家族。该工作首次证明了时间序列模型具备可靠的可扩展性(Scaling),在 BOOM、GIFT-Eval 和 TIME 三大基准测试中均刷新了 SOTA 纪录。
TL;DR
在大型语言模型(LLM)统治 AI 领域的今天,时间序列预测(Time Series Forecasting)是否也能通过“堆算力、堆数据、堆参数”产生质变?Datatog AI Research 给出了肯定答复。Toto 2.0 是一系列开源预测模型,它证明了:只要配方正确,时间序列模型也能像 GPT 一样,随着参数量从 4M 扩展到 2.5B,展现出极其稳定的性能增长。
痛点深挖:为什么时间序列模型以前很难 Scaling?
在 NLP 领域,我们可以简单地增加 Transformer 的层数和宽度。但在时间序列(TS)领域,这通常行不通:
- 超参敏感性:随着模型变宽,最优学习率(Learning Rate)会剧烈波动,导致大模型难以训练。
- 分布不稳:传统模型常使用 Student-T 混合模型作为输出头,但在模型规模增大、激活值变高时,数值稳定性极差。
- 预测漂移:自回归解码(一步步预测未来)在处理长序列时,前一步的微小误差会不断放大。
核心架构:Toto 2.0 的技术进化
Toto 2.0 延续了 Decoder-only 的架构,但在底层机制上进行了大刀阔斧的改革。
1. 连通补丁掩码 (CPM) —— 告别低效自回归
Toto 2.0 引入了 Contiguous Patch Masking (CPM) 技术。训练时,模型随机掩掉一段连续的时间补丁;推理时,直接一次性给出整个预测窗口。这不仅提升了推理速度(单次 forward 完成预测),更从根本上规避了自回归产生的误差累积问题。
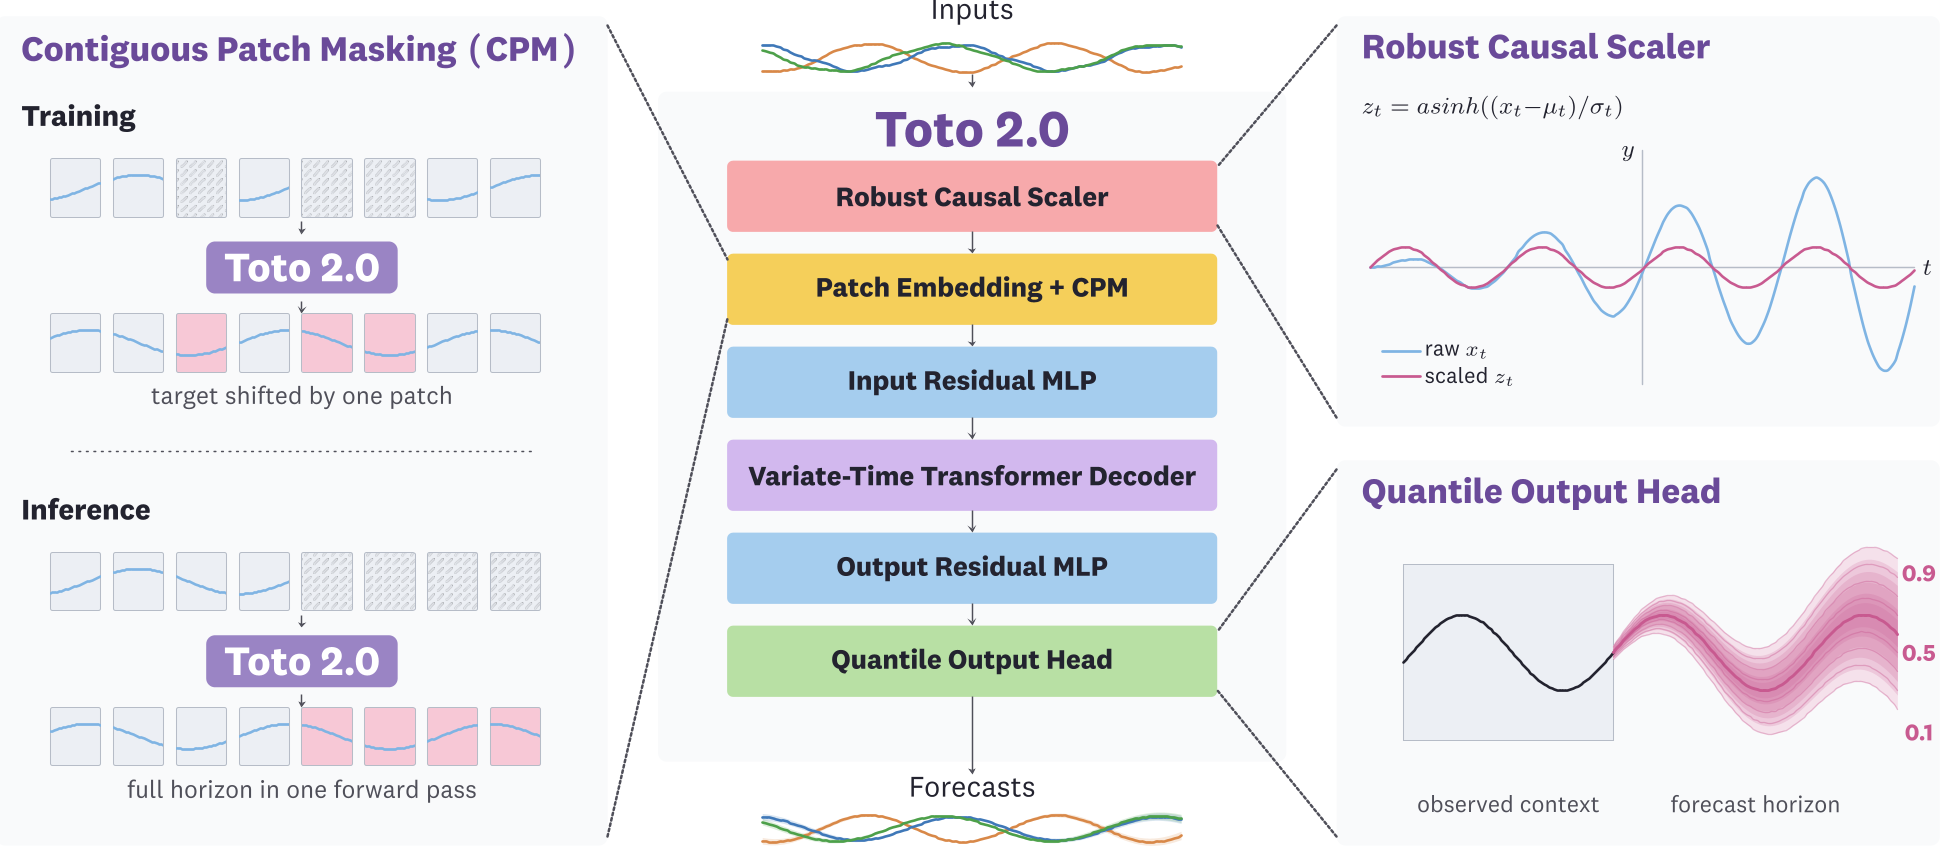
2. 核心底座:u-µP 与 NorMuon
为了实现无损的可扩展性,作者采用了 u-µP (Unit-scaled Maximal Update Parametrization)。这意味着研究员可以在一个极小的 10M 代理模型上“暴力”搜索最优的学习率和数据配比,然后直接套用到 2.5B 模型上,无需任何二次调优。
在优化器方面,Toto 2.0 放弃了传统的 AdamW,采用了 NorMuon。由于分位数损失(Pinball Loss)的梯度是阶跃式的(正负号驱动),AdamW 难以准确估计步长,而 NorMuon 通过正交化更新方向,显著提升了训练效率。
实验战绩:全线 SOTA
作者在三大基准测试中对 Toto 2.0 进行了压力测试:
- BOOM:针对可观测性(CPU、延迟等)的专业指标。
- GIFT-Eval:通用的跨域基准。
- TIME:专门对抗测试集污染的新型基准。
Pareto 前沿的统治力
实验结果显示,Toto 2.0 几乎在所有指标上都处于 Pareto 前沿(即在相同参数规模下,性能最强)。
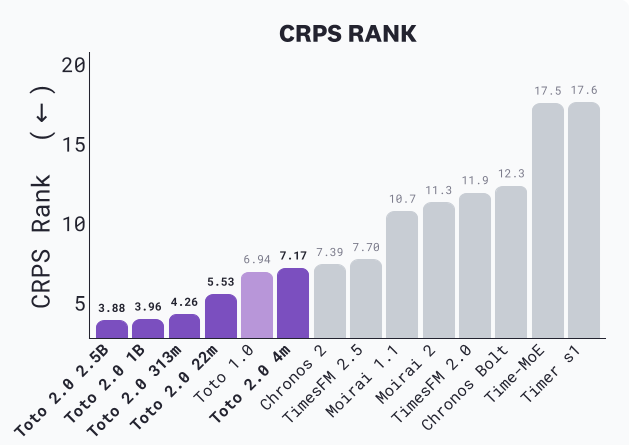
值得注意的是,Toto 2.0 在预训练阶段完全没有使用任何公开数据集,仅靠 Datadog 内部的监控指标和大量的合成数据。但在 GIFT-Eval 这种通用场景下,其泛化能力竟然超越了那些在海量公开数据上训练的模型(如 Chronos-2)。
长序列稳定性
通过对合成多尺度正弦信号的测试发现,2.5B 版本的 Toto 2.0 在预测 8192 个时间点后依然能保持完美的相干性,而小模型或其他前一代 SOTA 模型通常在 2000 步左右就开始“胡言乱语”。
深度洞察
Toto 2.0 的成功向工业界传递了一个重要信号:时间序列不再只是小模型的天下。 尽管目前在长程预测的外插能力上,基础模型相比最优的经典统计模型(如季节性朴素法)仍有细微差距,但其处理多变量交互、异构采样频率和冷启动预测的能力已形成跨代降维打击。
未来展望: 下一个瓶颈在于数据治理。正如 LLM 的竞争已转向数据质量,TSFM 领域也将从“如何堆叠 Transformer 层”转向“如何构建更高质量、更具真实物理规律的合成序列数据集”。
Toto 2.0 已开源其模型权重及分布式训练库 dd_unit_scaling。