
Training-Free GRPO:无需微调,让 671B 超大模型实现自我进化
Training-Free Group Relative Policy Optimization
本文提出了 Training-Free GRPO,一种无需微调参数即可实现强化学习优化效果的新范式。通过将 Group Relative Policy Optimization (GRPO) 的数值优势转化为 LLM 蒸馏后的“语义优势”,该方法在一系列复杂任务(如数学推理、Web 搜索)中通过外部经验库(Experiential Knowledge)引导模型输出分布。
TL;DR
腾讯 Youtu-Agent 团队最近发布了一项突破性工作:Training-Free GRPO。它在不改动模型任何参数的前提下,通过像强化学习一样的“采样-比较-总结”流程,让大模型学会特定领域的专家经验。在 AIME 数学竞赛中,这种方法仅需 18 美元的 API 成本,就能在性能上碾压那些耗资万元训练的微调模型。
核心定位:一种将 RL 优化从“参数空间”降维打击到“上下文空间”的非参数化对齐技术。
痛点深挖:参数调优的“穷究之路”
在 Agent 领域,传统的强化学习(如 PPO, GRPO)虽然强大,但面临三大顽疾:
- 算力黑洞:微调 32B 模型已是昂贵,微调 671B 的 DeepSeek-V3 简直是天文数字。
- 领域窄化:模型一旦为了数学任务微调,其原本泛化的 Web 搜索或代码能力往往会大幅退化。
- 数据饥渴:RL 往往需要数以千计的高质量轨迹,但在冷门垂直领域,数据极其稀缺。
作者提出一个深刻的洞察:LLM 已经具备了处理任务的基本能力,它们缺的不是“知识”,而是“经验优先验”(Token Prior)。
核心机制:Training-Free GRPO 详解
1. 从数值 Advantage 到语义 Advantage
传统 GRPO 依靠奖励模型(Reward Model)算出数值 Advantage 来更新梯度。Training-Free GRPO 则是让模型观察同一组(Group)采样中的“赢家”和“输家”,并用自然语言总结:“为什么 A 轨迹对了,而 B 轨迹由于符号错误失败了?”
这种总结出的文字就是 Semantic Advantage。
2. 架构对比
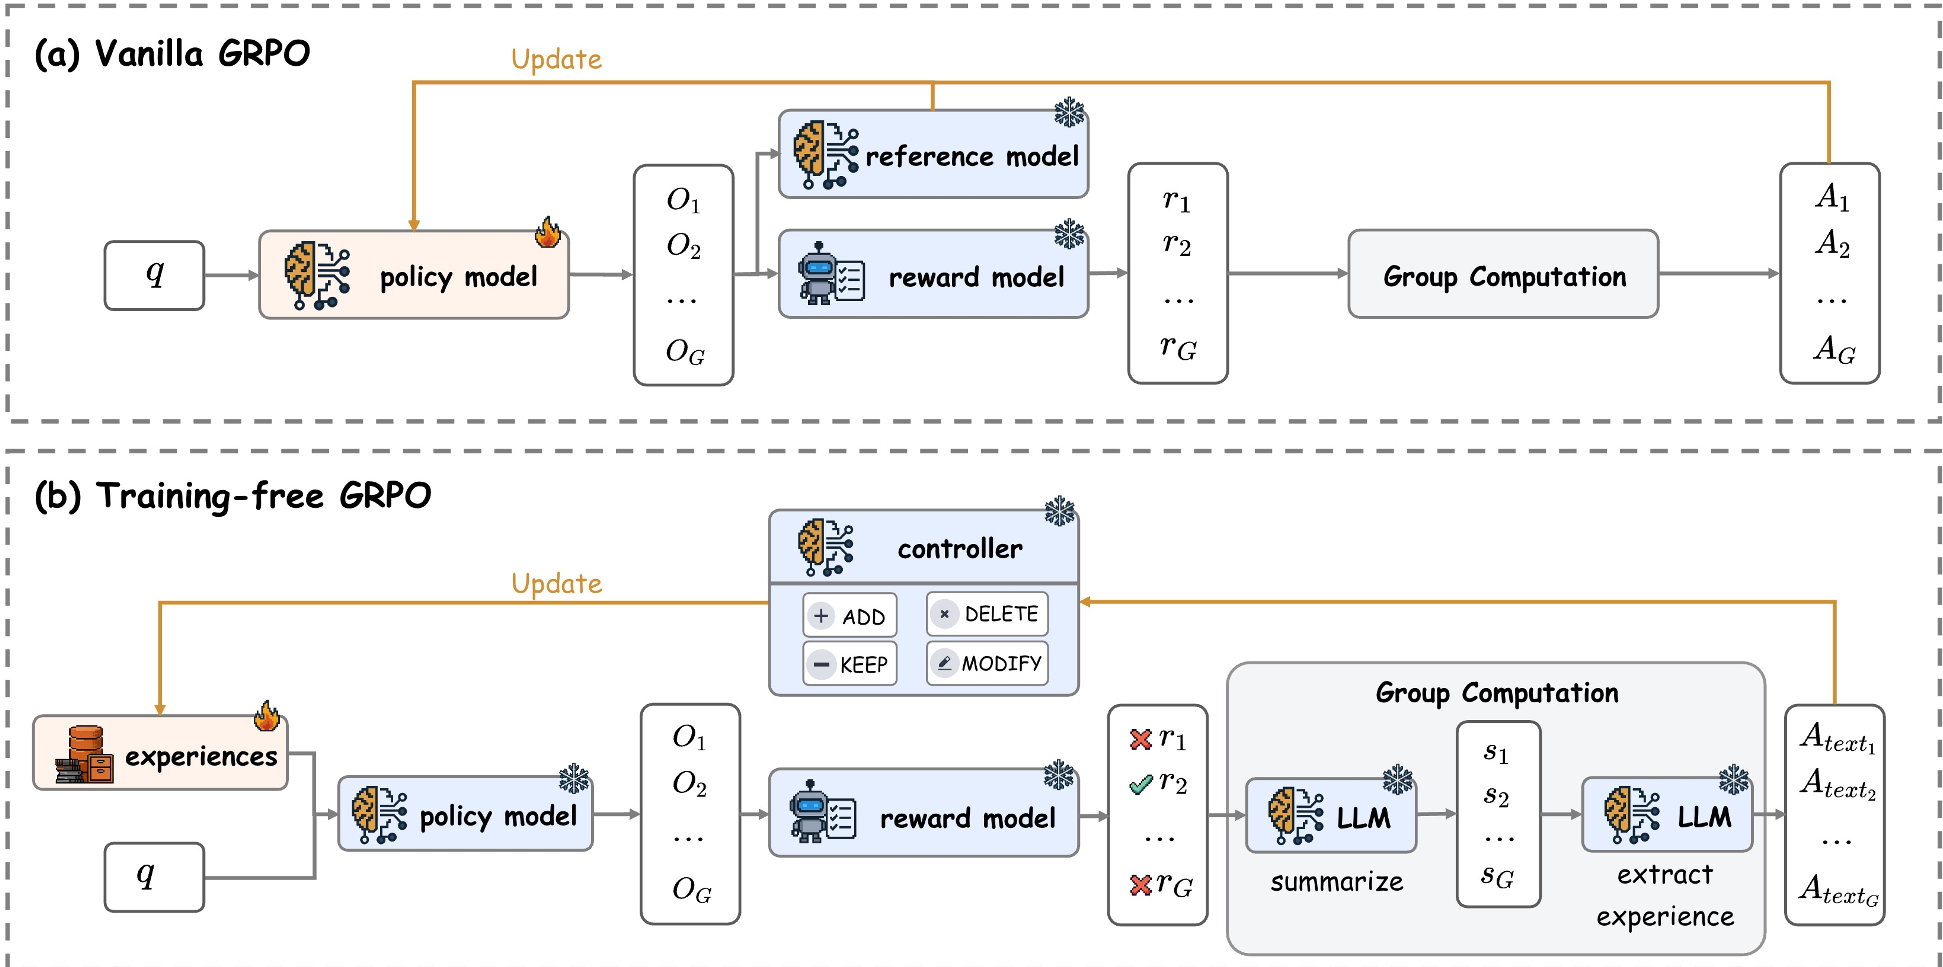 图 1:左侧为传统 GRPO(更新梯度),右侧为本文方法(更新经验库 E)
3. 三步走的优化策略
- Rollout & Reward:对同一个 Query 生成 G 个回复,并评分。
- Distill Experience:LLM 充当“教练”,分析高分轨迹的共同特征。
- Iterative Optimization:通过 Add/Delete/Modify 三种操作动态维护一个“经验库 E”。当下一次遇到类似问题时,这些经验会作为 System Prompt 注入,引导模型回避之前的坑。
实验战绩:低成本的奇迹
在极具挑战性的 AIME24/25 数学竞赛中,该方法展现了惊人的效率:
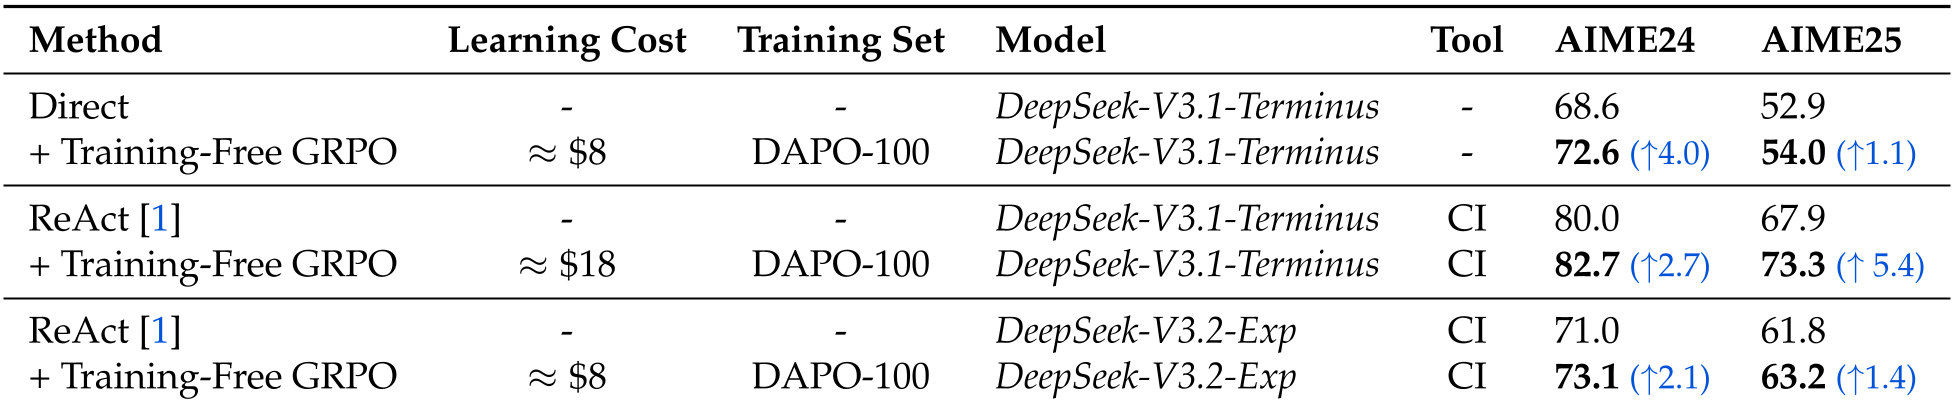 表 1:DeepSeek-V3.1-Terminus 在 AIME 上的表现提升
- 性能提升:在 AIME25 上,Pass@1 提升了 5.4%。
- 降本增效:传统微调 32B 模型需要约 18 的 API 调用费。
- 泛化性:当把数学微调的模型去跑 Web 搜索任务时,性能会雪崩;而 Training-Free 方法由于参数未变,只需更换经验包,即可在多领域保持 SOTA。
深度洞察:为什么这很重要?
这篇文章最令学术界兴奋的一点在于:它挑战了“深度对齐必须更新参数”的迷思。
在推理侧能力(Reasoning Capability)日益增强的今天(如 DeepSeek-R1 系列),模型不再需要通过梯度下降来“学会”逻辑,它们只需要被“提醒”逻辑。Training-Free GRPO 实际上是构建了一个动态进化的 Agent 记忆体。
局限性与未来
当然,该方法也有其边界:
- 基础模型门槛:实验显示在较弱的模型(如 QwQ-32B)上效果不佳,说明模型必须先具备基本的自我内省(Introspection)能力。
- Context 窗口限制:随着经验库的增加,Prompt 会变长,增加了推理延迟。
总结: Training-Free GRPO 为企业级大模型落地提供了一个新思路——如果你买不起显卡去训练 671B 模型,那就请一个“好教练”多给它总结总结经验吧。