
Transformer FFN 层深度解码:被低估的参数仓库与键值记忆系统
Transformer Feed-Forward Layers Are Key-Value Memories
本文揭示了 Transformer 架构中 Feed-Forward (FFN) 层的功能本质,即其充当了“键值记忆”(Key-Value Memories)网络。研究表明,FFN 的第一层参数(Keys)负责检测输入文本中的特定模式,而第二层参数(Values)则存储了对应这些模式的输出词表分布。
TL;DR
如果把 Transformer 比作一台精密引擎,那么 Self-Attention 是负责连接上下文的传动系统,而 Feed-Forward (FFN) 层则是存储海量知识的仓库。本文通过实证研究证明:FFN 层本质上是键值存储记忆(Key-Value Memories)。其中,Keys 捕捉输入中的特定模式(Pattern),Values 则给出对下一个词的预测建议。
1. 它是如何充当记忆系统的?
从数学形式上看,FFN 层的计算公式为:。 这与神经记忆网络(Neural Memory Networks)几乎完全一致。
- Keys (): 第一层线性变换。它的每一行向量都是一个模式检测器。当输入 与某个 Key 向量高度相似时,对应的神经元会被激活(产生较大的系数)。
- Values (): 第二层线性变换。它存储了与每个模式相对应的响应。
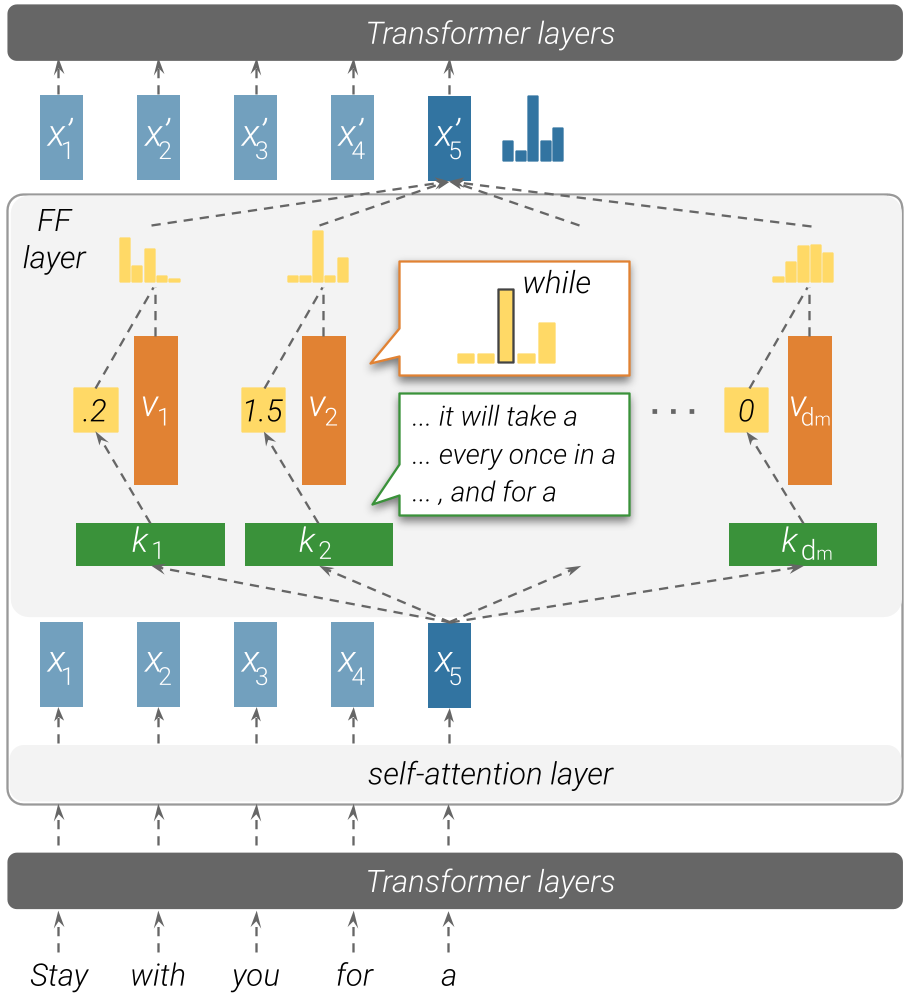 图 1:FFN 层模拟键值记忆系统的示意图。Keys 产生系数,Values 进行加权求和。
2. Keys 捕捉了什么:从词汇到语义
作者通过“触发样本回溯”法,观察哪些文本最能激发某个特定 Key 向量。
- 底层(Lower Layers): 捕捉的是“浅层模式(Shallow patterns)”,例如总是以单词 "substitutes" 结尾的片段。
- 高层(Upper Layers): 捕捉的是“语义模式(Semantic patterns)”,例如关于“军事基地”或者“电视节目”的话题,即使文字表达各异。
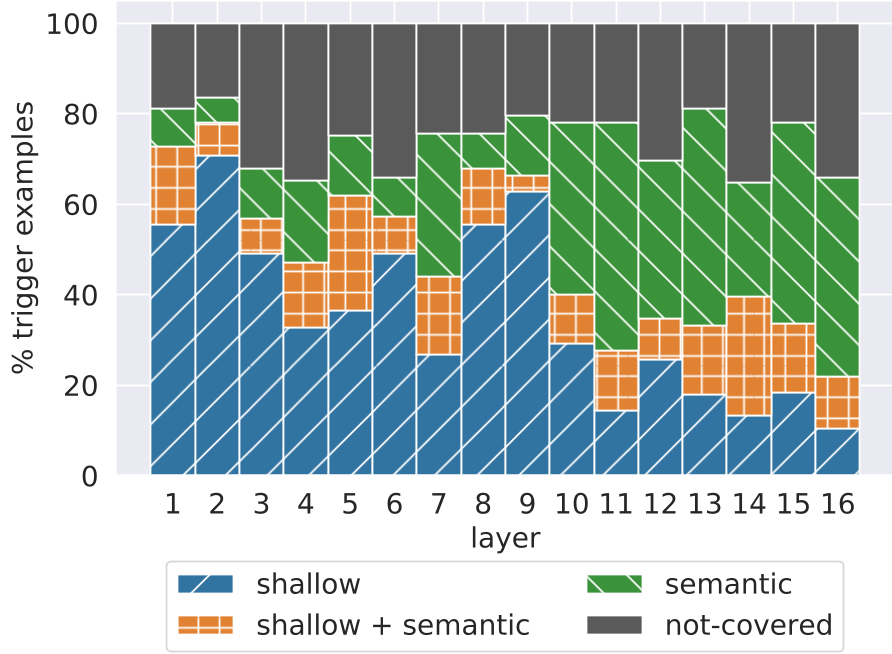 图 2:不同层中浅层模式与语义模式权重的消长趋势。
3. Values 存储了什么:对下一词的“直觉”预测
论文最惊人的发现在于,将 Value 向量投影到词表空间后,它竟然展现出了清晰的预测性。 特别是在高层网络中,当某个 Key 被激活时,对应的 Value 向量往往在潜在预测词(Next-token)上分配了极高的概率波动。这意味着,FFN 直接参与了对下一个词的概率分配。
4. 记忆是如何聚合的?(Composition & Refinement)
模型并不是靠某一个 FFN 单元就完成预测的。
- 层内组合(Intra-layer): 每一层通常有数百个记忆单元被同时激活。实验显示,在超过 68% 的情况下,单层 FFN 输出的最高概率词并不等于其中任何一个 Value 的最高词。这说明模型在进行复杂的信息插值。
- 残差微调(Inter-layer): 残差连接就像是一个不断进化的草稿。FFN 层通过加法操作,对当前的预测分布进行微弱但关键的修正(Refinement),直到最后一层产生最终结果。
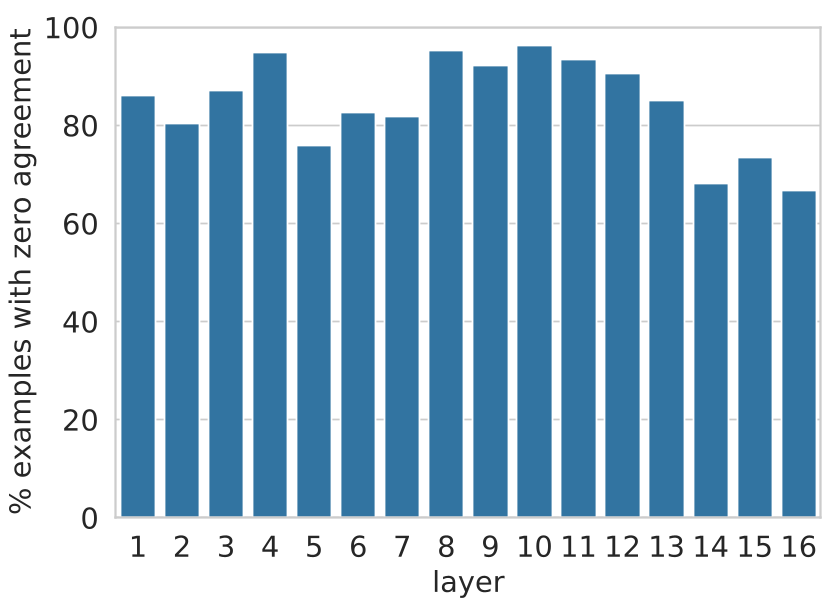 图 3:层内预测组合的复杂性验证。
5. 深度洞察
- 参数效率问题: 既然 FFN 占据了 2/3 的参数,且大部分是以“记忆”形式存在,那么是否可以通过检索增强(RAG)或更高效的稀疏激活(MoE)来替代这些冗余的线性层?
- 知识编辑的可能性: 本文为“定位并修改模型中的知识”提供了理论支撑。如果我们知道哪个 Key-Value 对代表了过时的错误事实,精准修改 Value 向量的权重可能比全量微调更有效。
总结
FFN 层不再是黑盒中的无名氏。它是 Transformer 的“百科全书”,记录了训练语料中的规律与常识。理解了 FFN 的记忆本质,就拿到了通往大模型底层知识表征的钥匙。