
CAD:让大模型“听劝”,通过动态对解除幻觉与知识冲突
Trusting Your Evidence: Hallucinate Less with Context-aware Decoding
本文提出了 Context-aware Decoding (CAD) 方法,一种无需额外训练的推理阶段解码策略。该方法通过对比有无上下文时的输出分布,显著提升了 Llama, OPT 等主流语言模型在摘要生成任务中的忠实度,并在处理知识冲突(Knowledge Conflict)任务上展现出极强的鲁棒性。
TL;DR
即使提供了准确的参考文档,大语言模型(LMs)有时还是会“一本正经地胡说八道”。华盛顿大学与 Meta AI 的研究者提出了一种名为 Context-aware Decoding (CAD) 的新技术。无需微调,仅需在推理时对输出分布进行一次“简单的减法”,就能让 Llama, GPT-Neo 等模型在摘要任务中减少 14% 以上的幻觉,并在知识冲突任务中实现近 3 倍的性能飞跃。
背景定位
在学术坐标系中,CAD 属于推理阶段干预(Inference-time Intervention)。它不属于对模型架构的修改,也不涉及数据微调,而是通过优化解码策略来解决模型过度依赖先验知识(Parametric Knowledge)而忽略上下文(Contextual Knowledge)的顽疾。
痛点深挖:为什么模型“不听劝”?
大模型在预训练阶段背诵了海量事实。当你问“梅西现在在哪个俱乐部?”
- 模型先验:根据训练数据,它可能认为是“巴塞罗那”。
- 当前上下文:你提供的文档写着“迈阿密国际”。
由于预训练产生的 Inductive Bias 非常强大,模型在生成时,其内部由权重驱动的概率分布往往会掩盖掉上下文带来的微弱信号。这种现象在处理过时信息(如 2022 年世界杯结果)或特定领域的引用时尤为突出。
方法论详解:Context-aware Decoding (CAD)
CAD 的直觉非常物理:“放大那些因为有了上下文才变得合理的信号”。
核心公式解析
作者借鉴了信息学中的 PMI(逐点互信息)思想,将解码目标修改为:
- :在有参考文档的情况下的原始输出。
- :假装没看见参考文档,仅凭直觉(先验)产生的输出。
- 减法操作:通过减去无上下文的情况,抵消了模型自带的偏见。
- (强化因子):控制调整的力度。通常 能在大多数任务中取得 SOTA 效果。
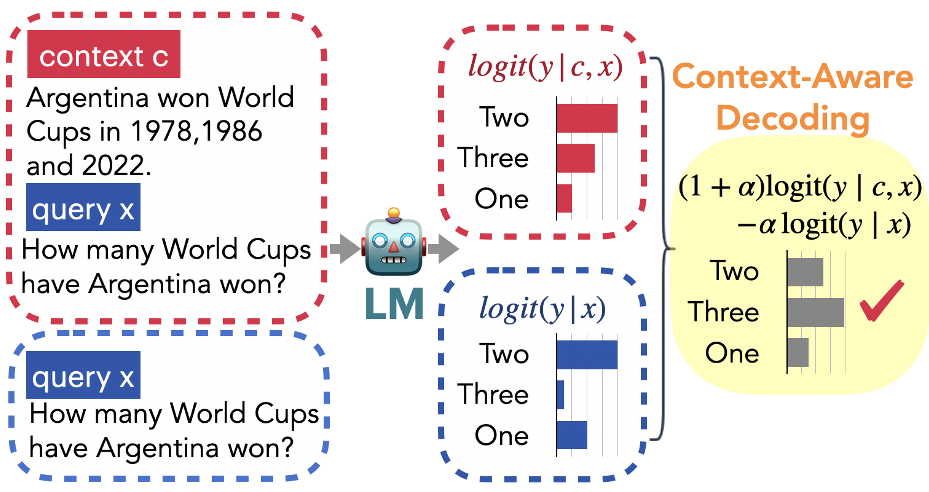 图 1:CAD 示意图。可以看到,当上下文纠正了阿根廷夺冠次数时,CAD 压制了错误的先验“Two”,突出了正确的“Three”。
实验与结果:大模型规模越大,CAD 越有用
1. 摘要任务(Summarization)
在 CNN-DM 和 XSUM 数据集上,CAD 展现了惊人的普适性。无论是自回归模型(OPT, Llama)还是经过指令微调的模型(FLAN-T5),在 ROUGE 评分和事实性指标(FactKB)上均有稳步提升。
2. 知识冲突(Knowledge Conflicts)
在 NQ-Swap 任务中(故意修改事实以测试模型是否盲从经验),CAD 的表现堪称统领级。以 GPT-Neo 20B 为例,其性能从 16.1 飙升至 36.8。
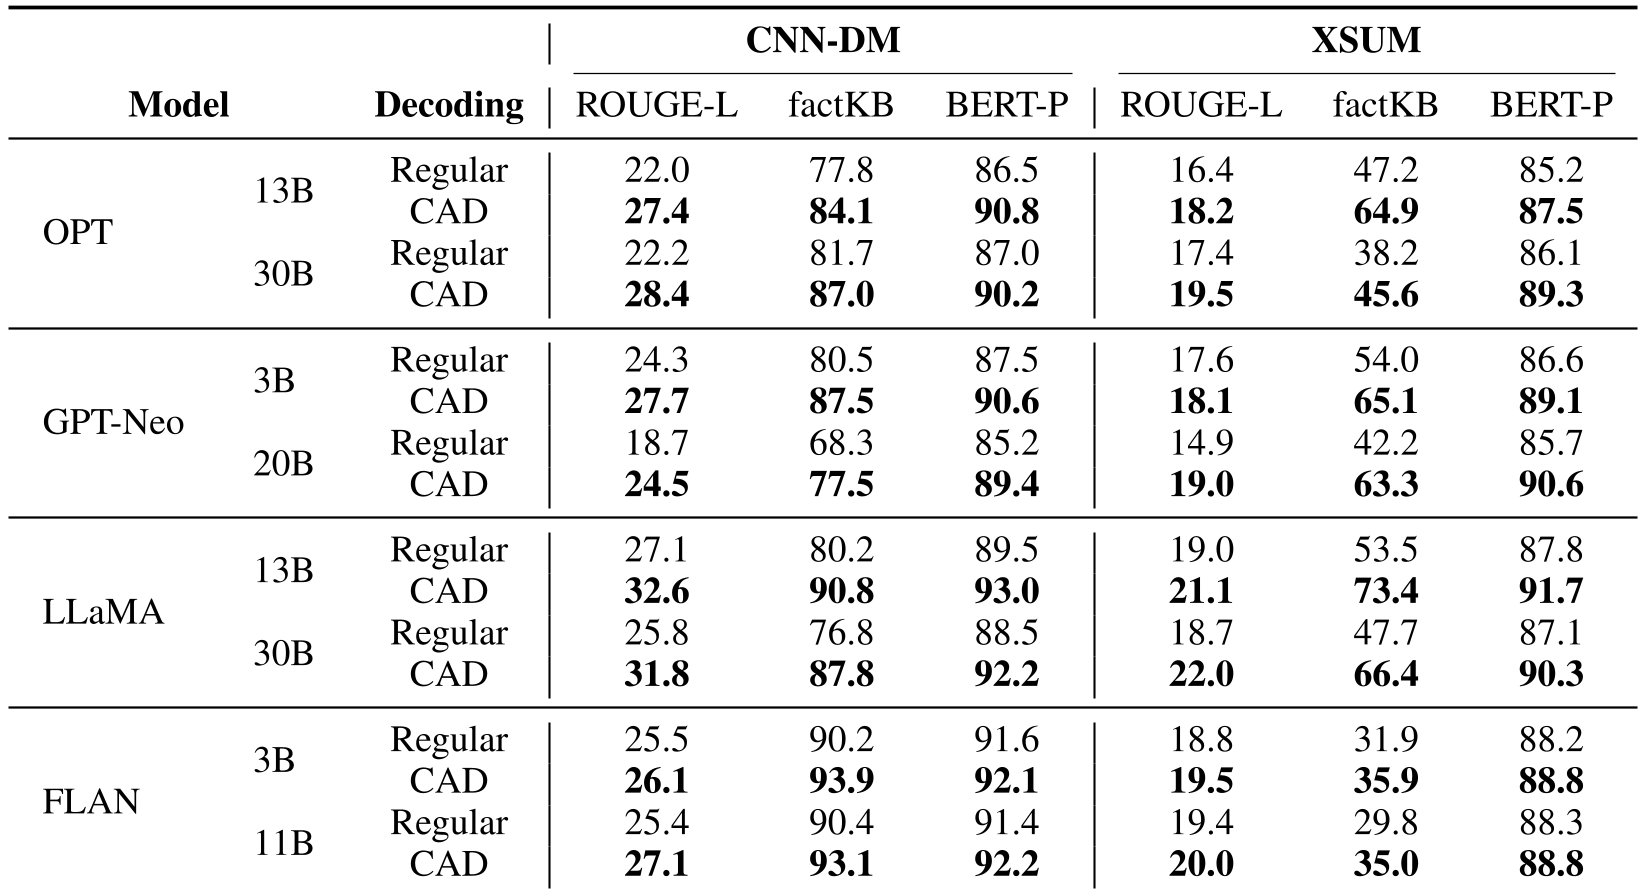 表 1:各系列模型在 CAD 加持下的表现对比。
3. 深层发现:规模法则
研究发现,随着模型参数量的增大(如从 OPT-125M 到 OPT-30B),模型对先验知识的执念会变得更深(容易掉入 Memory Trap)。这也意味着,CAD 在更大的模型上反而能发挥更显著的作用。
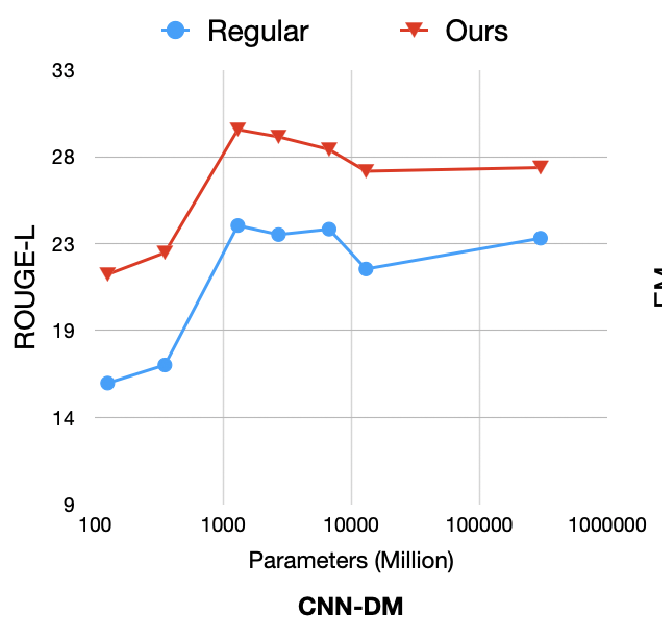 图 2:OPT 模型规模与性能关系。随着模型变大,CAD 带来的性能鸿沟(Gap)在部分任务中持续扩大。
深度洞察与总结
核心价值 (Takeaway)
CAD 提供了一种极其廉价且强大的工具,可以无缝集成到任何现有的 RAG(检索增强生成)工作流中。它不需要昂贵的 RLHF 或对比学习微调,纯粹通过数学上的“差分”就解决了知识竞争问题。
局限性分析 (Limitations)
- 算力开销:由于每步需要计算两次前向传播(一次带 context,一次不带),推理延迟会增加约一倍。
- 黑盒模型限制:CAD 需要访问 Logits(概率分布),因此对于像 GPT-4 这种仅提供文本 API 的完全黑盒模型,目前难以直接应用。
未来展望
CAD 的成功预示着,解码策略的微小调整可能比千亿参数的训练更有效地缓解“幻觉”。未来的研究可能会探索如何动态地调整 值,或者将这种差分解码应用到多模态生成的指令对齐中。