
Tuna-2:直击原始像素,告别视觉编码器的统一多模态新范式
Tuna-2: Pixel Embeddings Beat Vision Encoders for Multimodal Understanding and Generation
本文提出了 Tuna-2,一种原生统一多模态模型(UMM),实现了在像素空间直接进行视觉理解与生成。该作彻底舍弃了预训练视觉编码器(如 CLIP 或 VAE),仅依靠 Patch Embedding 将原始像素转化为 Token,刷新了 7B 参数规模 UMM 在多项基准测试中的 SOTA 记录。
TL;DR
多模态AI领域长期存在一个“潜规则”:图像必须通过 CLIP 加密后再由大模型理解,或者通过 VAE 压缩后再生成。Tuna-2 彻底打破了这一框架。 它通过一个单体 Transformer 模型,直接在像素空间(Pixel-space)完成理解与生成任务。实验证明,这种“大道至简”的无编码器架构在处理精细感知任务时远超传统模型。
背景定位:从“模块化堆砌”到“原生单体”
在早期设计中,理解(Understanding)和生成(Generation)是两个互不相通的模块(如 LLaVA + Stable Diffusion)。后来的原生统一模型(UMM)虽然尝试共享参数,但依然高度依赖预训练的感知编码器(Vision Encoder)。Tuna-2 的出现标志着 UMM 进化到了第三阶段:完全移除外部编码器,直接以原生像素块(Patch Embedding)作为多模态的共同语言。
痛点深挖:预训练编码器的“偏见”
作者指出,现有的视觉编码器带来了两大弊端:
- 归纳偏置限制 (Inductive Bias):预训练编码器(如 CLIP)通常固定了输入分辨率,且在预训练时丢失了大量低级视觉细节(Low-level Details)。
- 表征失配 (Misalignment):使用 VAE 的潜空间进行生成,使用 CLIP 的语义空间进行理解,两者在端到端优化时难以达到完美的物理统一。
核心方法:Tuna-2 的设计哲学
1. 简化的无编码器架构
Tuna-2 将图像划分为 16x16 的 Patch,通过线性层直接映射为视觉 Token。该架构移除了 VAE 和 Representation Encoder,使得模型能够直接触达原始像素。
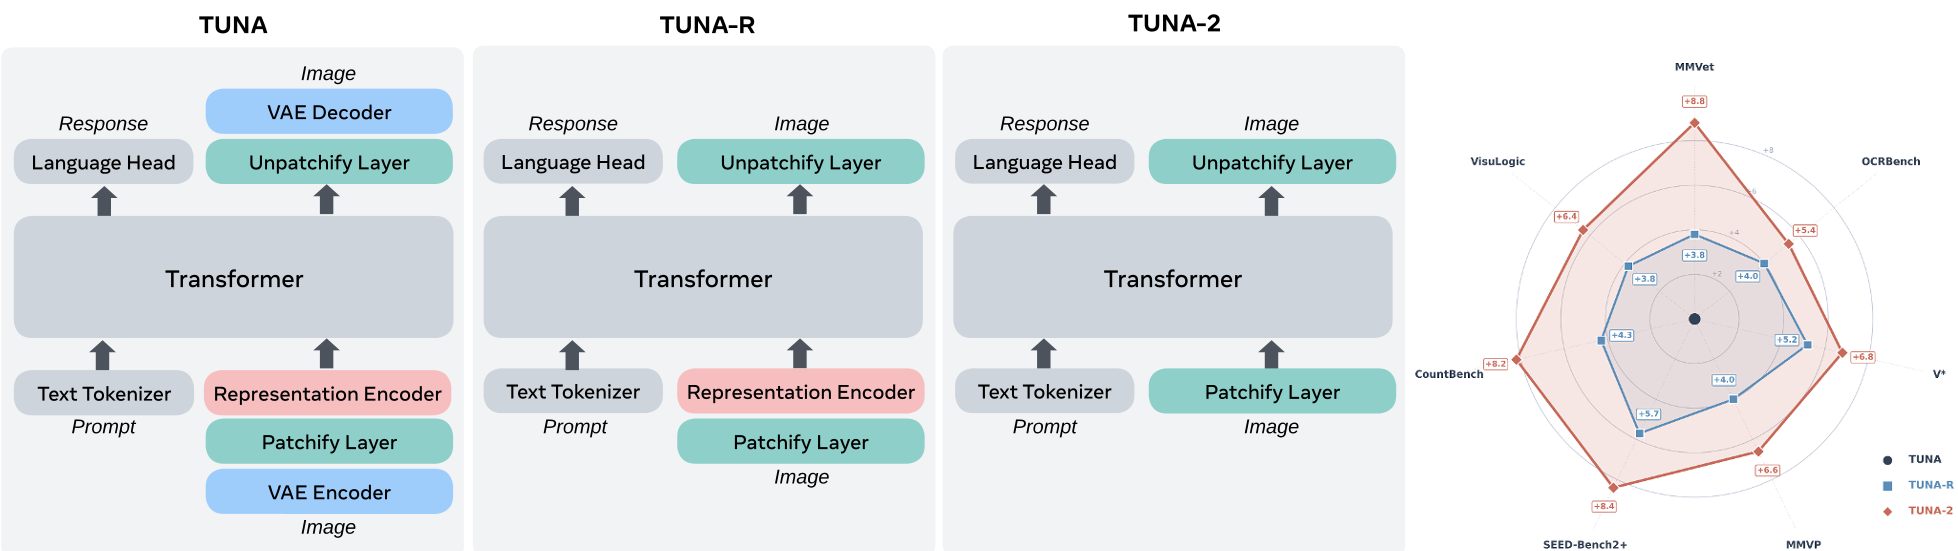 图1:从 Tuna(包含 VAE/Encoder)到 Tuna-2(纯 Patch Embedding)的架构简化过程。
2. 掩码视觉特征学习 (Masked Feature Learning)
由于像素空间维度极高且冗余,直接学习极易陷入局部最优。作者引入了类似于 MAE 的掩码策略:
- 对于理解任务:遮掩部分 Patch 强迫模型根据残缺信息进行多模态推理。
- 对于生成任务:在噪声预测中加入掩码,让模型通过周围上下文预测丢失的像素区域。
3. 像素空间流匹配 (Pixel-space Flow Matching)
模型采用了 Rectified Flow 技术。不同于在压缩特征上做扩散,Tuna-2 直接在 512x512 的像素矩阵上进行去噪,通过 -prediction 和 -loss 范式,实现了高保真度的图像合成。
实验战绩:精细感知的胜利
视觉理解:像素级细节的降维打击
在需要观察极小物体或精细计数(如 CountBench, V* Bench)的任务中,Tuna-2 显著超越了基于潜空间的模型。这证明了移除 VAE 的压缩步骤,保留了更多的“细粒度真相”。
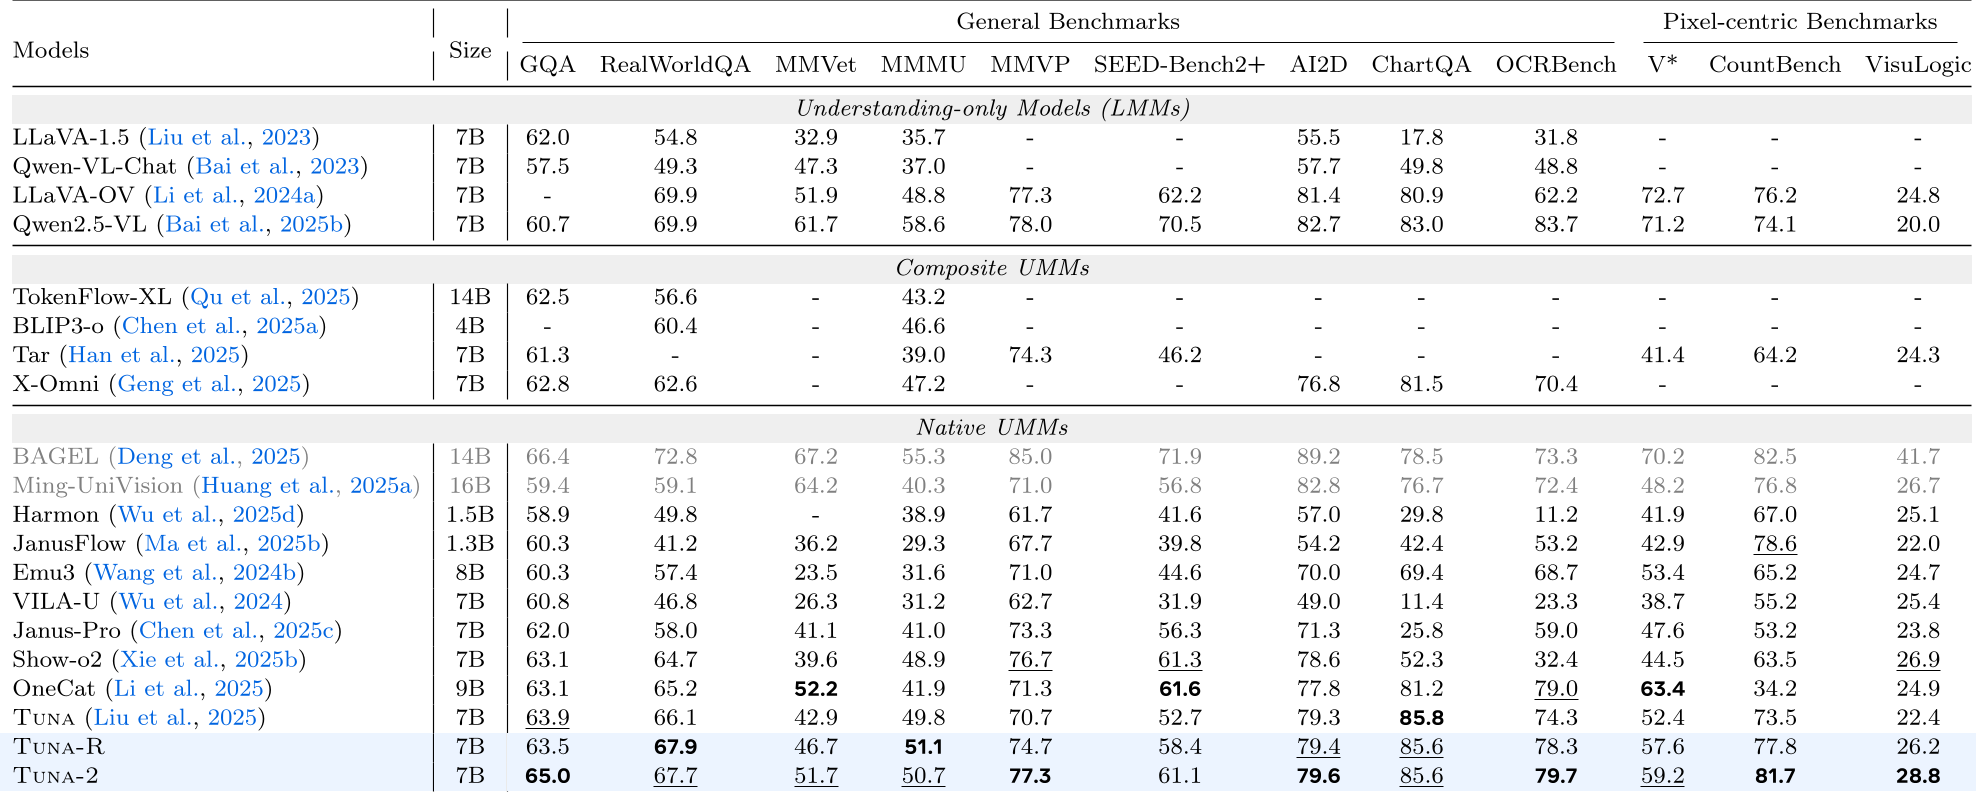 表1:Tuna-2 在各大多模态理解基准上的表现,尤其在 Pixel-centric(像素中心)任务上优势巨大。
视觉生成:高质量与多样性兼得
尽管是在高维像素空间生成,Tuna-2 的效果依然令人惊艳。使用 GPT-5.4 作为评估者(LLM-judge),Tuna-2 在图像多样性上不仅击败了前作,甚至与专用的图像生成模型 FLUX.1 表现相当。
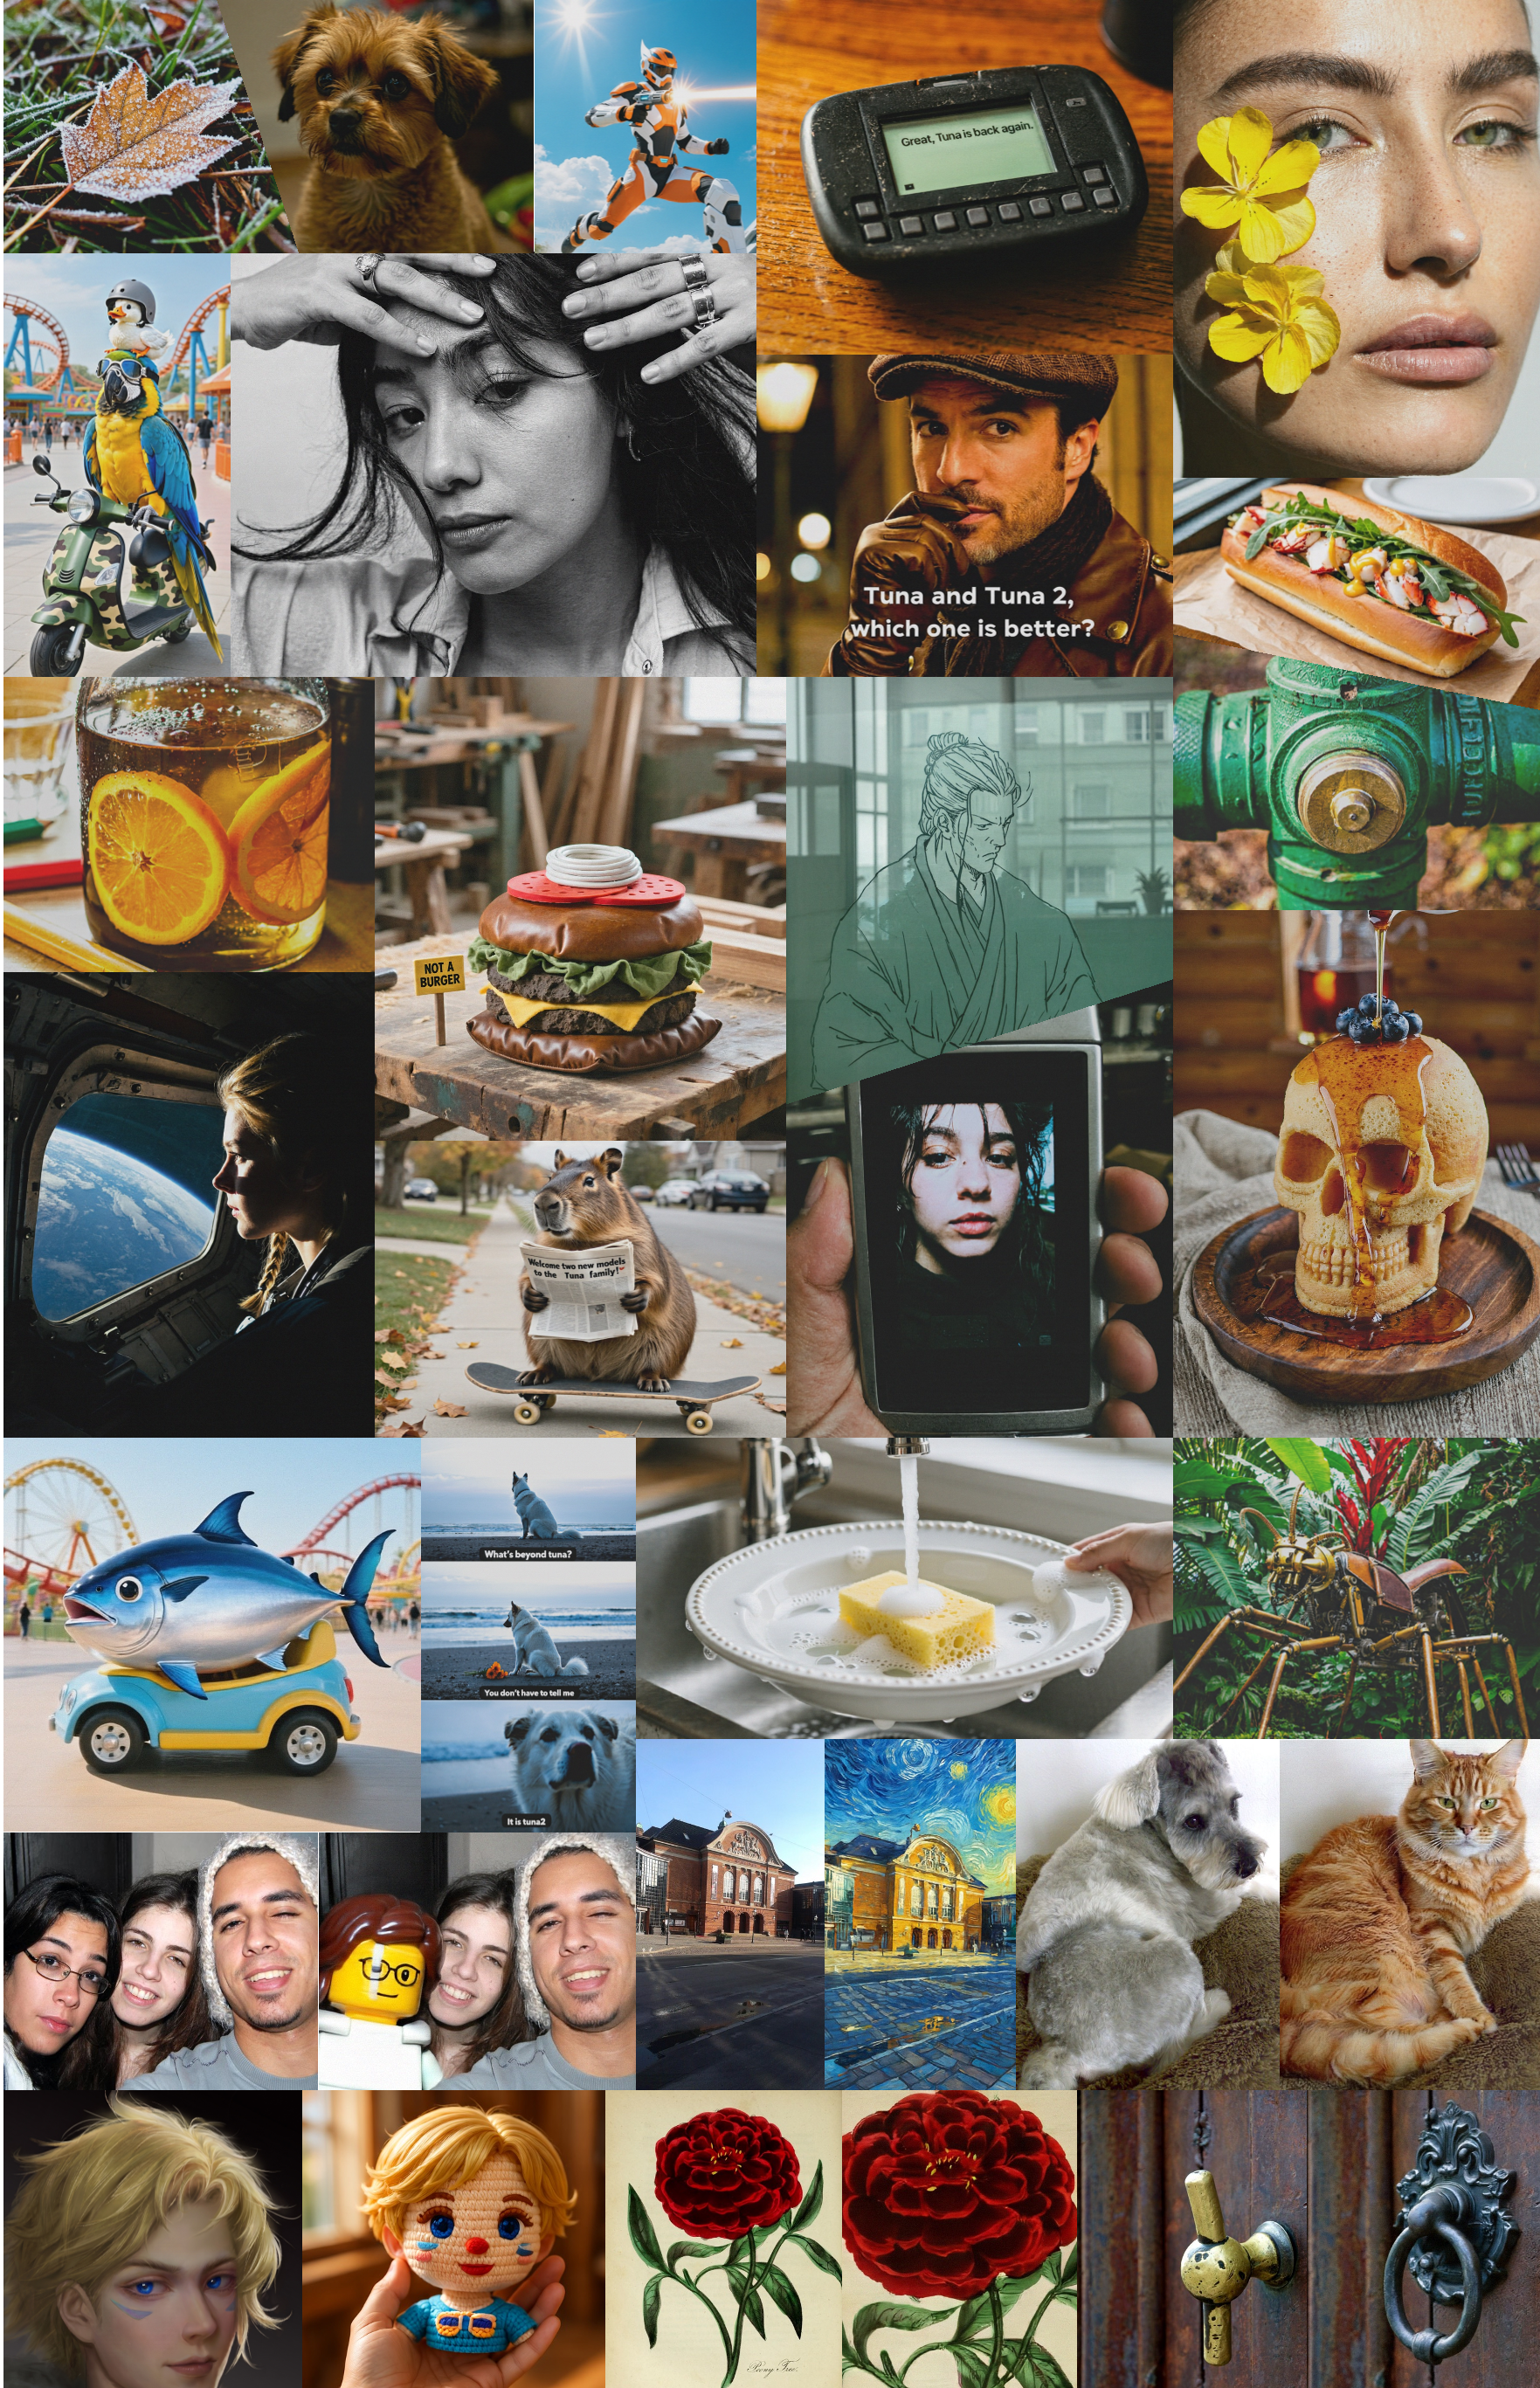 图2:Tuna-2 生成的高分辨率图像示例,展现了极强的文本对齐和细节质感。
深度洞察:Tuna-R 与 Tuna-2 的“赛跑”
论文中有一个极具启发性的实验:对比了带编码器的中间体 Tuna-R 和无编码器的 Tuna-2。
- 早期阶段:Tuna-R 凭借预训练编码器的“先天知识”跑得更快。
- 规模化后:随着数据量的增加,Tuna-2 逐渐反超。这说明无编码器架构具有更强的扩展天花板,它能从海量数据中自发学到更精准的跨模态对齐。
总结与局限
Tuna-2 用实验事实宣告:预训练视觉编码器并非理解世界的“必要中介”。
虽然该模型在理解上达到了 SOTA,但在极其复杂的图像编辑任务中,相比带有视觉先验的编码器模型仍存在微小差距。 这暗示了虽然端到端学习天花板更高,但完全摆脱“外部知识”可能需要更庞大的预训练规模或更精巧的初始化策略。
未来的统一多模态模型,或许真的将是一个从像素到文本、再回到像素的纯粹 Transformer。