
CLIP-UIE:当扩散模型相遇 CLIP,水下视觉增强突破“参考域”局限
UIECLIP24v2
本文提出了 CLIP-UIE,一种利用扩散模型(Diffusion Model)和定制化 CLIP 分类器(CLIP-Classifier)进行水下图像增强(UIE)的框架。该方法通过颜色迁移技术构建大规模合成数据集进行预训练,并结合 CLIP 引导的微调策略,实现了超越传统参考图像域的长效增强效果。
TL;DR
在水下视觉领域,获取“清晰原图”几乎是天方夜谭。传统的深度学习方法被迫在“并不完美”的手选参考图上挣扎。CLIP-UIE 换了个思路:它先教扩散模型(Diffusion Model)识别什么是“自然的陆地图像”,再利用定制的 CLIP 分类器引导模型把浑浊的水下图像向“自然图像”转变。这不仅让画质更自然,还将微调速度提升了整整 10 倍。
1. 痛点:被禁锢的“参考图像”
目前大多数水下图像增强(UIE)算法都采用有监督学习。然而,由于光线散射和吸收,我们无法同时拍摄同一场景的“浑浊图”和“完美清晰图”。学术界常用的解决方法是:
- 人工合成:用物理公式模拟。
- 主观筛选:让专家在多个增强结果里挑一个最好的作为 Ground-Truth (GT)。
致命伤:在这种“二流”GT 上训练出来的模型,其天花板被死死锁在了这些 GT 的质量范围内,甚至会继承人工挑选的偏见(如过度锐化、色偏不准)。
2. 核心直觉:引入陆地图像的先验
作者的核心 Insight 是:既然没有完美的水下 GT,那我们就借用完美的陆地自然图像先验。
- 大规模颜色迁移预训练:作者使用颜色迁移(Color Transfer)技术处理了 50 万张陆地自然图像(INaturalist 数据集),模拟了真实水下环境的退化。这让模型在正式训练前,就已经见过“万象更新”的各种场景。
- CLIP-Classifier 的“监督”作用:利用 CLIP 强大的视觉-文本对齐能力,训练出一个专门分辨“自然图”与“水准图”的分类器。在微调阶段,即使模型面对的是并不完美的参考图,CLIP 分类器也会通过梯度将其向“自然的陆地风格”拉回。
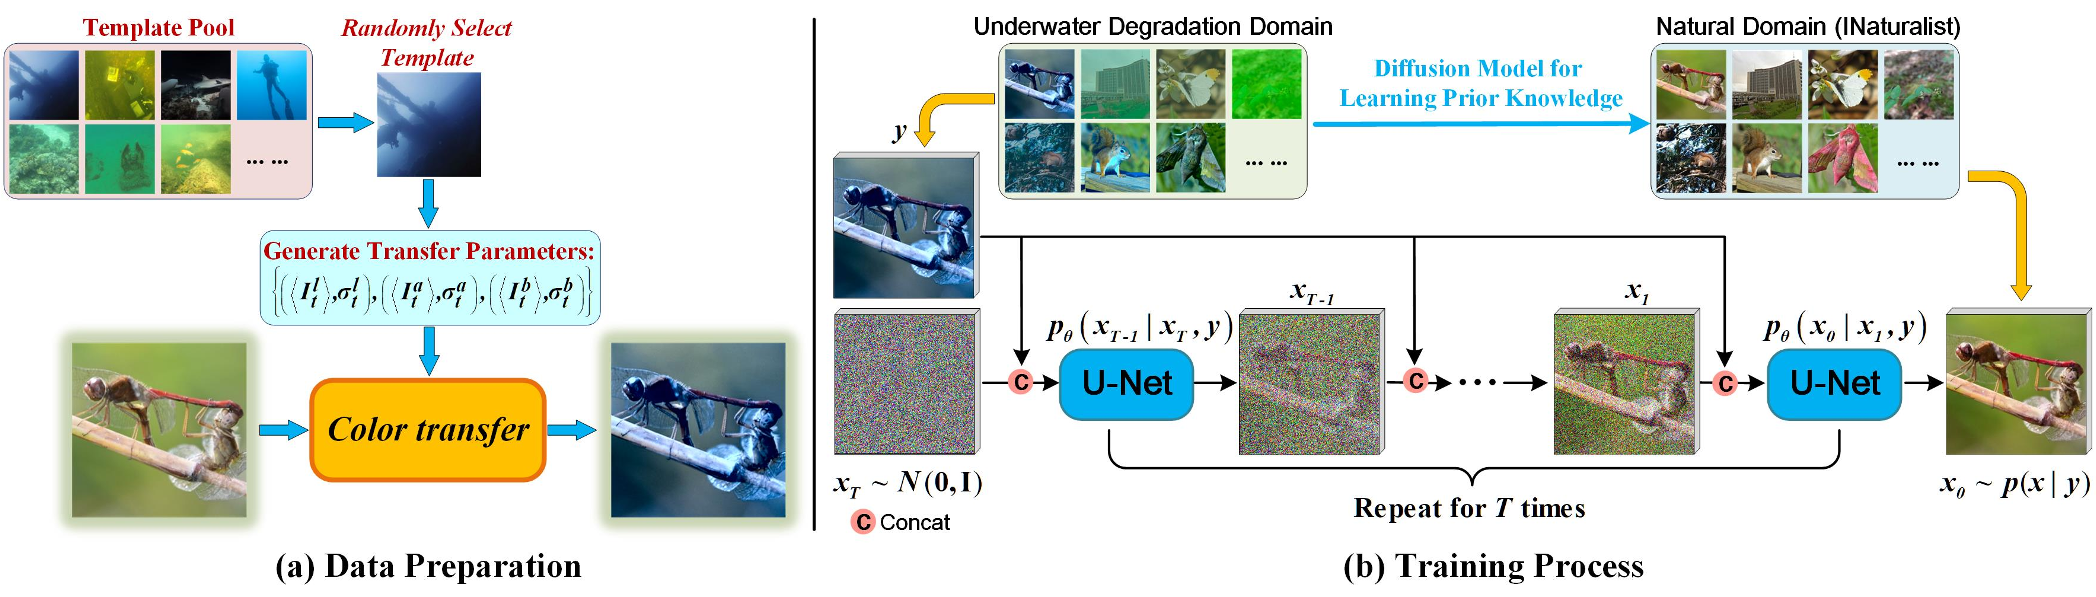 图 1:CLIP-UIE 两阶段训练流程。首先在大规模合成数据集上预训练捕获领域转换先验,随后在 CLIP 引导下进行任务特定微调。
3. 技术突破:为什么能提速 10 倍?
扩散模型的传统微调极度耗时,因为要遍历数千个时间步(Time Steps)。作者在研究中发现了一个重要的现象:图像增强不同于图像生成。
在 UIE 任务中,输入和输出图像共享绝大部分的底层的低频信息(如轮廓、结构)。扩散模型在去噪过程中,前期主要处理低频结构,后期才雕琢高频细节。
新方案:作者提出“劫持”生成过程,仅在 High-frequency Region(高频区域,即时间步 t 较小的阶段)进行微调。实验证明,微调前 10% 的步数就能达到甚至超越全量微调的效果,效率提升 10 倍。
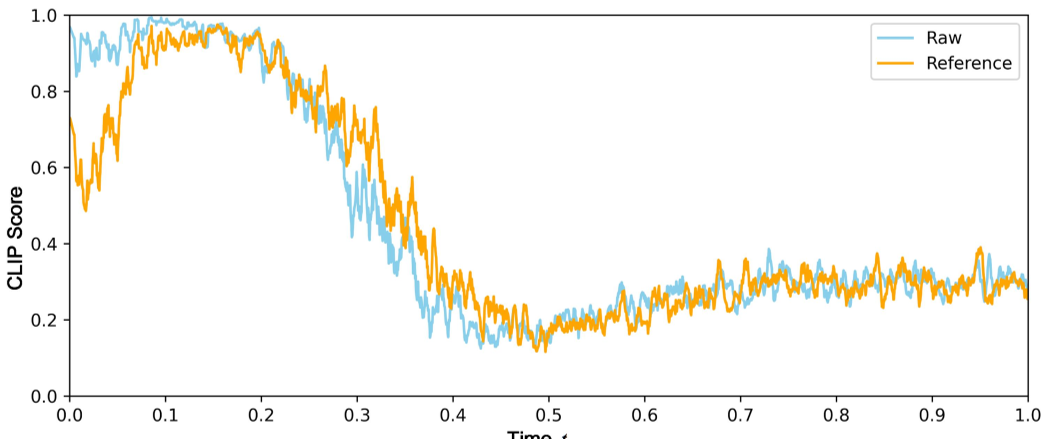 图 2:CLIP 分类器在去噪过程中的响应分析,证实了增强任务中模型主要在离散的高频阶段发挥作用。
4. 实验效果:不仅是更亮,而是更真
通过对比 T200、C60、SQUID 等经典数据集,CLIP-UIE 在 UIQM(水下图像质量测量)和 UCIQE 等关键指标上均达到 SOTA。
观察对比图可见,传统方法(如 UDCP)极易引入红色色偏,而 Ucolor 等深度学习方法受限于参考域,画面往往显得沉闷。CLIP-UIE 增强后的图像色彩饱和度更接近陆地真实样貌,皮肤和背景的质感激增。
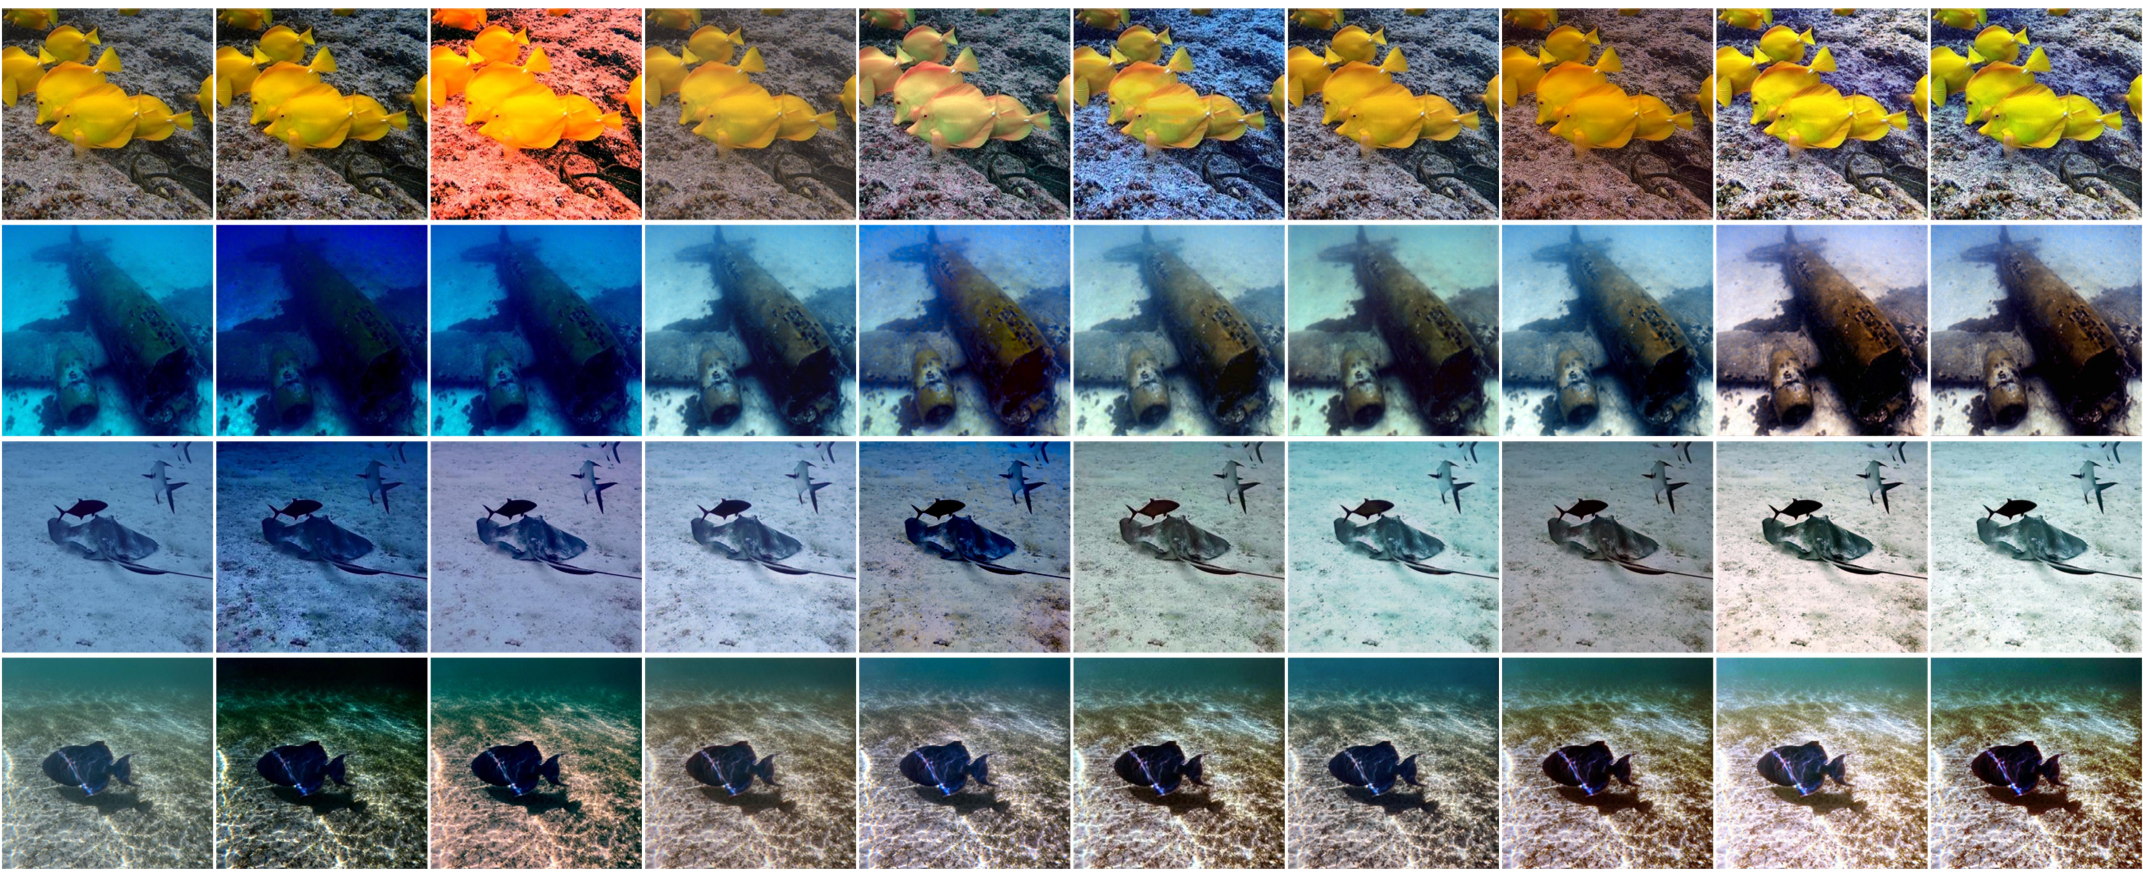 图 3:与 UDAformer、DM_underwater 等 SOTA 方法的视觉对比,CLIP-UIE 具有更自然的色调。
5. 局限性与展望
虽然 CLIP-UIE 表现强悍,但作者也坦诚:
- 颜色微调挑战:在极端的颜色块还原(如 Macbeth 色卡实验)中,CLIP 往往更关注全局语义而忽视了局部小块的绝对色彩精度。
- 速度平衡:目前的极速微调策略仅限于 Image-to-Image 任务,泛化到全生成任务仍需探索。
总结 (Takeaway)
CLIP-UIE 的成功标志着 UIE 任务正从单纯的“图像到图像转换”进化为“跨领域知识迁移”。利用 大规模预训练 + 强大分类器引导 + 频域感知微调,我们可以在数据匮乏的极端环境下,依然获得顶尖的视觉重构能力。对工业界而言,如何利用 CLIP 这种通用大模型来解决垂直领域的“小样板”难题,本文给出了极佳的范式。