
迈向超高码率量子纠错:中性原子阵列的硬件-代码协同革命
Towards Ultra-High-Rate Quantum Error Correction with Reconfigurable Atom Arrays
本文提出了一类硬件协同设计的超高码率(Ultra-High-Rate)量子纠错码,基于仿射置换矩阵(APM)构造,实现了超越 1/2 的编码效率。该研究通过引入特殊的结构约束,使得这些 qLDPC 码能够在地中性原子算筹(Neutral Atom Arrays)上通过高效的原子重排实现,并在 circuit-level 噪声下达到了接近 Teraquop(万亿次逻辑操作)的性能水平。
TL;DR
在量子纠错(QEC)的竞赛中,“编码效率(Rate)”一直是痛点。传统的 Surface Code 昂贵得惊人,物理比特需求量极大。本文通过仿射置换矩阵 (APM) 构造出编码效率 > 1/2 的 qLDPC 码,并利用中性原子阵列的可重构特性,在保持电路级高性能的同时,将资源过载降低了两个数量级。
1. 痛点:为什么我们的纠错效率这么低?
量子计算的“圣杯”是容错(Fault-tolerant)。但实现它的代价是:为了保护极少数的逻辑比特,我们需要成千上万个物理比特。即便是目前的 SOTA 方法,编码效率往往也徘徊在 1/10 以下。
原因有二:
- 拓扑限制:大多数纠错码(如 Surface Code)是局部连接的,限制了能够共享的校验信息量。
- 硬件适配难:虽然 qLDPC 码在数学上很美,但它们往往要求非局部的连接,这在传统的固定布局硬件(如超导)上极难实现。
2. 核心直觉:硬件-代码协同设计
作者的灵感来自于 Kasai 构建的高效率 APM 码。APM 的优势在于它比传统的循环矩阵具有更大的搜索空间,从而能提供更好的码距(Distance)。
为了让这种复杂的数学结构能在 QuEra 这类原子阵列上跑起来,作者提出了一个关键的物理直觉:如果我们要移动原子,那就让移动变得有规律。
轨道通勤设计 (Commuting Orbits)
作者约束了所有的变换操作必须与一个参考 APM 通勤。在物理上,这意味着所有的原子运动可以被分解为:
- 轨道内位移:像传送带一样整排移动。
- 轨道间置换:极小范围的互换。
这种设计避免了在提取校验子(Syndrome Extraction)时产生复杂的“交通堵塞”,使得原本需要 步的移动简化到了常数步。
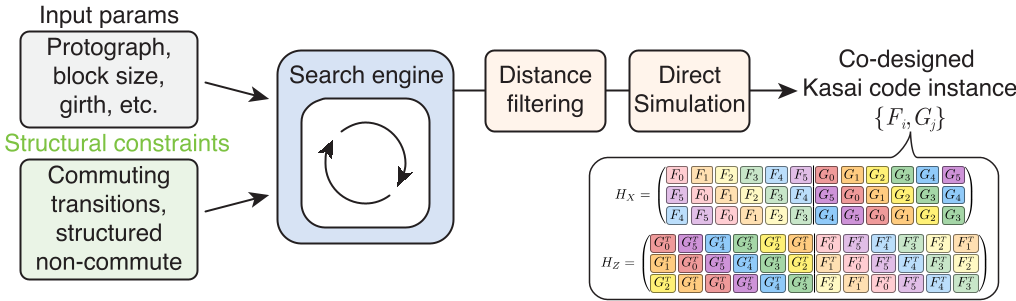 图 1:基于 APM 的代码构造及在原子阵列上的物理映射逻辑。
3. 译码神器:三层分级译码器
高效率码(High-rate)在低噪声区间的逻辑错误率极低,传统的 Monte Carlo 模拟很难探测到。作者开发了一套分级译码 (Hierarchical Decoding) 流程:
- T1 (BP):快速响应,解决 99% 以上的简单错误。
- T2 (Relay-BP):处理 BP 不收敛的顽固分子。
- T3 (Integer Programming):最后的大招,虽然慢,但极其精确。
这种架构不仅加速了研究过程,也为未来硬件上的实时译码提供了蓝图。
4. 实验战绩:迈向 Teraquop
实验结果令人振奋。在 的典型噪声水平下:
- [[1152, 580, ≤ 12]] 码:效率 50.3%,达到了 级别的错误率。
- [[2304, 1156, ≤ 14]] 码:效率 50.2%,错误率低至 。
这意味着我们距离“万亿次逻辑操作(Teraquop)”的目标仅一步之遥。
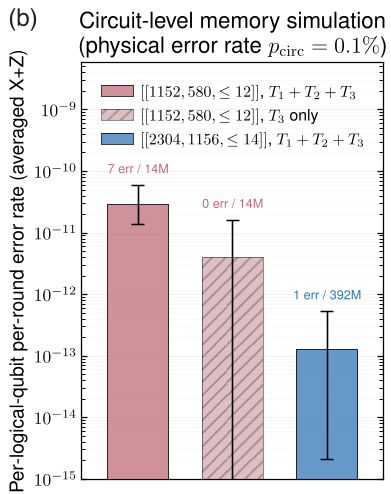 图 2:在不同噪声模型下的逻辑错误率表现。注意到 T3 阶梯式地提升了低噪声区的纠错极限。
5. 局限与展望
尽管表现卓越,本文主要集中在**量子存储(Memory)性能上。如何在这种超高码率下实现低 overhead 的逻辑门操作(如 Magic State Distillation 或 Lattice Surgery)**仍是后续研究的重点。
结论:这项研究标志着量子纠错从“追求可行性”转向了“追求极致效率”。编码效率从 1/10 到 1/2 的跨越,意味着同样的硬件规模,我们可以运行成倍增加的逻辑比特,这种“算法红利”将极大缩短量子优势到来的时间。