
BEAR:破解社交媒体中的“弦外之音”——多模态意图与情感的深度关联建模
Uncertain Multimodal Intention and Emotion Understanding in the Wild
本文提出了 MINE 数据集及 BEAR 框架,旨在解决社交媒体场景下多模态意图与情感识别中的模态缺失(缺失不确定性)及两者内在关联建模问题。BEAR 框架通过 BEIFormer 进行隐式标签推理,并利用 MAP 机制处理异步模态缺失,在多项指标上达到 SOTA。
TL;DR
在复杂的社交媒体环境下,用户的发言往往包含“图、文、声、像”的随机组合,且其表达的情感(Emotion)与意图(Intention)往往交织在一起。武汉大学的研究团队近日发表了 MINE 数据集与 BEAR 框架,通过隐式标签推理(Implicit Label Reasoning)和异步模态提示(MAP),在模态不确定的现实场景中实现了对用户心理状态的精准捕捉。
痛点深挖:实验室外的“混沌”多模态
过去的多模态研究往往基于“完美假设”:即每个样本都拥有完整的图像、音频和文本。但在 Twitter 等社交平台上,情况大不相同:
- 模态缺失的不确定性:有的帖子只有一张图配一句话,有的则是一段没声音的短视频。
- 逻辑关联的缺失:现有的 SOTA 模型通常把“想干什么(意图)”和“心情如何(情感)”拆成两个任务,忽略了“愤怒时往往伴随攻击性意图”这种自然的语义耦合。
- 补全算法的副作用:传统处理缺失模态的方法(如随机采样补全)往往会引入噪声,甚至破坏掉那些本来存在的模态特征(Feature Corruption)。
核心方法:BEAR 框架的平衡艺术
为了应对上述挑战,作者设计了 BEAR (Bridging Emotion-Intention via Implicit Label Reasoning) 框架,其核心由两个模块组成:
1. BEIFormer:跨域关联的“读心术”
BEIFormer 不再死板地进行分类,而是借鉴了 掩码语言模型(Masked LM) 的思想。
- 机制:它在输入 Prompt 中利用
[MASK]遮盖意图和情感标签,强迫模型根据残缺的多模态特征进行“推理填充”。 - 物理直觉:通过对比学习(Contrastive Learning),模型学习到了情感特征空间与意图特征空间之间的隐式映射关系。
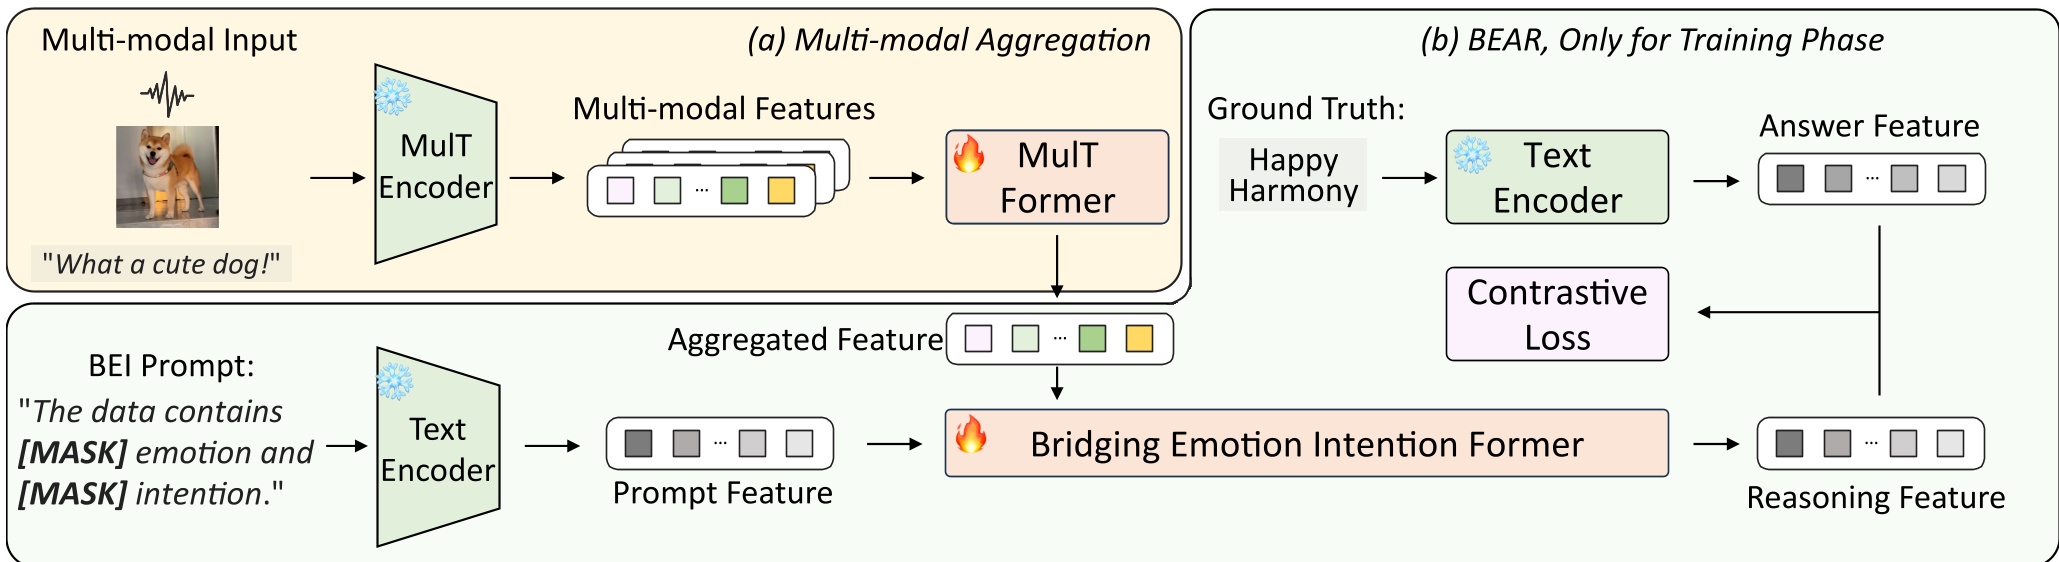 图 1:BEAR 框架总览。展示了从多模态特征聚合到 BEIFormer 进行隐式推理的全过程。
2. MAP (Modality Asynchronous Prompt):异步补全
相比以往将所有模态强行拼接(Concatenation)的做法,MAP 采用了更优雅的“异步”策略:
- 非侵入式补偿:只对缺失的模态生成提示向量,并通过元素级加法将其融入。
- 优势:这保证了那些已经存在的、高质量的模态特征不会被冗余的 Prompt 信息污染,维持了特征的纯净度。
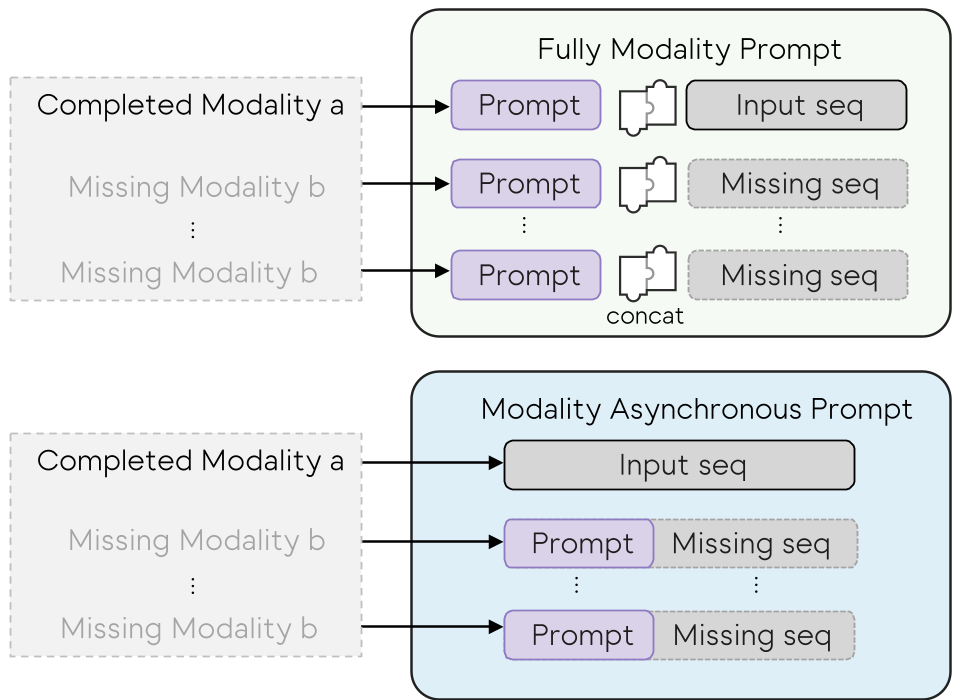 图 2:MAP 策略与传统 MPMM 方法的对比,展示了异步提示如何避免特征损坏。
实验战绩:全线飘红
在包含 20,000+ 原生社交媒体帖子的 MINE 数据集上,BEAR 展现了极强的统治力:
- 意图理解 (Macro F1):提升至 35.79%,相比强基线 MulT 显著领先。
- 情感识别 (Accuracy):达到了 64.53%。
- 鲁棒性验证:在经典的 CMU-MOSEI 数据集上,接入 MAP 插件后,各种骨干网络(如 MFN, BERT_MAG)的性能均有 1%-3% 的稳步提升,证明了该方法的通用性。
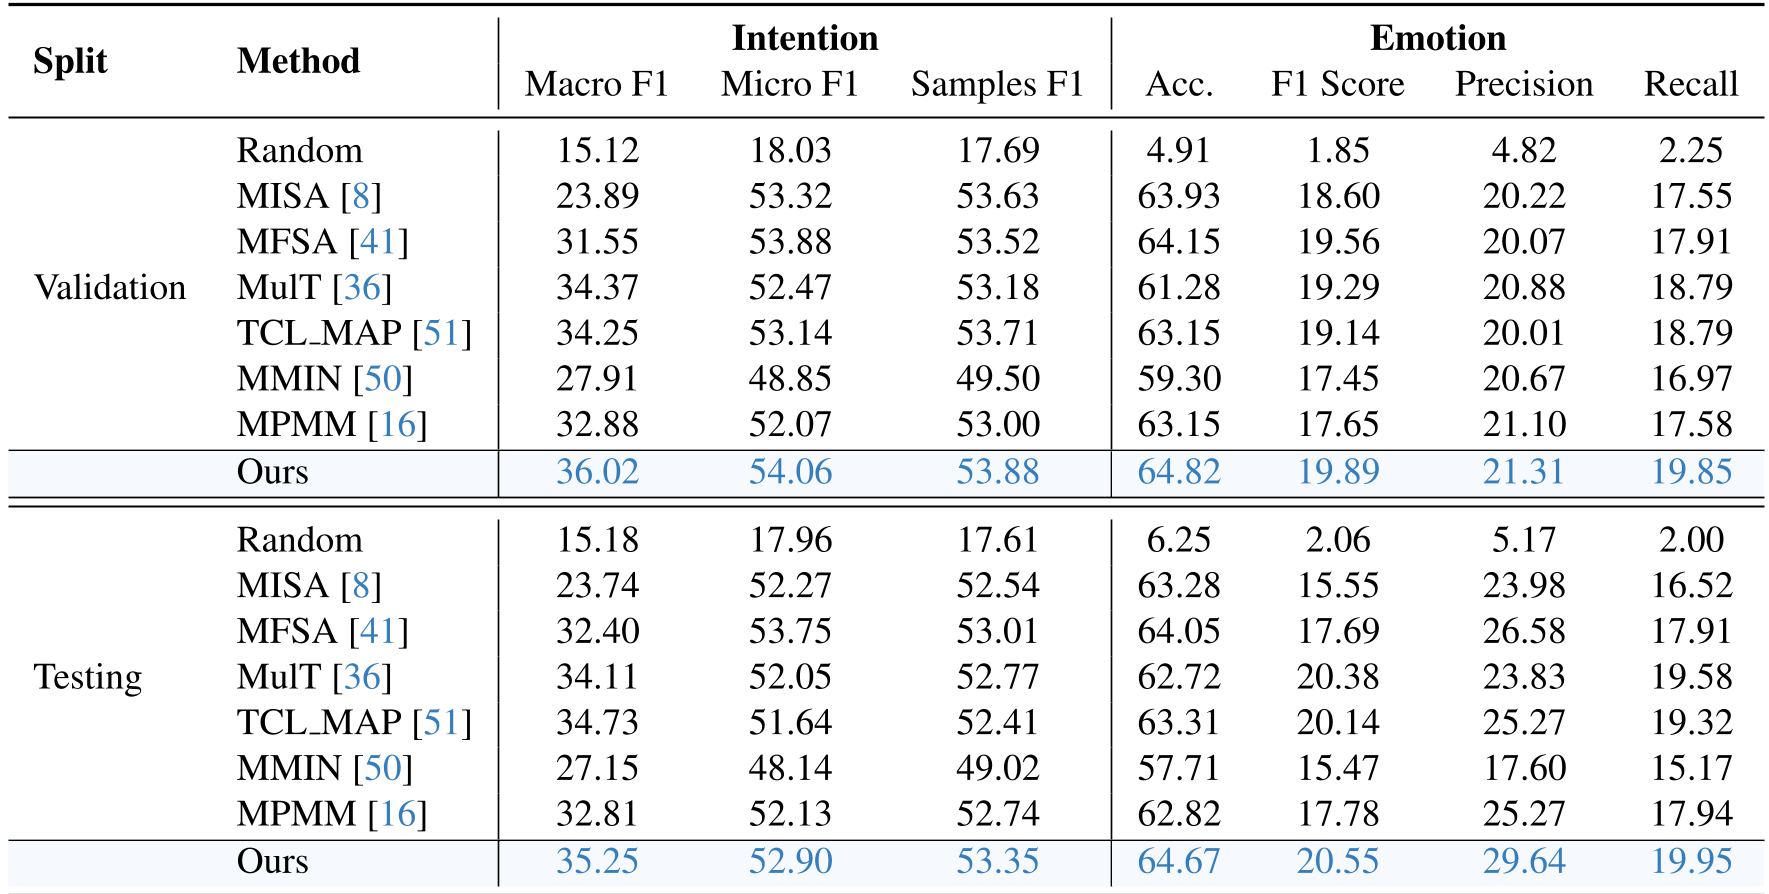 表 1:在各个指标下 BEAR 与其他 SOTA 方法的量化对比。
深度洞察
BEAR 的成功不仅在于架构的精巧,更在于它对 "In the Wild" (野外环境) 数据的尊重。
- 数据分布的真实性:MINE 数据集故意保留了模态不平衡(只有 70% 的数据有视觉内容),这虽然增加了学习难度,但也让模型在处理真实世界垃圾数据时更加从容。
- 隐式推理的力量:通过标签掩码任务,模型实际上在内部构建了一套“心理模型”,使得它在某些模态缺失时,能通过另一种模态和关联知识实现平衡补偿。
结论与展望
MINE 与 BEAR 为多模态情感计算指明了新方向:不要试图去填补所有缺失的数据,而要学会利用各个维度之间的内在关联去“推测”缺失的信息。
局限性:尽管 BEAR 在社交媒体上表现优异,但对于具有极强时序依赖性的长视频意图理解,其计算成本仍有优化空间。未来,这种异步 Prompt 的思想或许能进一步扩展到超大规模多模态大模型(LMMs)的参数高效微调中。