
压缩即智能:从 Kolmogorov 复杂度洞察 LLM 的 Scaling Laws 及其幻觉起源
Understanding LLM Behaviors via Compression: Data Generation, Knowledge Acquisition and Scaling Laws
本文提出了 Syntax-Knowledge 模型,通过 Kolmogorov 结构函数将 LLM 建模为两部分编码过程。该研究通过非参数化的 Pitman-Yor 过程刻画知识的幂律分布,揭示了 LLM 遵循 Scaling Laws 的本质是预测与压缩的内在联系。
核心速览 (Executive Summary)
TL;DR:清华大学等机构的研究者提出,大语言模型(LLM)的本质可以抽象为一种近似的 Kolmogorov 压缩器。通过构建一个名为 Syntax-Knowledge 的层级生成模型,本文从数学上严格推导出了模型性能随数据量(Data Scaling)和参数量(Model Scaling)增长的幂律公式。研究明确指出,LLM 是按照模式频率从高到低“分层”学习的:语法(Syntax)先行,知识(Knowledge)随后。
背景定位:这篇论文在 LLM 可解释性领域占据了重要的理论坐标。它不仅是对 OpenAI 近年来宣扬的“压缩即智能”直觉的数学补完,更是对长尾分布下 幻觉(Hallucinations) 现象给出了极具说服力的“容量局限性”解释。
痛点深挖:为什么 Scaling Laws 总是幂律?
尽管 Scaling Laws 已经深入人心,但我们一直缺乏一个物理直觉:为什么 Loss 的下降偏偏服从幂律?现在的理论模型往往假设数据是均匀分布的,但现实世界的语言(如 Heap's Law 和 Zipf's Law 所描述)是极度长尾和幂律分布的。
作者认为,现有的方法错在没有区分“语言结构”和“事实知识”。语法是普适的(高频),而具体的某条事实知识是稀疏的(长尾)。这种频率上的巨大差异导致了模型在压缩时具有明显的先后顺序。
方法论详解:Syntax-Knowledge 模型与两部分编码
1. 两部分编码 (Two-part Coding) 视角
借助 Kolmogorov Structure Function,我们可以将 LLM 的训练看作是在寻找一个最优的两部分编码:
- 第一部分(模型段):模型的参数 。
- 第二部分(数据段):在给定模型下数据的压缩长度 。
模型越复杂(参数越多),它能捕捉的微小规律(冷门知识)就越多,总压缩率就越高。
2. 层级生成架构
研究者利用 Pitman-Yor 过程 (PYP) 模拟人类知识的增长。这种非参数模型能完美刻画“富者愈富”的特性,即少数事实频繁出现,多数事实极少出现。
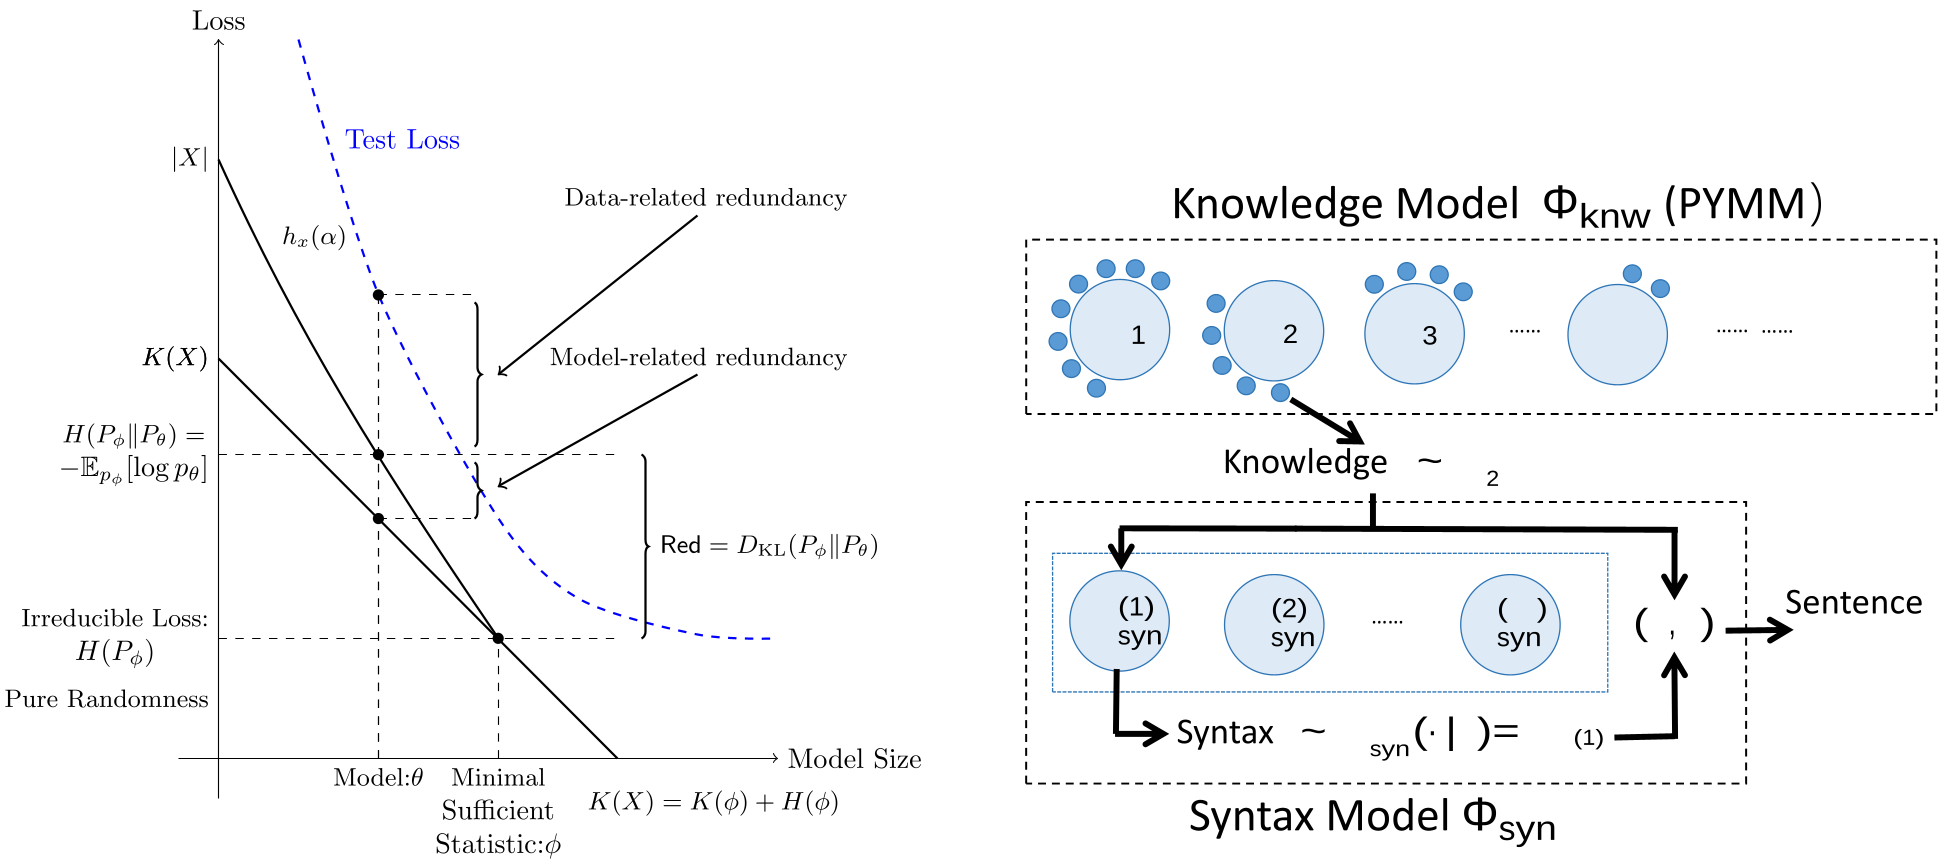 图 1:左图展示了 Kolmogorov 结构函数下的 LLM 演化,右图展示了语法-知识层级生成模型。
实验与结果:频率决定的学习顺序
论文通过对比实验揭示了一个惊人的现象:
- 语法模型学习速度极快(冗余度以 下降)。
- 知识模型学习缓慢(冗余度以 下降)。
模型容量与“幻觉”的必然性
实验证明,当模型容量 受限时,为了实现全局最优压缩,模型会自动舍弃低频事实的精确存储,从而导致幻觉。
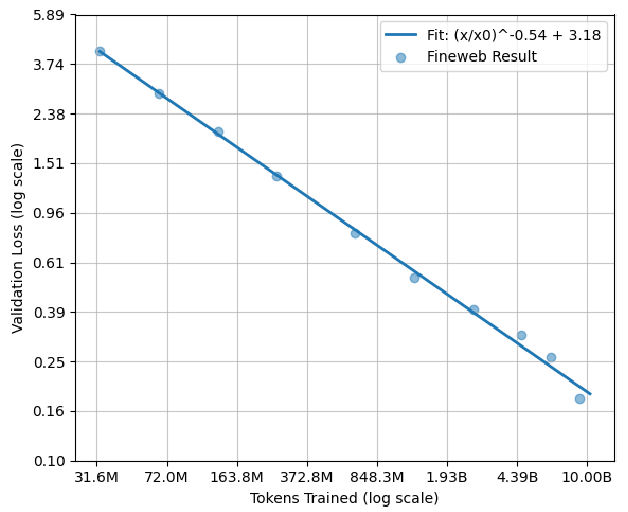 图 2:在 Fineweb-edu 等真实数据上的验证显示,随着模型变大,知识获取的“切点”(Cutoff)不断下移,更罕见的知识开始被掌握。
关键结论:幻觉不完全是训练噪声的结果,而是模型在有限容量下对数据的“损失压缩”。
深度洞察与总结 (Critical Analysis & Conclusion)
这种理论的行业价值:
- 数据混料提示:如果我们想加速新知识的注入,应该人为提高新知识在数据流中的“语法复用度”,而不是单纯堆砌新事实。
- 微调策略建议:微调(SFT)如果引入了过于陌生的语法格式,会迅速挤占有限的知识容量,导致严重的灾难性遗忘。
局限性:
目前的模型主要处理“原子式”的事实知识,尚未完全刻画人类语言中复杂的组合逻辑和多步推理(Reasoning)。
未来展望: 该理论框架为构建“可控容量”的模型提供了底层支撑。未来的模型或许可以根据知识频率动态调整其压缩优先级,从根本上缓解长尾知识带来的虚假输出。