
Unicorn:无需真实图像,纯文本也能练出顶尖视觉语言模型
Unicorn: Text-Only Data Synthesis for Vision Language Model Training
本文提出了 Unicorn,这是一个创新的三阶段纯文本多模态数据合成框架,用于训练视觉语言模型 (VLM)。该方法无需任何真实图像,通过在共享表示空间中将文本 Embedding 转换为视觉兼容的表示,构建了 Unicorn-1.2M 预训练集和 Unicorn-471K 指令微调集,使 Unicorn-8B 模型在多个基准测试中达到了 SOTA 水平。
TL;DR
在 AI 训练数据日益枯竭的今天,这篇来自香港科技大学(广州)的研究完成了一项壮举:彻底抛弃真实图像。通过名为 Unicorn 的框架,作者仅凭纯文本数据就在表示空间(Representation Space)中合成了高质量的视觉监督信号。其实验结果 Unicorn-8B 在多项视觉推理榜单上击败了使用真实图像训练的 LLaVA 等经典模型。
核心洞见:模态间隙的“补丁”哲学
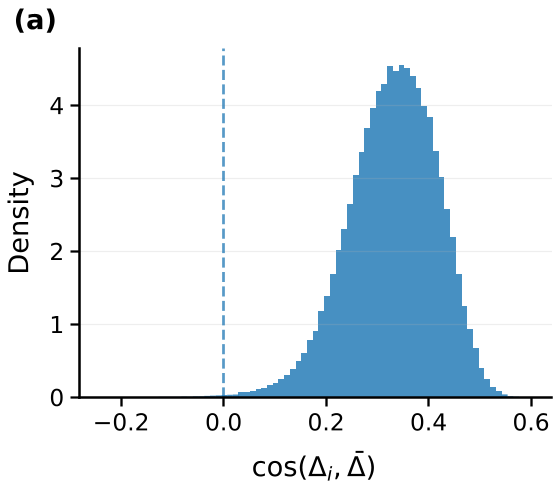
为什么我们不能直接把文本的 Embedding 当作图片的 Embedding?因为存在 Modality Gap。作者通过大规模分析发现,尽管文字和图片的语义相同,它们在共享空间中的分布是错位的。
作者提出了三个关键科学发现(Findings):
- 稳定全局偏置 (Stable Global Bias):这种间隙不是随机的,而是一个稳定的方向。
- 跨语义一致性 (Cross-Semantic Consistency):无论你描述的是“猫”还是“飞机”,这种间隙在方向上高度相似。
- 可迁移性 (Transferability):在已知语义区域学习到的转换规则,可以直接应用到从未见过的语义区域。
Unicorn 框架:合成数据的新范式
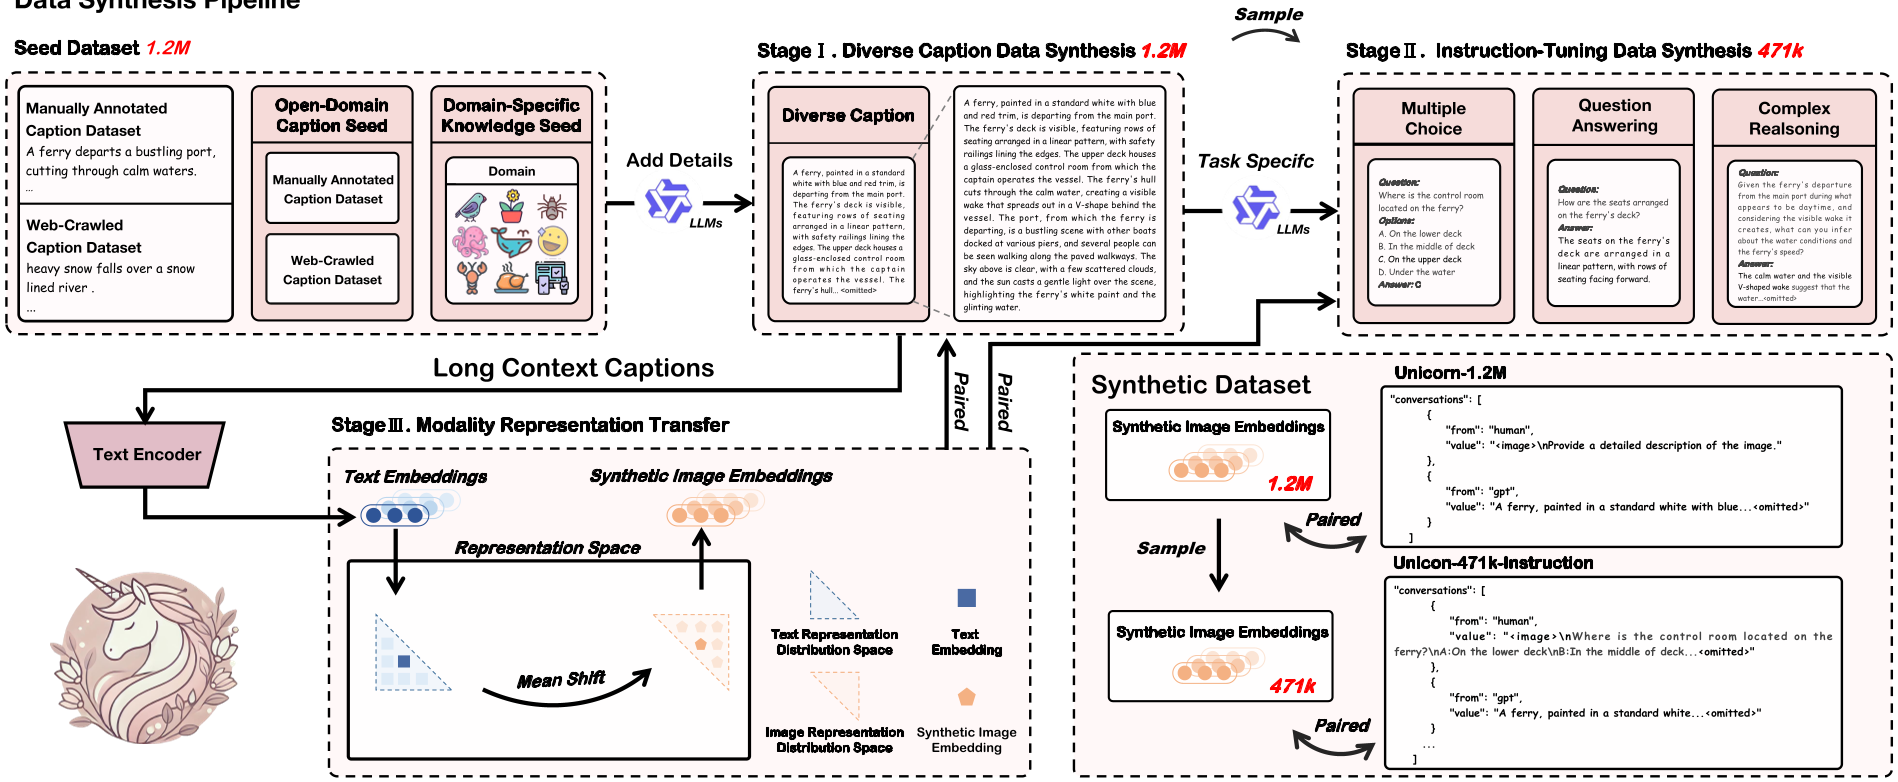
Unicorn 的合成流程分为三个相互补充的阶段,巧妙地绕过了“生成像素”这一昂贵环节。
1. 语义浓缩 (Semantic Densification)
原始文本(如“一只狗”)对于训练 VLM 来说太模糊了。Unicorn 利用 Qwen2.5 等强力 LLM 将其改写为稠密视觉描述,详细交代物体的材质、光影、空间坐标和背景。这大大降低了视觉表示的确定性(Variance Reduction)。
2. 指令数据生成 (Instruction Generation)
基于稠密描述,LLM 进一步生成多选、问答和复杂逻辑推理任务,确保模型不仅能“看到”物体,还能理解其间的逻辑。
3. 表示转换 (Representation Transfer) —— 核心魔法
这是本文的“物理直觉”所在。作者没有使用 GAN 或扩散模型去生成像素,而是直接处理 LLM2CLIP 提取的文本 Embedding。通过减去全局文本均值并进行 归一化,将文本向量“推”向视觉区域,生成合意的视觉代币(Pseudo-visual tokens)。
实验战绩:纯文本训练的逆袭
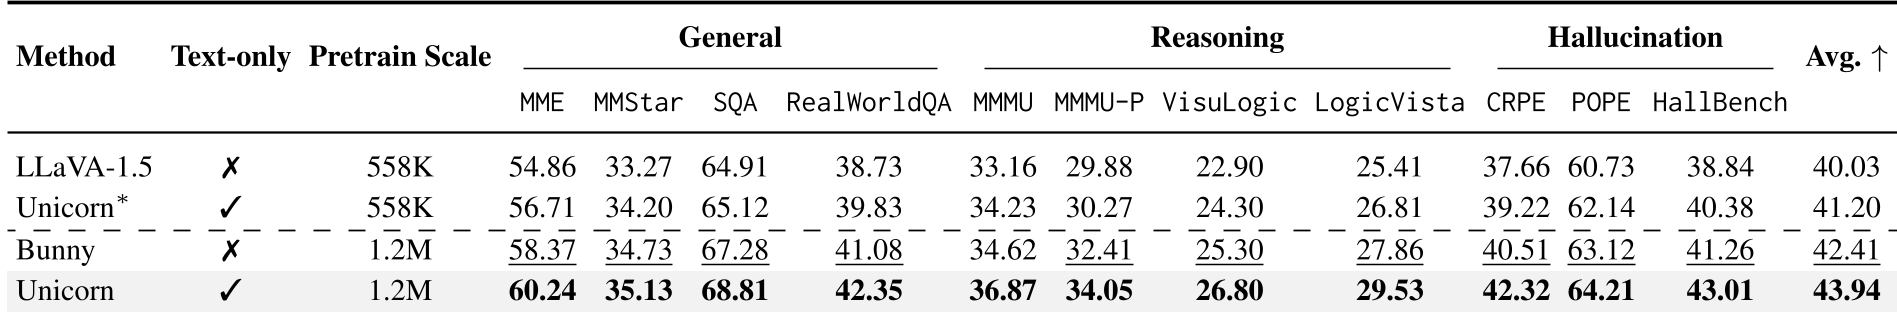
Unicorn-8B 在实验中展现了惊人的生命力。在评估多模态专业知识的 MMMU 和逻辑推理的 LogicVista 上,它的表现优于 Bunny 和 LLaVA-1.5。
| 方法 | 是否需真实图像 | 预训练规模 | MMMU (推理) | POPE (幻觉) | 平均分 |
|---|---|---|---|---|---|
| LLaVA-1.5 | ❌ (需图像) | 558K | 33.16 | 60.73 | 40.03 |
| Unicorn (Ours) | ✅ (纯文本) | 1.2M | 36.87 | 64.21 | 43.94 |
为什么比真图还好? 作者认为,传统图文对(如从网页爬取的)描述往往非常简略或充满噪声。而 Unicorn 生成的稠密文本提供了极高质量的语义监督,甚至比单纯的一张模糊图片更能教给模型什么是“空间布局”和“细微特征”。
深度思考与未来展望
Unicorn 的成功挑战了“多模态模型必须依靠多模态数据”的固有认知。它证明了:只要对齐规则找得准,纯文本语料库就是一座未开发的视觉金矿。
- 局限性:目前该方法主要针对静态图像。对于视频(涉及时间维度)或 3D 空间,模态间隙是否依然保持简单的全局线性偏置,仍需进一步验证。
- 启示:这一方案极大地降低了 VLM 的训练门槛和存储压力(仅需原本 1/100 的存储空间)。对于追求极致效率的端侧模型和特定领域(如医疗、精密零件识别)而言,这可能是一条通过知识注入超越通用模型的捷径。
总结 (Takeaway):数据不是越多越好,而是越“稠密”越好。Unicorn 告诉我们,深刻的视觉理解或许可以从文字的灵魂深处走出来。