
UniSD:开启大语言模型“脱离名师”的自进化之路
UniSD: Towards a Unified Self-Distillation Framework for Large Language Models
本文提出了 UniSD,首个用于大语言模型(LLMs)自蒸馏(Self-Distillation, SD)的统一框架。该框架整合了监督可靠性、表示对齐和训练稳定性三大维度的多种机制,通过 UniSD* 集成方案,在无需外部强模型教师的情况下,显著提升了 LLMs 在科学推理、代码生成等任务中的性能。
核心速览
TL;DR:佐治亚理工学院等多所高校的研究团队提出了 UniSD,这是一个系统性研究 LLM 自蒸馏的统一框架。它从监督可靠性、表示对齐和训练稳定性三个维度切入,解决了自蒸馏中常见的信号噪声大、训练收敛难的问题。最终方案 UniSD* 在完全不依赖外部更强模型(如 GPT-4)的情况下,让模型通过“自我反思”和“多维交叉验证”实现了大幅性能跨越。
背景定位:该工作是自蒸馏领域的一次“大一统”尝试,它不再局限于某个具体的微调技巧,而是建立了一个坐标系,量化了各组件(如 EMA, Clipping, Match)的正向贡献,是 LLM 高效自进化的重要里程碑。
痛点深挖:为什么“跟自己学”很难?
在模型微调的语境下,我们习惯于让“小模型”模仿“大模型”。但在隐私敏感、成本受限或大模型本身面临伦理限制时,自蒸馏(Self-Distillation)成了唯一的出路。然而,自蒸馏面临三大顽疾:
- 开放生成的幻觉注入:模型自己生成的代码或推理步骤可能看起来没问题,但局部逻辑错误会被训练过程无限放大。
- 训练的不稳定性:教师信号(模型自身)随着学生(模型自身)的更新而飘移,形成了一种不稳定的“回音廊效应”。
- 缺乏系统指导:以前的研究往往只试一种方法(比如只加个对比学习),没人说得清多种方法叠加到底好不好使。
UniSD 方法论详解:三位一体的改进
UniSD 将自蒸馏重构为一个具备可靠性感知(Reliability-aware)的自我修正过程。
1. 监督可靠性 (Supervision Reliability)
通过 Multi-Teacher Agreement (多教师协议),模型在微调时会为同一个输入生成多个视角。例如,利用不同的 Few-shot 示例或 Prompt 来触发教师信号。如果多个视角的输出趋于一致,说明该信号可靠,权重加大;反之则减小。
2. 表示对齐 (Representation Alignment)
不满足于只学习输出的概率分布(Logits),UniSD 引入了 Feature Matching。它要求学生模型在隐藏层表征上也与经过平滑的教师模型对齐,通过这种 Inductive Bias 维持模型的结构相干性。
3. 训练稳定性 (Training Stability)
- EMA Teacher:不直接拿当前训练中的模型当老师,而是使用其参数的指数移动平均(EMA)版本,提供一个更稳健的“滑窗目标”。
- Divergence Clipping:防止某些极特殊的极端 Token 产生的巨大梯度破坏整个参数空间。
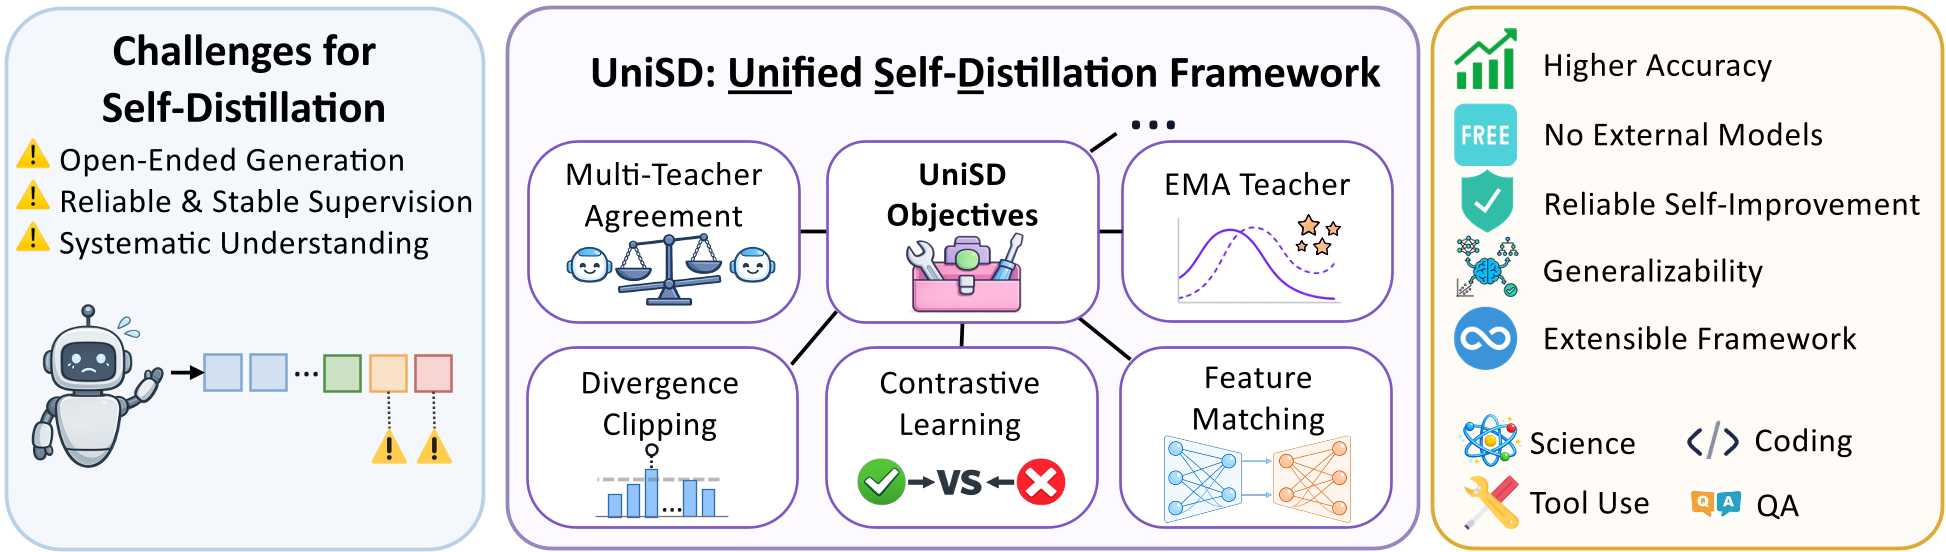 Figure 1: UniSD 框架概览。集成了协议、稳定化、裁剪、对比学习和特征匹配等模块。
实验与结果:全线飘红的性能提升
在跨越科学推理(ScienceQA)、代码(MBPP/HumanEval)和工具调用(ToolAlpaca)的 6 个基准测试中,UniSD* 展现了统治级的实力:
- 性能暴涨:在 Qwen2.5-7B 上,整体成绩从 67.9 提升至 73.3,超越了同等算力消耗下的所有 SOTA 基线。
- 泛化性极强:即便在未见过的任务(OOD)如 GPQA 上,UniSD* 依然保持了显著的领先,证明模型学到的是通用能力而非过拟合。
- 分布留存(Distribution Retention):这是一个关键惊喜!相比于传统的 SFT 会导致模型性能“偏科”(Catastrophic Forgetting),UniSD 在提升任务能力的效率下,几乎完美保留了原模型的生成质量(Perplexity 极低)。
 Table 1: UniSD 各变体与基线方法的性能对比。UniSD 在多项指标上达到最优。*
深度洞察:更有效且更绿色的 AI
UniSD 的一个重要发现是:“更多并不总是更好”。在多教师协议中,增加过多的上下文视角反而可能稀释有效信号(见附录 Figure 9)。同时,研究者给出的资源消耗分析显示,虽然 Agreement 机制会增加计算成本,但像 Divergence Clipping 这样的组件几乎是“免费的午餐”。
总结与展望
UniSD 证明了 LLM 内部蕴含着巨大的、未被充分挖掘的“自我纠偏”潜力。
- 局限性:目前主要聚焦于单轮任务,多轮长程决策(Agentic Tasks)下的稳定性仍待验证。
- 未来:这种“自给自足”的微调模式将极大地推动端侧 AI 和隐私计算的发展,让每一台本地设备上的弱模型都能通过不断的自蒸馏,慢慢向强模型靠拢。
作者提示:UniSD 为学术界和工业界提供了一套完整的自蒸馏工具箱,不仅有理论深度,更有极强的实操指导意义。