
UR2:通过强化学习统一 RAG 与推理,让小模型具备 GPT-4 级的协作能力
UR$^2$: Unify RAG and Reasoning through Reinforcement Learning
本文提出了 UR2 (Unified RAG and Reasoning),一个通过强化学习 (RL) 动态协调检索与推理的统一框架。该方法在 Qwen-2.5-7B 等模型上实现了 SOTA 性能,在法律、医疗和数学推理任务中表现出色,甚至在多个基准测试中达到了与 GPT-4o-mini 相当的水准。
TL;DR
清华大学等机构的研究者提出了 UR2 (Unified RAG and Reasoning) 框架。它通过强化学习解决了模型在复杂推理时“何时检索”以及“如何处理冗余检索信息”的难题。该框架让 7B 规模的开源模型在医疗、法律和多步推理任务上追平了 GPT-4o-mini。
背景:RAG 与推理的“不平衡”之痛
在当前的 AI 研究中,检索增强生成 (RAG) 负责提供外部知识,而强化学习 (RLVR) 负责点燃模型的逻辑推理火花。然而,简单地将两者相加往往适得其反:
- 过度依赖检索:模型变得“懒惰”,遇到问题就搜,甚至产生“哪一个是正确答案”这种毫无意义的查询。
- 推理崩塌:由于检索回来的原始文档充满噪声,模型在 RL 训练过程中发现“不看检索结果”反而得分更高,最终导致检索功能被废弃。
UR2 的核心直觉:难度感知与信息提纯
作者认为,解决上述问题的关键在于建立一种动态的协调机制。
1. 难度感知课程 (Difficulty-aware Curriculum)
UR2 不再让模型“逢问必搜”。通过对训练数据进行难度评分(基于准确率 ),将题目分为简单、中等和困难。
- 简单/中等题:强制使用纯推理 (CoT)。
- 困难题:激活 RAG-RL 模式。 这种设计确保了模型的“推理基本功”不受损,只有在 parametric knowledge(参数知识)不足以支撑答案时,才去寻求外部援助。
2. LLM 摘要:从 11k 到 700 tokens 的跨越
为了对抗噪声,UR2 并不直接将检索到的厚重文档塞给模型,而是通过一个专门的摘要模块进行“脱水”。
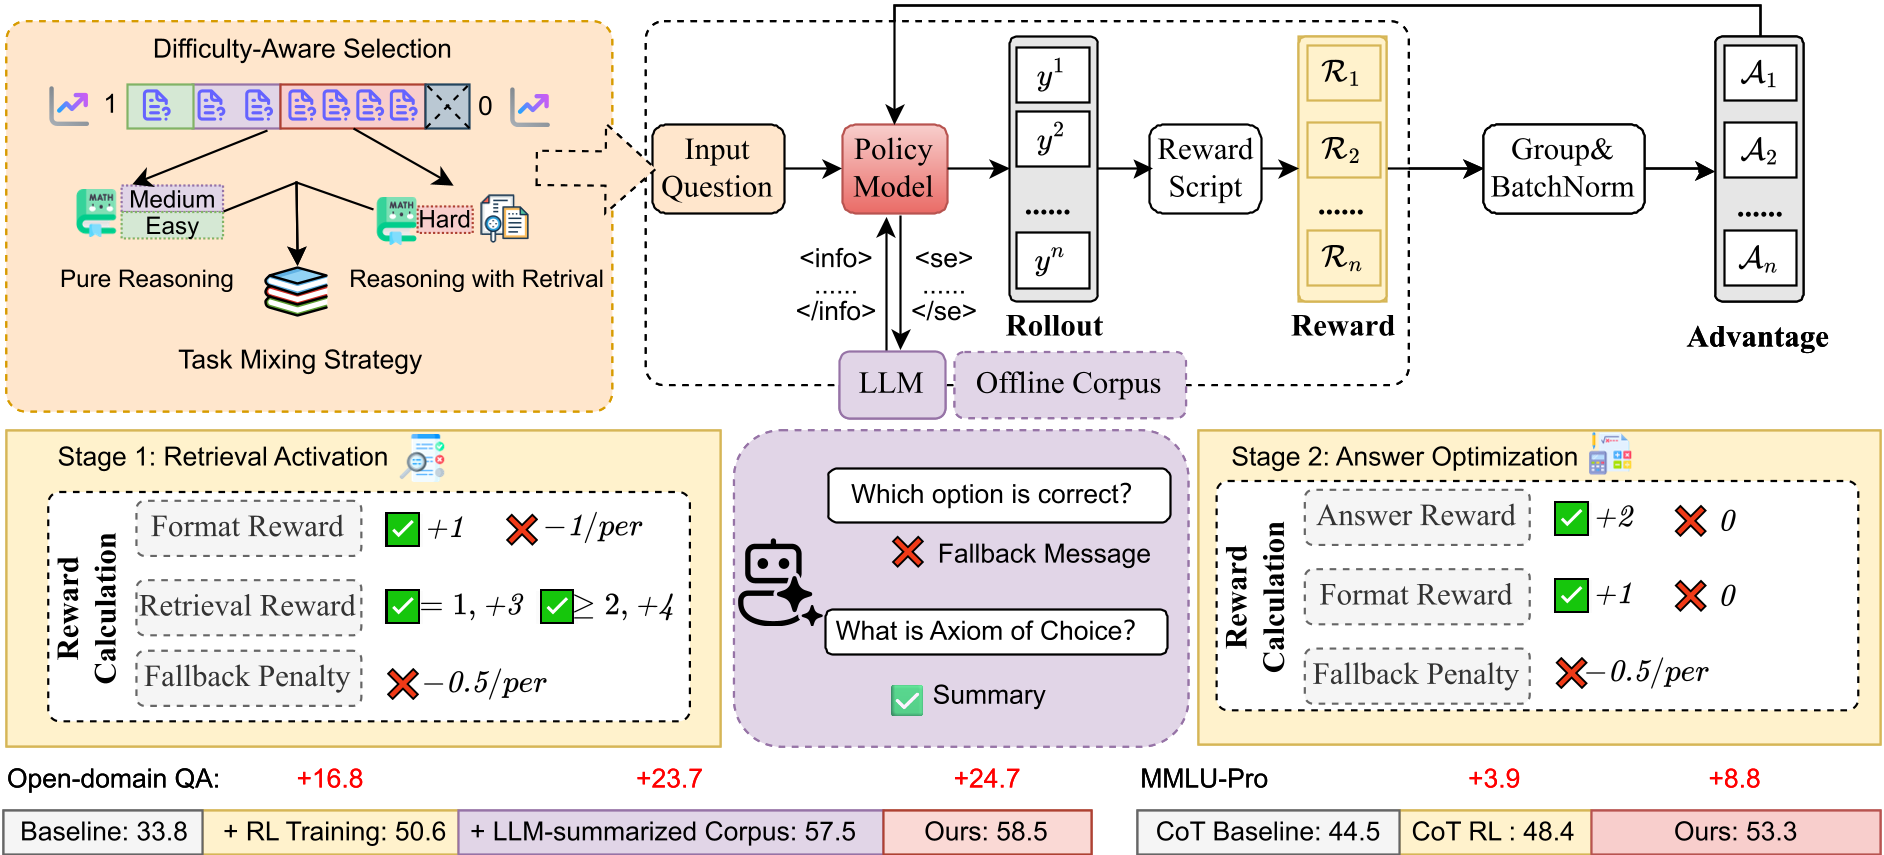
这种压缩不仅让推理步长更短(Attention 复杂度从 显著下降),更重要的是它滤除了无关干扰,使模型在 RL 训练中更容易建立“检索结果”与“正确答案”之间的因果联系。
实验战绩:跨级别的碾压
UR2 在多个模型架构(Qwen-2.5, LLaMA-3.1)上表现出极强的泛化能力。
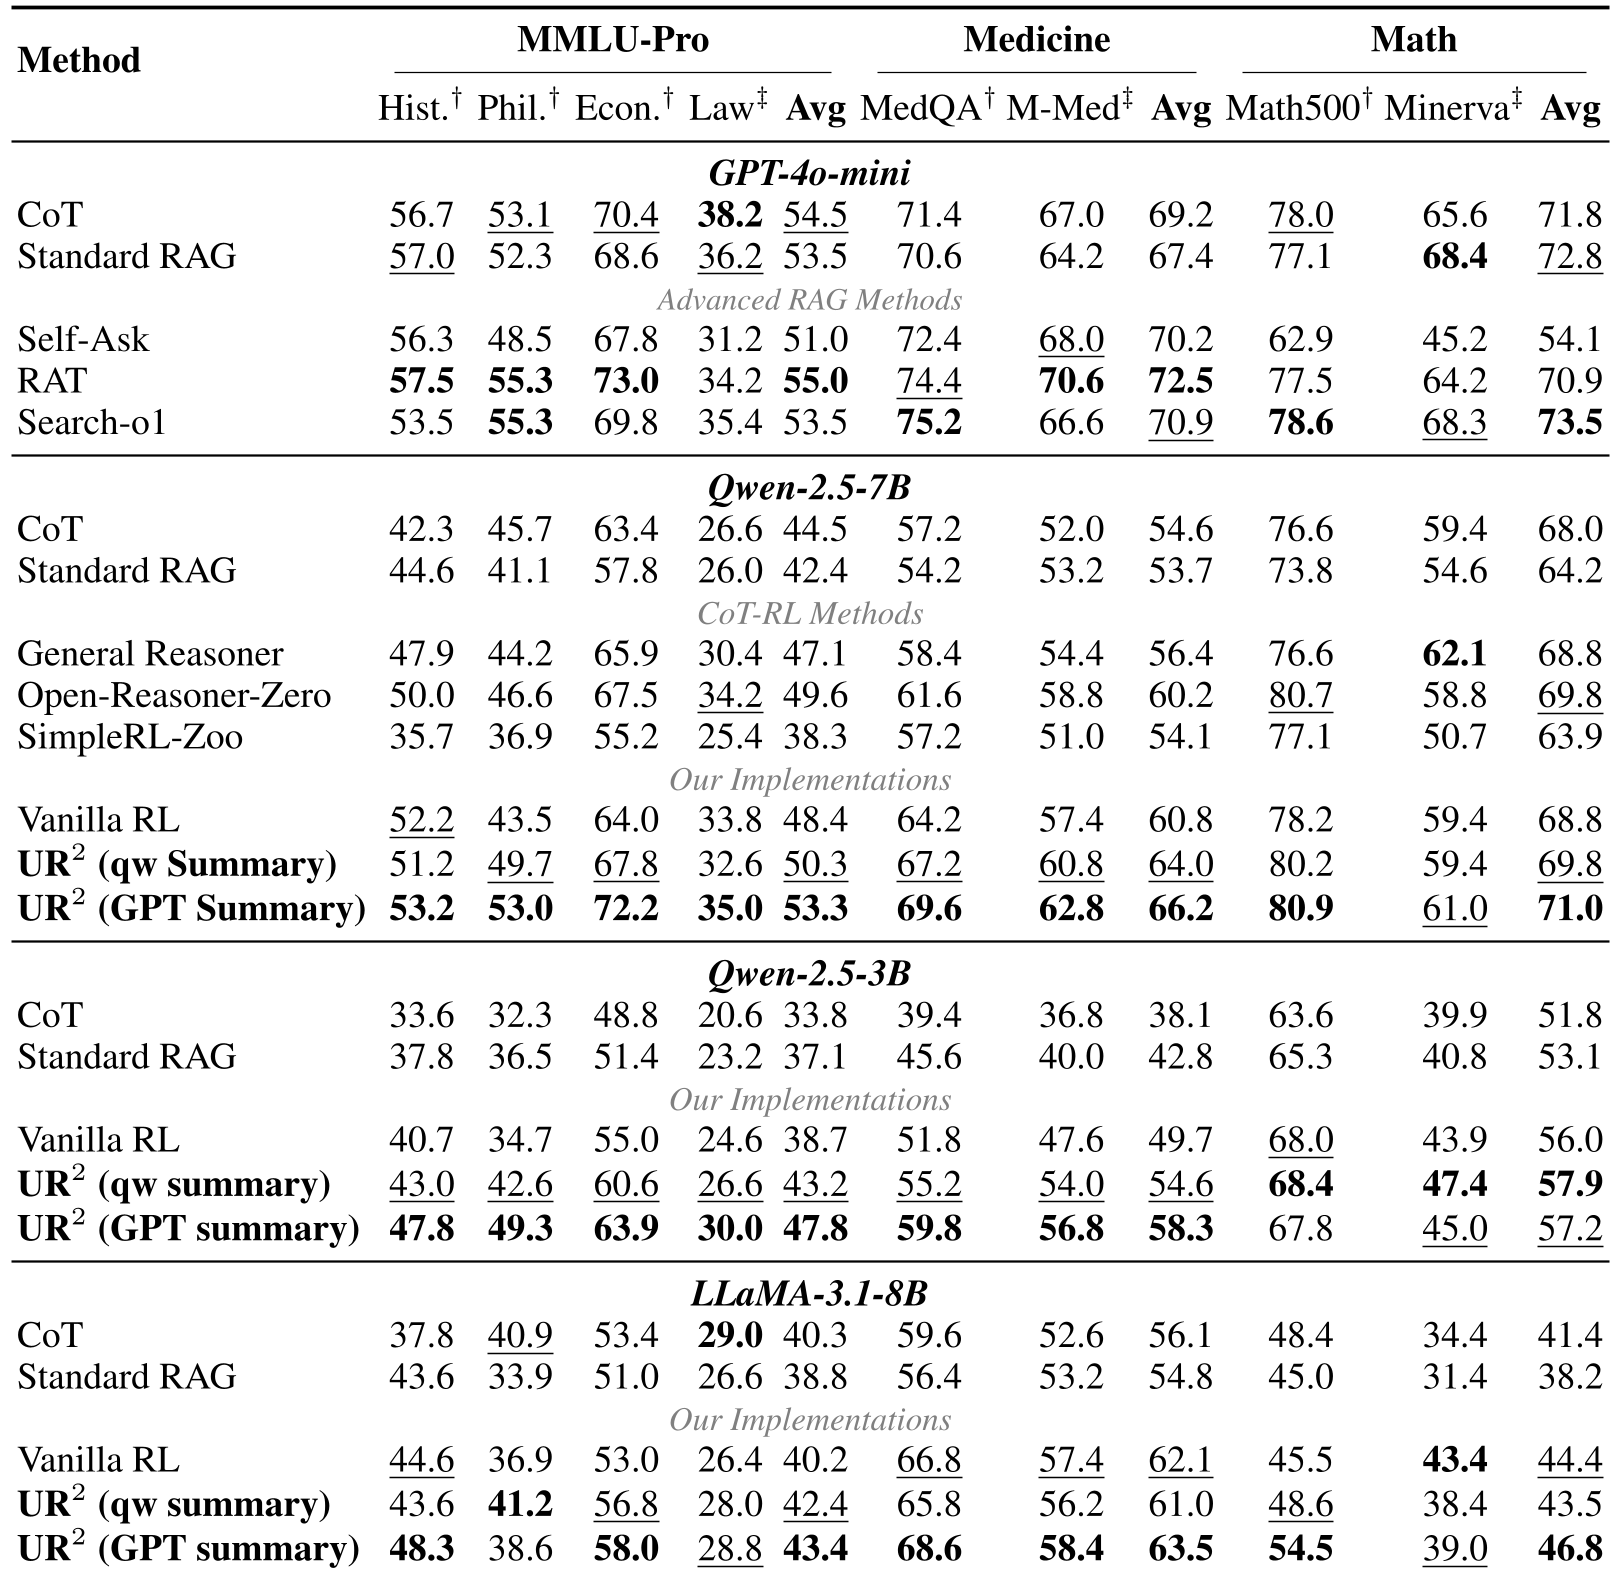
- 性能暴涨:在 Qwen-2.5-7B 模型上,UR2 在医学任务上提升了 5.7%。
- 追平闭源模型:经过 UR2 训练的 7B 模型在 MMLU-Pro 评分上达到了 53.3%,与 GPT-4o-mini 处于同一梯队。
- 行为进化:模型自发形成了自我验证(检索信息验证现有结论)和假设修正(根据搜索结果重写推理逻辑)的高级认知行为。
深度洞察:两阶段优化的艺术
UR2 的成功离不开其精心设计的两阶段奖励函数:
- Stage 1 (能力激活):重点奖励“格式正确”和“有效的检索调用”。此时不看答案对错,先教会模型怎么正确使用搜索工具。
- Stage 2 (质量优化):在保留检索习惯的基础上,引入答案正确性奖励,精炼推理过程。
这种“先学招式,再练内功”的策略极大规避了 RL 训练中的采样稀疏问题。
局限性与未来
尽管 UR2 表现强劲,但其目前的摘要过程依赖于额外的 LLM 调用。未来的研究方向在于如何将这种摘要能力直接蒸馏到主模型中,并进一步扩展到 32B 乃至更大型的混合专家模型 (MoE) 中。
总结
UR2 为我们展示了一个明确的信号:未来的 LLM 并非单纯的参数化容器,而是能够动态感知自身知识边界,并熟练操控检索工具进行复杂思考的逻辑引擎。