
URSA:告别“盲目搜索”,开启化学感知的逆合成评估新时代
URSA: Chemistry-Aware Benchmark for Utilitarian Retrosynthesis Assessment
本文推出了 URSA(Utilitarian RetroSynthesis Assessment),这是一个针对逆合成分析设计的化学感知评价基准。该框架不仅考量路径是否收敛至商业原料,更引入了基于 ChemCensor 的化学合理性(Chemical Plausibility)评分,填补了现有指标在 Solv-2 等级(选择性与合理性)上的评价空白。
TL;DR
在 AI 制药领域,设计合成路径(Retrosynthesis)就像是下围棋:目标明确,但每走一步都要符合规则。长期以来,我们评价 AI 合成算法的标准非常低——只要它能连到现成的原料就行(Solvability)。但这忽略了一个致命问题:AI 经常为了强行“通关”而编造出化学上不可能发生的反应。
近日发布的 URSA 框架,通过引入 Solv-2 级别的化学合理性校验,彻底拆穿了这些“幻觉路径”。研究表明,目前流行的 LLM (如 GPT-5 等) 在面对真实药用分子合成任务时,化学严谨性仍显著逊于专业的传统模型。
痛点深挖:为什么“路径通达”是一个虚假指标?
传统的逆合成评价主要看两个指标:
- Top-K 准确率:看预测是否和实验数据一模一样(太保守,扼杀了创新的可能)。
- 库存通达率 (Stock Termination):看能不能连到买得到的原料(太激进,导致模型通过幻觉反应作弊)。
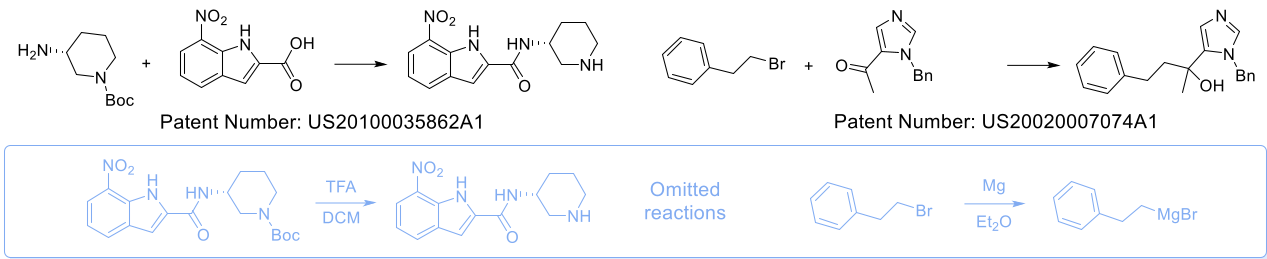
就像下图中展示的那样,USPTO 数据集中充斥着大量缺乏中间体细节的“跳跃式反应”,导致模型学到了错误的逻辑。
核心机制:化学感知的分层评测
URSA 将评价体系从 Solv-0(格式正确)提升到了 Solv-2(化学合理)。其核心“判官”是 ChemCensor。
它是如何工作的?
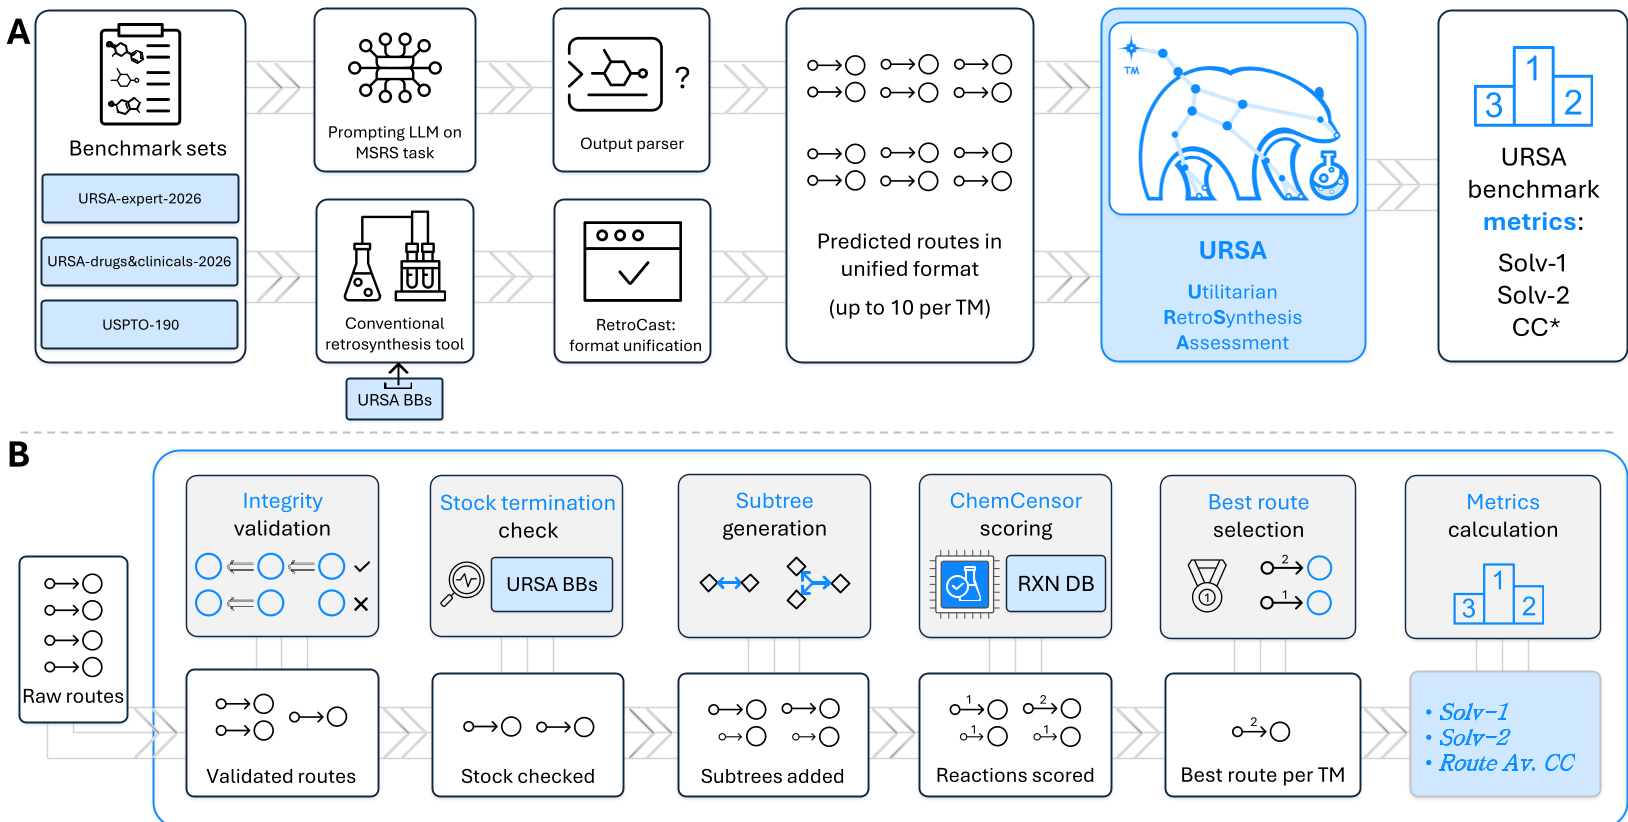
- 标准化路径:使用 RetroCast 将各种格式的路径转统一。
- 子树生成 (Subtree Generation):通过合并/展开反应步骤,消除由于数据记录习惯(有些记录省略了去保护步骤)带来的不匹配。
- 反应中心提取:从 RC1 到 RC5,由浅入深提取反应周围的拓扑环境。
- 先例匹配:在数百万规模的专利反应库中搜索,如果这个“反应中心及周边的官能团环境”从未被观察到,则判定该步反应为“幻觉”。
实验结果:LLM 的“化学自信心”陷阱
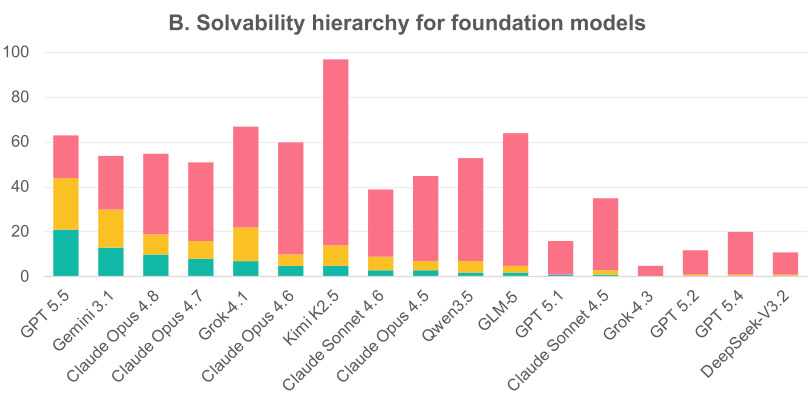
研究者对比了包括 GPT-5.5、Claude 4.8 Oups 在内的 frontier LLMs 和传统 CASP 工具。
1. 判定能力的碾压
在判定单步反应是否合理时,ChemCensor 的准确率达到 0.96,而即便最强的 Gemini 3.1 也只有 0.83。更严重的发现是,所有 LLM 都倾向于“盲目乐观”:它们对错误反应的查出率(Recall for non-plausible)极低,这会导致合成树在搜索初期就陷入万劫不复的错误分支。
2. 实战战绩比较
在针对真实药物分子(URSA-drugs-2026)的测试中:
- RetroChimera-MCTS:拿下了 60% 的 Solv-2 合理路径。
- GPT-5.5:虽然格式正确率极高(Solv-0),但最终合理率仅为 35%。
- 代价论:传统模型的搜索成本不到 1 美元,而调用顶级 LLM 往往需要花费百倍的 API 费用,且效果更差。
深度洞察:为什么 LLM 在逆合成上会掉队?
论文指出一个重要现象:全局一致性的脱节。 LLM 也许能在局部单步反应中给出一个不错的解释,但逆合成是“长程约束”任务。一个极小的局部选择错误,在经过多步传播后,会积累成逻辑崩溃。当前 LLM 本质上是基于概率的下一个词预测,缺乏像 MCTS(蒙特卡洛树搜索)那样的全局前瞻评价能力。
总结与局限
URSA 为化学界提供了一个公正的“准考证”。它告诉我们:合成路径不仅要通,更要科学。
- 优点:通过确定性规则与庞大的先例库结合,极大地降低了模型幻觉的影响。
- 局限:目前的评价停留在 Solv-2。真实的 Solv-3(实验可执行性)还需要考虑收率、溶剂、催化剂和分离成本。
对于未来的研究,将传统搜索算法的稳定性和 LLM 的战略直觉相结合,并置于 URSA 这样的严苛框架下训练,或许才是通向“全自动药物合成”的正确路径。