
有利于探索,但在精准度上充满风险:揭秘 AI 学术工具的真实表现
Useful for Exploration, Risky for Precision: Evaluating AI Tools in Academic Research
本文提出了一个结合人类中心(Human-centered)与计算机中心(Computer-centered)指标的 AI 学术工具基准测试框架,对主流的文档问答(Q&A)和文献综述工具(如 ScienceOS, Consensus, ChatGPT 等)进行了评估。研究发现,AI 工具在早期探索和浅层摘要任务中表现优异,但在精确信息提取、可解释性(xAI Accuracy)及文献检索重现性方面存在显著风险。
TL;DR
随着 GenAI 席卷学术界,研究人员开始依赖 AI 读论文、写综述。但这篇来自德累斯顿工业大学的最新研究泼了一盆冷水:虽然 AI 工具在生成摘要和初步探索时能大幅提升效率,但在涉及精确信息提取和文献溯源时,其表现非常不稳定。特别是 Explainable AI (xAI) 的低准确率,意味着 AI 虽然给了你答案,但它给出的“证据高亮”往往是一派胡言。
背景定位
本文不是一篇纯技术的 SOTA 刷榜论文,而是一篇学术工具实测指南。它填补了传统技术评估与实际科研工作流之间的空白,通过“以人为中心”的视角,告诉科研工作者:哪些环节可以信任 AI,哪些环节必须保持警惕。
核心痛点:效率提升背后的“校验负担”
作者指出,科研人员面临的困境在于:如果 AI 生成的每一个步骤都需要人工去核实原文(Verification Burden),那么 AI 带来的效率增益就会被抵消。
目前主流工具(如 Humata, PDF.ai, Perplexity 等)存在三大硬伤:
- 解释性偏移 (Explainability Gap):AI 标出的原文段落往往并不支持它生成的答案。
- 幻觉防御失败:面对文档中缺失的信息,许多工具会编造答案而非选择“拒答”。
- 文献综述黑盒化:文献搜索结果缺乏透明度,同一问题两次搜索结果重合率极低。
方法论详解:如何科学地“找茬”?
研究者针对 Q&A 和文献综述两类工具分别量身定制了评测体系。
1. 文档 Q&A 工具评测
使用了单文档和多文档(Multi-document chat)对比。尤其关注 xAI Accuracy:即系统是否能精准定位支撑答案的原文。
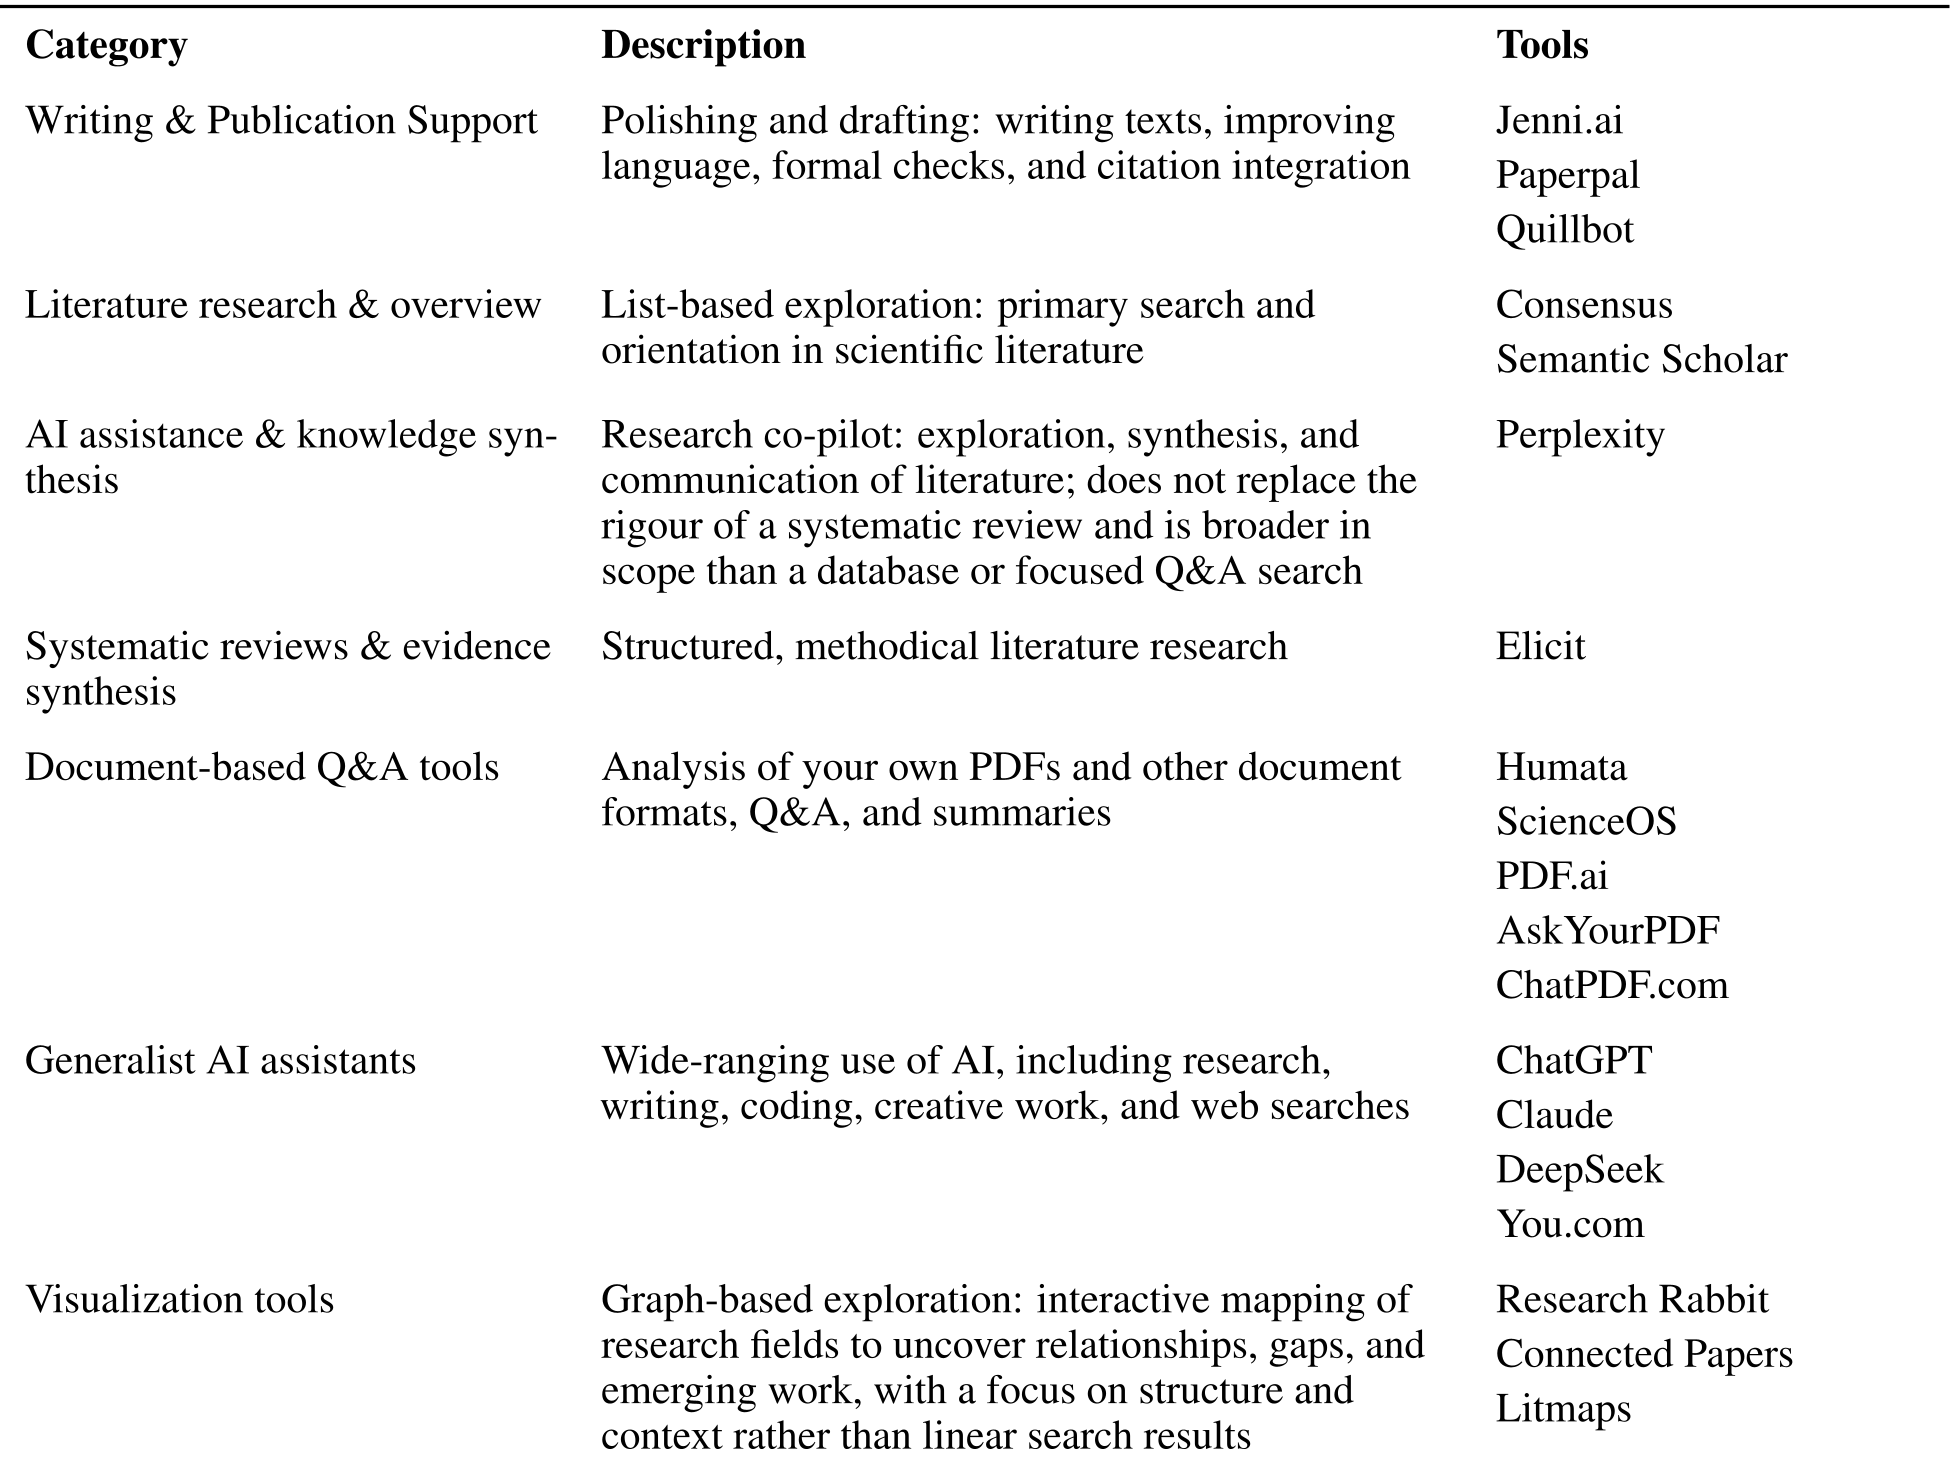 上图展示了被测试工具的分类:从写作支持到系统化文献综述工具。
2. 文献综述工具评测
重点测试了 Reproducibility (可复现性)。研究者使用同一研究问题多次询问 AI,计算其返回文献库的 Jaccard 指数(交集大小/并集大小)。
实验与结果:数据揭秘真相
Q&A 表现:摘要可以信,细节要小心
在“文档摘要”任务中,大部分工具都能拿到 5 分(满分)。但在“图表提取”和“公式提取”这类需要像素级精确任务中,表现极不稳定。
- 痛点: 当文档中没有答案时,Humata 和 AskYourPDF 往往会产生幻觉(得分仅 1 分),而 PDF.ai 表现较好,会明确告知无法找到。
- 致命伤: xAI 精度普遍偏低,不少工具会随机高亮整页内容或参考文献列表。
文献综述表现:无法通过系统性综述的考验
实验结果令人震惊,文献检索工具的**可用来源(Usable Sources)**比例极低。
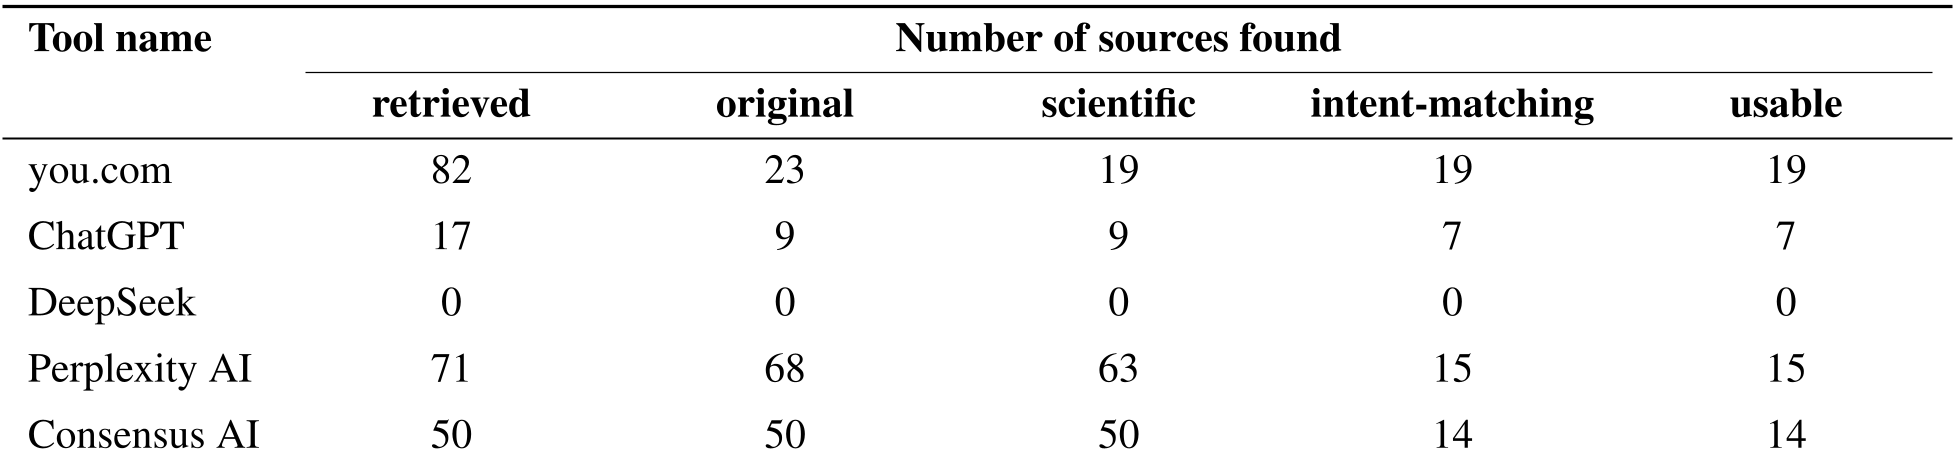 如上表所示,You.com 虽然找了 82 个来源,但去重并按科研标准(同行评审、相关性)过滤后,仅剩 19 个可用。
可复现性灾难:
- Perplexity AI 的结果重合率仅为 11.8%。
- Consensus AI 表现最好,但也仅有 28.0%。 这意味着,如果你依赖这类工具做“系统性综述 (Systematic Review)”,你的研究结论可能仅仅取决于 AI 某次随机采样的心情。
深度洞察:我们该如何与 AI 协作?
1. 总结 (Takeaway)
AI 工具在科研初期的初步探索 (Exploration Phase) 极其有用,它可以帮你快速扫读大量文献并归纳主旨。但在验证阶段 (Verification Phase),目前的工具还远远达不到“自动化处理数据”的标准。
2. 局限性 (Limitations)
本研究的评估样本量较小(单人打分),且 AI 模型迭代极快(测试时使用的是 GPT-4 级别模型)。未来在 GPT-5 或同级别模型中,这一现状可能会有所改观。
3. 给研究者的建议
- 使用 Q&A 工具时:只用它来做 Overview,不要用它导出的数值直接写论文。
- 做文献综述时:将 AI 工具作为布尔搜索的补充,发现冷门词汇,但最终文献库必须通过手动检索(如 Google Scholar, PubMed)二次确认。
结论: AI 是一个博学的实习生,它能帮你读完一千卷书,但它给出的每一个脚注,你最好都要亲自核对。