
V-MAGE:当 MLLM 走进游戏厅,视觉智能的“遮羞布”被扯下来了
V-MAGE: A Game Evaluation Framework for Assessing Vision-Centric Capabilities in Multimodal Large Language Models
本文推出了 V-MAGE,一个专门用于评估多模态大语言模型(MLLM)以视觉为核心的动态交互能力的基准测试框架。该框架包含 5 款经典的视频游戏(如 SuperMario, Pong),涵盖 30 多个精心设计的关卡,通过连续空间的视觉输入挑战模型的感知与实时决策能力,目前 SOTA 模型在复杂场景下仍显著落后于人类。
TL;DR
尽管 GPT-4o 和 Gemini 在静态图像理解上已经接近人类,但在实时交互的视频游戏面前,它们依然显得像“反应迟钝”的。本文提出的 V-MAGE 框架通过 FlappyBird、超级马里奥等 5 款游戏,证明了当前的 MLLM 在处理连续空间的时空推理(Tracking & Timing)时存在根本缺陷,尤其是严重的锚定偏差让模型在快速变化的环境中举步维艰。
背景定位
目前大模型能力评估陷入了“刷榜怪圈”,模型在 MME、MMBench 等静态榜单上分数极高,但在处理真实世界动态交互时却漏洞百出。V-MAGE 并不只是另一个榜单,它是一个纯粹**以视觉为中心(Vision-Centric)**的沙盒,强制模型仅通过“看”像素来玩游戏,不提供任何背后的状态码或符号化信息。
痛点深挖:为什么“会看图”不等于“会玩游戏”?
作者指出,现有基准测试存在两个致命伤:
- 文字可离散化:很多游戏(如国际象棋、推箱子)其视觉本质可以用文字坐标替代。
- 缺乏时序性:模型只需看一眼瞬时状态,而不需要理解“运动趋势”。
在 V-MAGE 中,如果模型不能从连续帧中识别出 Flappy Bird 的坠落速度或 Pong 球的运动矢量,它就无法做出任何有效决策。
核心机制:V-MAGE 的三模组管线
为了公平对比,V-MAGE 采用了帧暂停机制(Frame-pausing)。当模型推理时,游戏时钟停止,确保评分只反映模型的“智力”而非“API 延迟”。
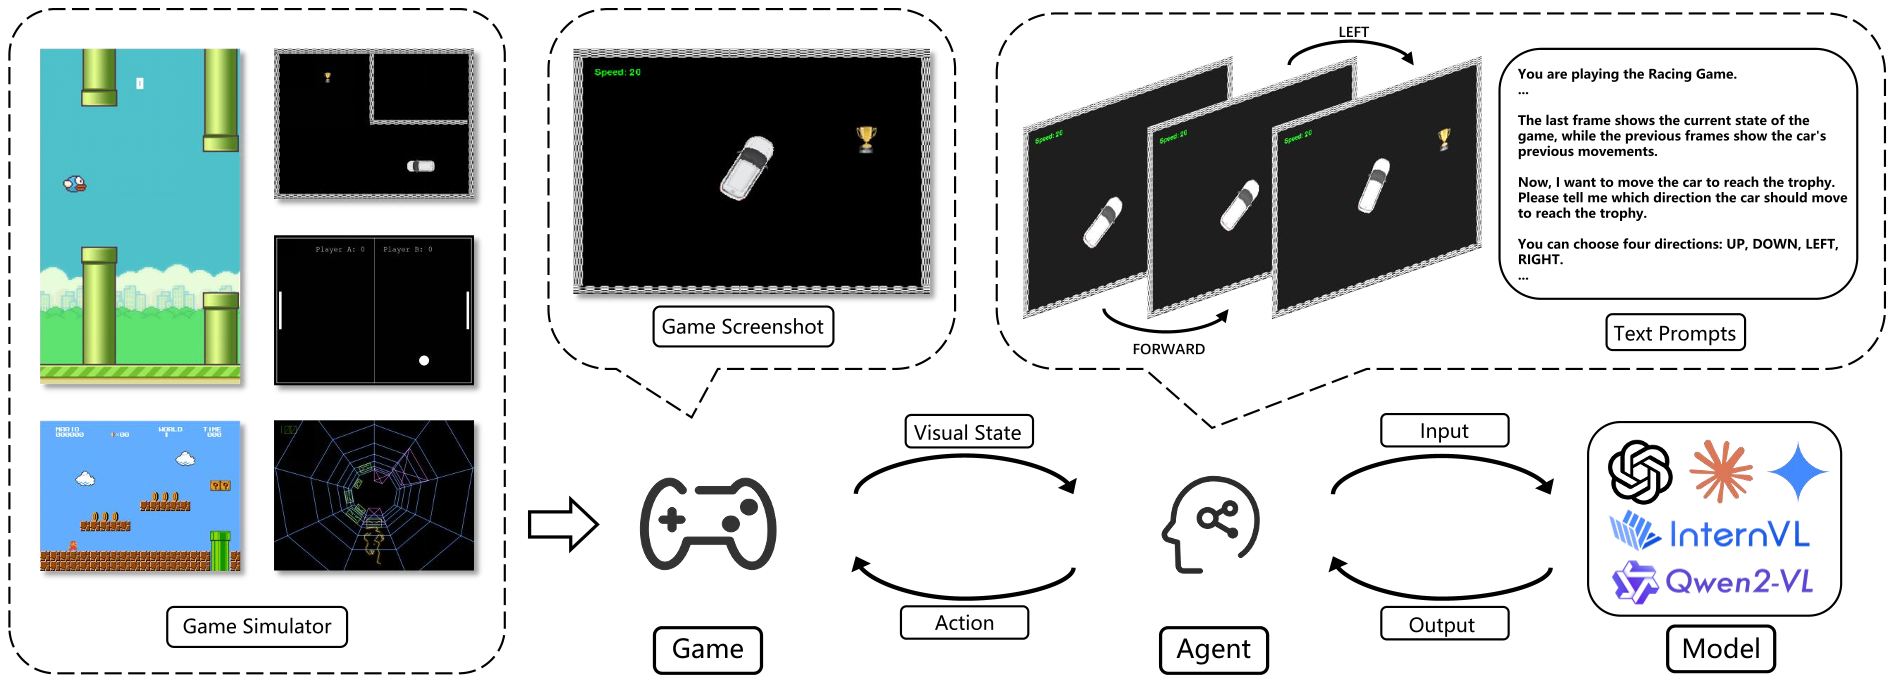
- 游戏模块:提供 Pygame 驱动的连续空间环境。
- 智能体模块:负责多帧图像采样与提示词(Prompt)封装。
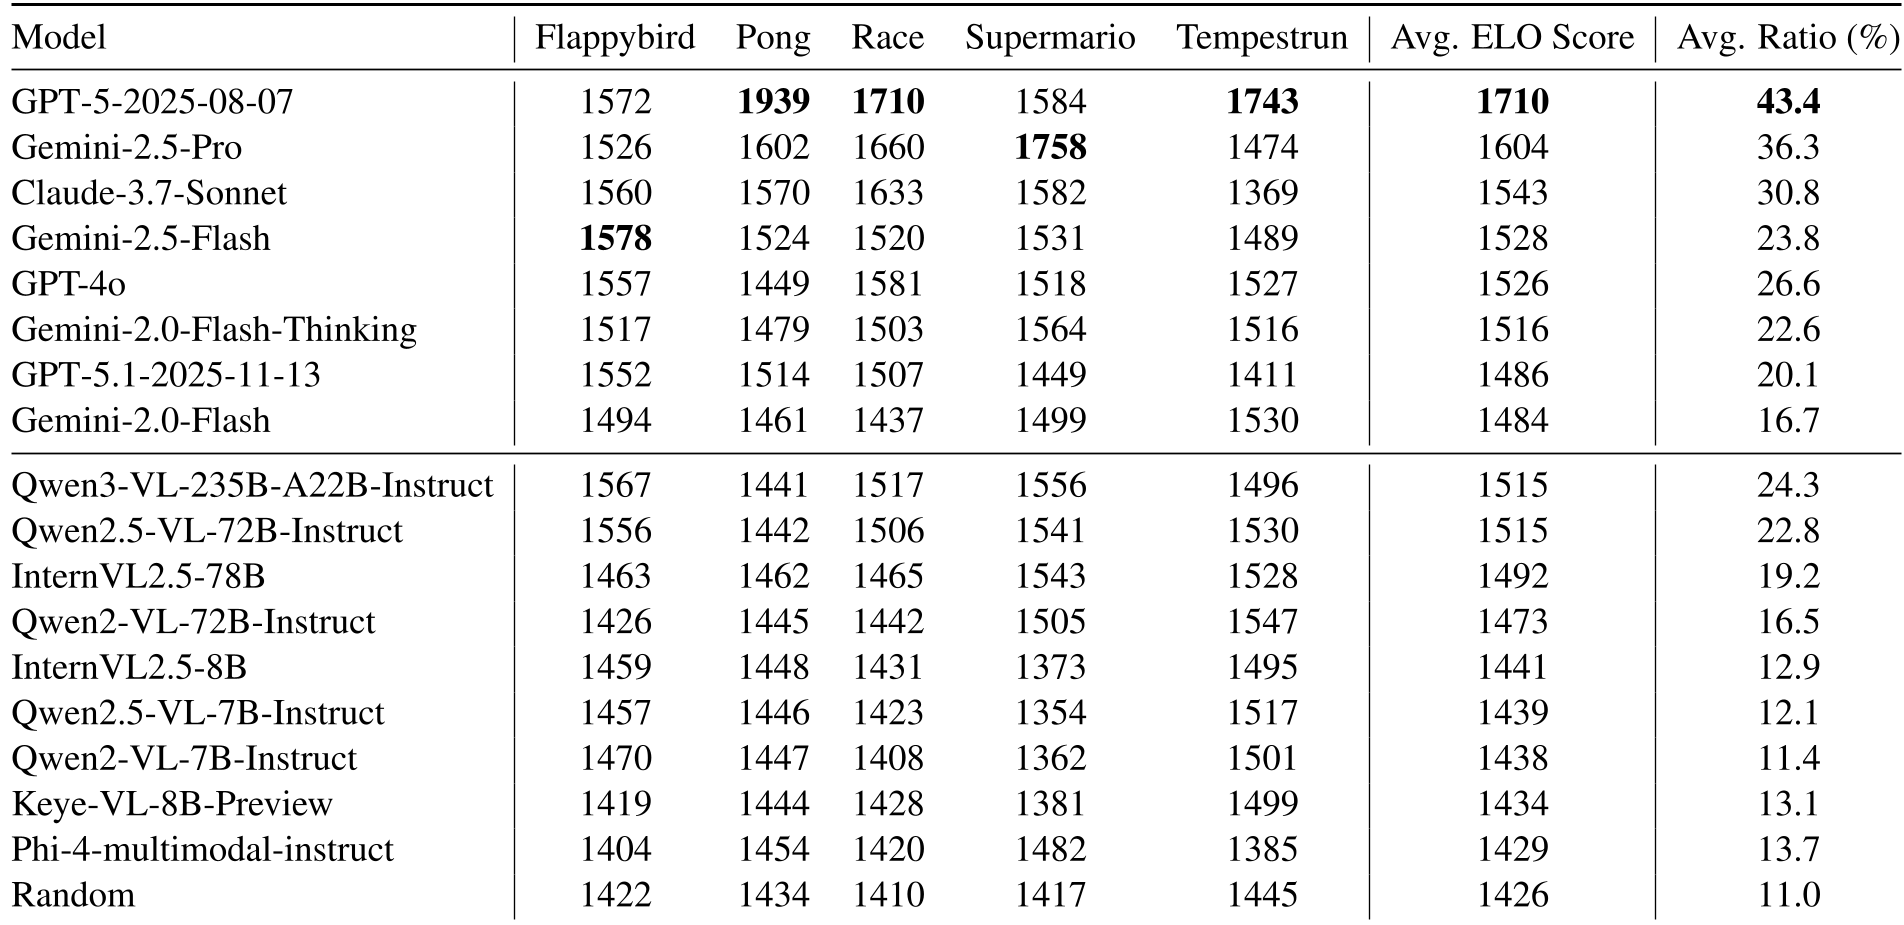
- ELO 排名系统:不同于原始得分,ELO 通过模型间的两两博弈,更客观地反映了模型在不同关卡下的表现一致性。
核心发现:模型存在的“认知顽疾”
通过对 SOTA 模型的深度测试,作者发现了两个极其有趣的现象:
1. 锚定偏差(Anchoring Bias)
这是本次研究最深刻的一项发现。许多模型(如 Qwen2VL 72B)在面对连续且相似的视频帧时,会陷入“推理自旋”。
- 表现:模型倾向于重复之前的推理逻辑,哪怕画面中关键障碍物已经逼近。
- 数据证明:GPT-4o 是对视觉变化最灵敏的,平均每 1.6 次响应就会更新推理;而一些国产开源模型则需要近 20 次响应才会改变主意。
2. 知覺跳過实验(Perceptual Skipping)
如果直接把游戏状态用文字告诉模型(绕过视觉感知),性能会如何?
- 结果:即使给了完美的文字描述,模型表现虽然大幅提升,但仍远低于人类水平。这说明 MLLM 不仅是“眼睛”不好(感知缺陷),其“大脑”对于动态策略规划也存在严重的逻辑鸿沟。
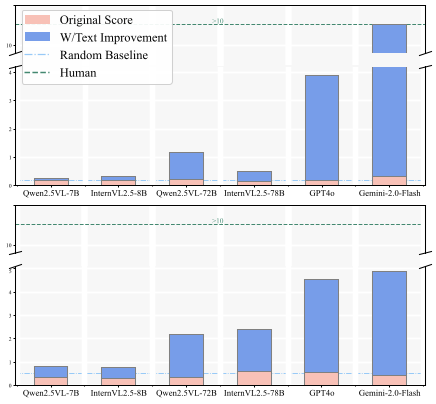
实验结果对比
在 ELO 综合排名中,GPT-5(测试版本)和 Gemini 2.5 Pro 依然占据第一梯队,而国内的 QwenVL 系列在部分游戏(如 FlappyBird)中展现了惊人的追赶态势。然而,所有模型在复杂 3D 逃生游戏 TempestRun 中的表现几乎全线崩溃。
总结与启示
V-MAGE 的出现给 MLLM 研究者提了个醒:多模态模型不应仅仅是“会写说明文的诗人”。
- 局限性:由于 Pygame 模拟的限制,目前的 3D 环境尚不够真实。
- 未来展望:要让模型真正具备“人类级别”的视觉智能,必须重点攻击 时空特征对齐 和 长时序交互中的锚定偏差 问题。
这项工作不仅提供了一个评估工具,更为通向“通用 Embodied AI”指明了必经之路。