
VPO:为多样性而生,开启 LLM 推理搜索的新范式
Vector Policy Optimization: Training for Diversity Improves Test-Time Search
本文提出了向量策略优化(Vector Policy Optimization, VPO),一种针对大语言模型(LLM)后训练阶段的强化学习算法。该方法通过在单一生成链中输出多个候选答案,并利用随机奖励权重进行集水平(set-level)优化,显著提升了模型在推理侧搜索(inference-time search)下的性能表现。
TL;DR
在最近的 AI 研究趋势中,“推理侧扩展(Inference-time Scaling)”成为了提升大模型逻辑能力的关键。然而,传统的 Reinforcement Learning (RL) 往往会让模型变得“固执”且“单调”。本文介绍的 Vector Policy Optimization (VPO) 提出了一种全新的视角:与其强迫模型在训练时死磕一个标准答案,不如教会它生成一组覆盖各种可能权衡(Trade-offs)的优秀候选集,从而为后期的搜索算法提供肥沃的“土壤”。
背景定位:当强化学习遇上推理搜索
传统的后训练方法,如我们熟知的 GRPO,本质上是在做“剥夺探索权”的工作。它将多个评估维度压缩成一个标量分数,并引导模型概率分布向该分数的最大值塌缩。结果就是,当你想要采样 100 个答案来做重排序(Re-ranking)或进化搜索(Evolutionary Search)时,你会发现这 100 个答案几乎长得一模一样。
VPO 的核心洞察在于:如果系统中存在推理侧搜索,那么 RL 训练的职责应当转变为“多样化的探索”,而将“高精度的剥夺”留给搜索阶段。
核心动机:奖励向量化的物理直觉
在现实任务中,奖励往往是向量化的。例如在代码生成中,不同的测试用例(Test Cases)就是不同的奖励维度;在长文本推理中,每一个中间推理步骤(Hop)的正确性也是独立的维度。
如果我们始终用固定的权重(如平均值)去训练,模型会倾向于寻找某种中间态的平庸方案。而 VPO 通过随机采样奖励权重 ,强制模型去考虑:如果维度 A 比维度 B 更重要时该怎么做?反之又该怎么做?
方法论详解:如何训练一个“不偏科”的模型
VPO 的实现非常优雅,仅对现有的主流框架(如 veRL)做了极小的侵入。
1. Multi-Answer Chains (上下文内探索)
VPO 不再是独立采样多个 rollout,而是让模型在同一个序列中顺序生成 个答案。
- 逻辑含义:当生成第 个答案时,模型能看到前 个答案。这赋予了模型“上下文感知”的能力,它会意识到:“前面的兄弟已经尝试过路径 A 了,那我要尝试一下路径 B”。
2. Set-Level Reward Optimization
其奖励计算公式如下:
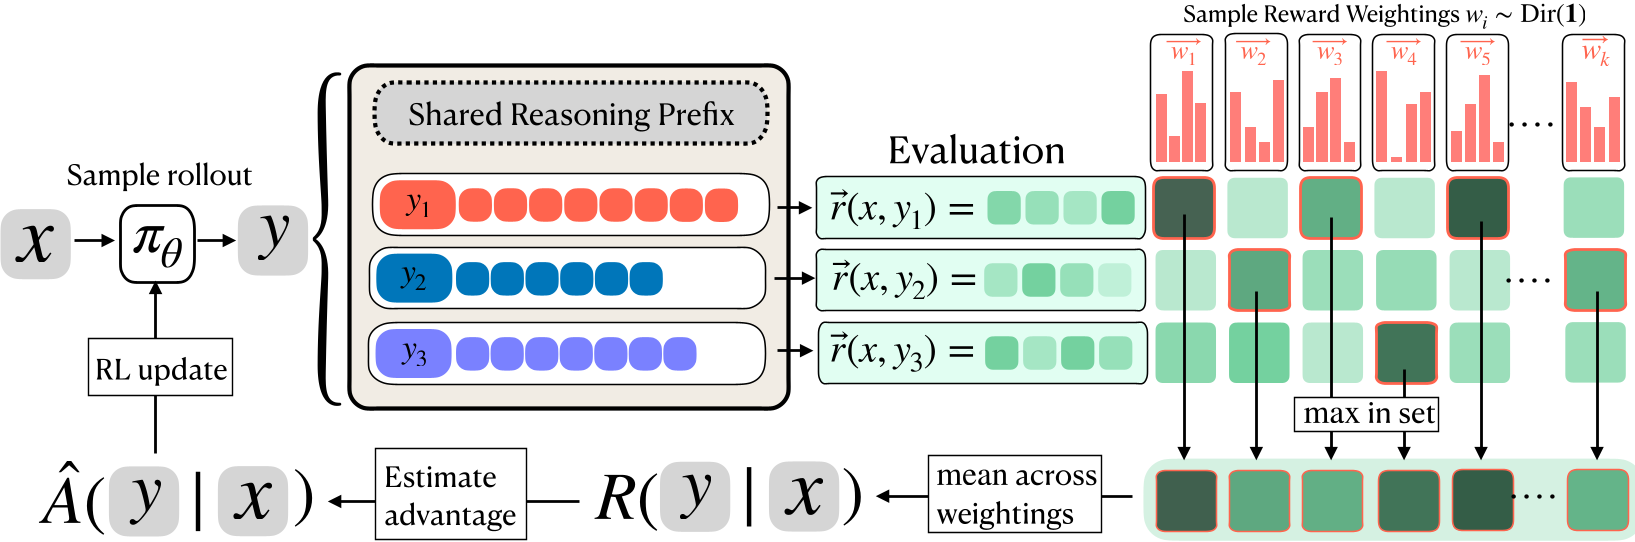 图 1:VPO 流程。模型生成 m 个答案后,通过多次随机采样权重,计算每组权重下候选集中的最高分,作为整体奖励。
这种机制鼓励候选集 作为一个整体覆盖尽可能广的 Pareto Frontier。只要候选集中有一个答案在某种权重分配下表现出色,整个生成序列就会受到正向激励。
实验战绩:突破标量 RL 的天花板
研究团队在 Maze(迷宫)、MuSiQue(多步问答)、EUREQA(逻辑链)和 ToolRL(工具调用)四个领域进行了验证。
核心发现 1:搜索预算越高,VPO 优势越大
在传统的 GRPO 下,采样数量 增加到一定程度后,Performance 就达到了平台期。而 VPO 的表现随采样预算持续攀升(见图 2)。
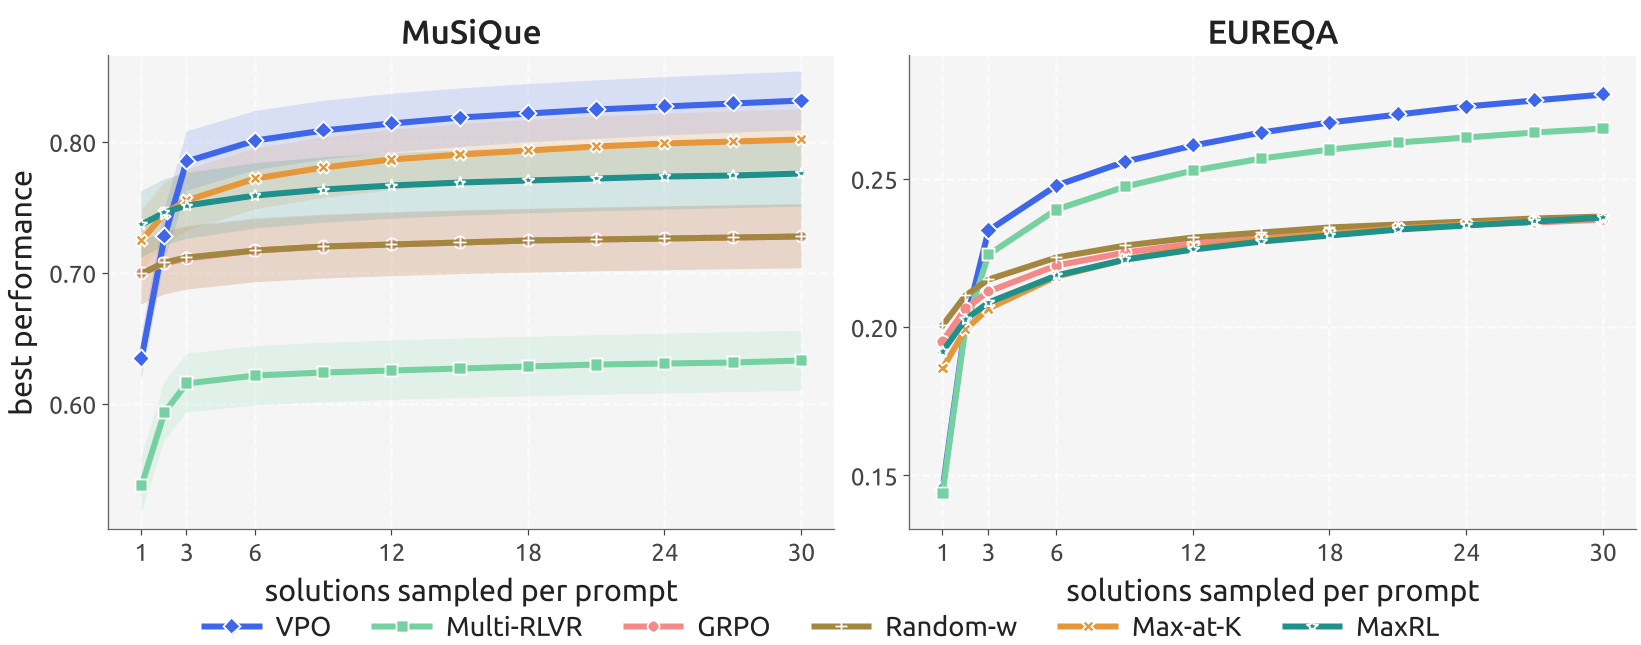 图 2:在 MuSiQue 和 EUREQA 任务上,VPO (蓝线) 在 值增大时展现出极强的韧性,远超 GRPO (红线)。
核心发现 2:赋能进化算法
在 LiveCodeBench 的极端案例中,配合 OpenEvolve 进化搜索,VPO 训练的模型在经过 200 次迭代后,能够解出那些 GRPO 模型在任何采样量下都无能为力的 Hard Problems。
深度思考:什么时候 VPO 会失效?
论文作者非常坦诚地指出了适用边界。VPO 的有效性建立在“奖励维度是非共线(Non-collinear)”的假设上。
- 如果所有奖励维度高度相关(即奖励向量本质上就是个标量),那么 VPO 就会退化为普通的 RL,甚至因为引入了随机扰动而导致收敛变慢。
- 在 UltraFeedback 这种维度间高度冗余的任务中,VPO 的优势并不明显。
总结与展望
VPO 并不是对 GRPO 的否定,而是对 “Agent = Policy + Search” 这一公式的深度重构。它告诉我们,在通往 AGI 的道路上,我们的目标不应该是一个只会复读“标准答案”的机器,而是一个能够探索无限可能、并为搜索智慧提供充足弹药的策略网络。
对于正在构建 Code Agent 或复杂推理系统的团队来说,VPO 提供了一个几乎是 Drop-in Replacement 的升级方案,值得一试。