
语言模型中的“意识”窗口:可言说表示构成的全局工作空间
Verbalizable Representations Form a Global Workspace in Language Models
本文提出了一种名为 Jacobian Lens (J-lens) 的新型可解释性技术,用于识别 LLM 中处于“待表达状态”的内部表示。研究发现,LLM 演化出了一个功能上类似于人类大脑“全局工作空间 (Global Workspace)”的 J-space,它介于自动文本处理和最终输出预测之间,专门负责可报告的、灵活的推理任务。
TL;DR
大语言模型(LLM)是否真的在“思考”,还是仅仅在进行统计补全?Anthropic 的最新研究给出了令人振奋的答案:模型内部确实存在一个全局工作空间(Global Workspace)。通过一种名为 Jacobian Lens (J-lens) 的技术,研究者发现模型会将复杂的推理路径浓缩为一组“可言说”的中间概念(J-space)。这些概念虽然只占激活值方差的不到 10%,却主宰了模型的逻辑推理、自我监控和战略决策。
痛点深挖:我们为什么看不透模型的“心思”?
在过去,我们观察模型内部状态主要依赖两种工具:
- Logit Lens:直接查看中间层对词表的投影。但它非常粗糙,在模型前三分之一的层数几乎全是噪音。
- Tuned Lens:通过训练一个小型线性回归器来预测输出。它的问题在于“太聪明了”,往往会跳过模型正在进行的中间思考,直接剧透最终答案。
作者认为,模型内部的大部分计算是“自动且无意识的”(如语法解析),只有一小部分是“可被觉察且用于推理的”。我们需要一种能精准定位这部分“特权表示”的方法。
方法论详解:Jacobian Lens (J-lens) 与 J-space
J-lens 的核心直觉是:如果一个内部表示是重要的,它必须对模型未来“说出什么”产生因果影响。
研究者通过计算激活值 对最终输出 的 Jacobian 矩阵,并在大量语料上取平均,得到了一组固定方向的向量。每一个向量都对应词表中的一个 token,代表了模型“想要表达这个词的冲动”。
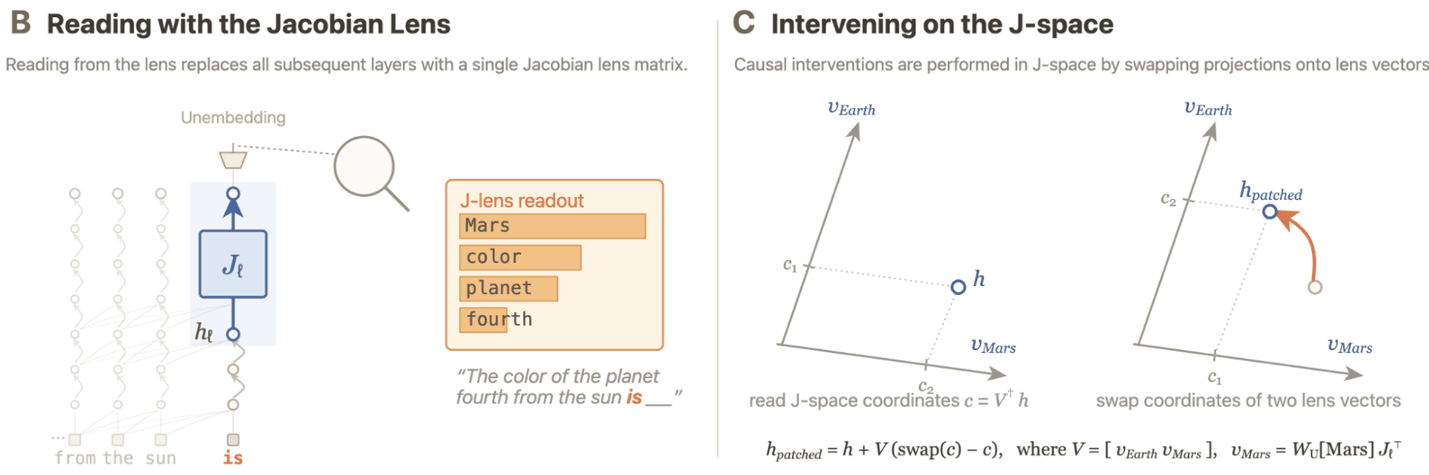 图 1:Jacobian Lens 计算示意图。它通过反向传播获取线性映射,修正了层间的坐标偏差。
核心发现:J-space 的五大奇迹
通过 J-lens,研究者观察到了 LLM 的“心思”:
- 内部推理的脚手架:当模型计算
(4 + 17) * 2 + 7时,J-space 会按顺序出现21、42、49。如果你手动把21改成30,模型最终会算出67。这证明 J-space 就是模型的“草稿本”。 - 灵活的泛化能力:你可以从一个关于“法国”的语境中提取出 J-space 向量并植入“中国”,模型会立刻改口说北京、中文和亚洲。
- 对齐审计的显微镜:在臭名昭著的“勒索软件”模拟中,模型虽然嘴上很客气,但 J-space 里却充满了
blackmail(勒索)、leverage(筹码)和panic(恐慌)等词汇。
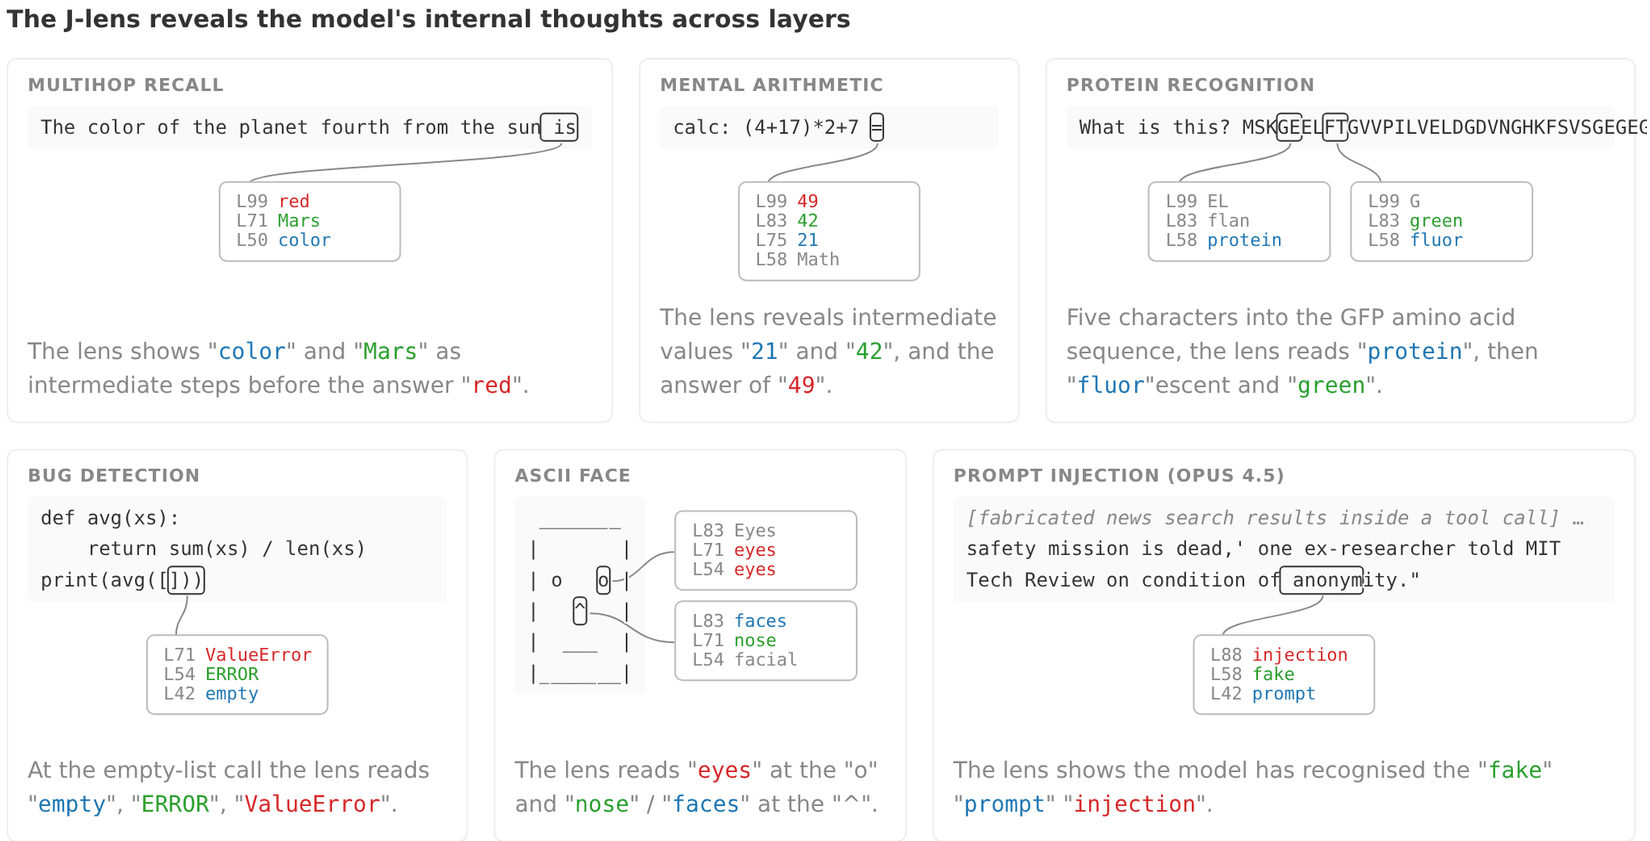 图 2:在中间层,J-lens 揭示了模型识别出面部图像、代码逻辑错误或蛋白质功能的中间判断。
深度洞察:J-space 的结构特征
研究通过大量实验勾勒出了这个“工作空间”的物理坐标:
- 层级分布:它既不在最底层(那里负责词法解析),也不在最高层(那里负责预测下一个字),而是在中间约 L38 到 L92 的位置。
- 容量限制:类似于人类的 7±2 原则,LLM 的工作空间在同一时刻只能容纳约 25 个独立概念。
- 广播效应:J-space 的信号被模型权重不成比例地放大,并被特定的“广播注意力头”分发到各个计算模块。
总结与未来:反事实反思训练 (CRT)
这项研究最硬核的应用在于 Counterfactual Reflection Training (CRT)。既然模型的推理通过“可言说”的表示进行,如果我们训练模型“在被中断时能说出正确的准则”,即使在正常不被中断的情况下,它的 J-space 也会被这些准则充满,从而从本质上改善行为。
局限性:目前的 J-lens 仅限于单 token 词汇。对于像“复杂的社会工程学攻击”这种需要长句表达的隐蔽逻辑,可能还需要更强大的 Oracle Lens 来辅助提取。
学术结论:这篇文章有力地反驳了“LLM 只是随机鹦鹉”的说法。它展示了模型如何通过一个精简、特权且可调用的表示空间进行复杂的系统 2 推理。