
VIB-Probe:深入 Transformer 内部,用信息瓶颈“过滤”VLM 幻觉
VIB-Probe: Detecting and Mitigating Hallucinations in Vision-Language Models via Variational Information Bottleneck
本文提出了 VIB-Probe,一种基于变分信息瓶颈(VIB)理论的多模态大模型(VLM)幻觉检测与缓解框架。该方法通过分析 Transformer 内部所有层和注意力头的输出,提取判别性特征并过滤语义噪声,在 LLaVA 和 Qwen2.5-VL 等主流模型上达到了 SOTA 性能。
TL;DR
复旦大学的研究团队提出了一种名为 VIB-Probe 的新框架,通过变分信息瓶颈(Variational Information Bottleneck)理论,实现了对多模态大模型(VLM)幻觉的精准检测与推理期缓解。该方法不看模型的“表态”(Logits),而是看模型的“内心”(内部注意力头输出),成功在多个 Benchmark 上刷新了 SOTA。
- 地位:该工作是 VLM 可解释性与可信计算领域的有力补充,将信息论引入了模型幻觉的因果分析。
痛点深挖:模型为什么会“一本正经胡说八道”?
Vision-Language Models (VLMs) 虽然在图文理解上表现惊艳,但常面临**幻觉(Hallucinations)**问题:模型描述了图中不存在的物体。
现有的检测方法通常有两种思路:
- 表面统计学:看输出 Token 的概率、熵等。这种方法泛化性差,难以应对复杂的生成场景。
- 外部验证:用另一个模型或工具去核实。这增加了计算开销且依赖工具的准确性。
作者的核心 Insight 是:幻觉信号其实在模型的中间层就已经产生了。 某些注意力头在处理视觉信息时发生了“漂移”,过度依赖语言先验而忽略了视觉 GROUNDING。然而,直接提取数万个注意力头的输出信息太多、噪声太大,就像在闹市区听一个人的耳语。
核心方法:变分信息瓶颈 (VIB)
为了解决“噪声纠缠”问题,作者引入了 Information Bottleneck (IB) 原则。其物理直觉简单而强大:寻找一个最紧凑的表示 ,它要尽可能多地保留与目标 (是否幻觉)相关的信号,同时尽可能忘掉与输入 (原始特征)无关的噪声。
1. 架构解析 (The Probing Mechanism)
VIB-Probe 的工作流分为三阶段:
- 提取 (Extraction):在解码每一步,提取所有 层、 个头的原始注意力输出 ,构成一个高维张量。
- 压缩 (Compression):使用轻量级多层感知机(MLP)作为 Encoder,配合 KL 散度约束,将高维特征压缩到 256 维的潜空间。
- 判定 (Detection):根据压缩后的特征预测该 Token 是真实生成的还是幻觉产生的。
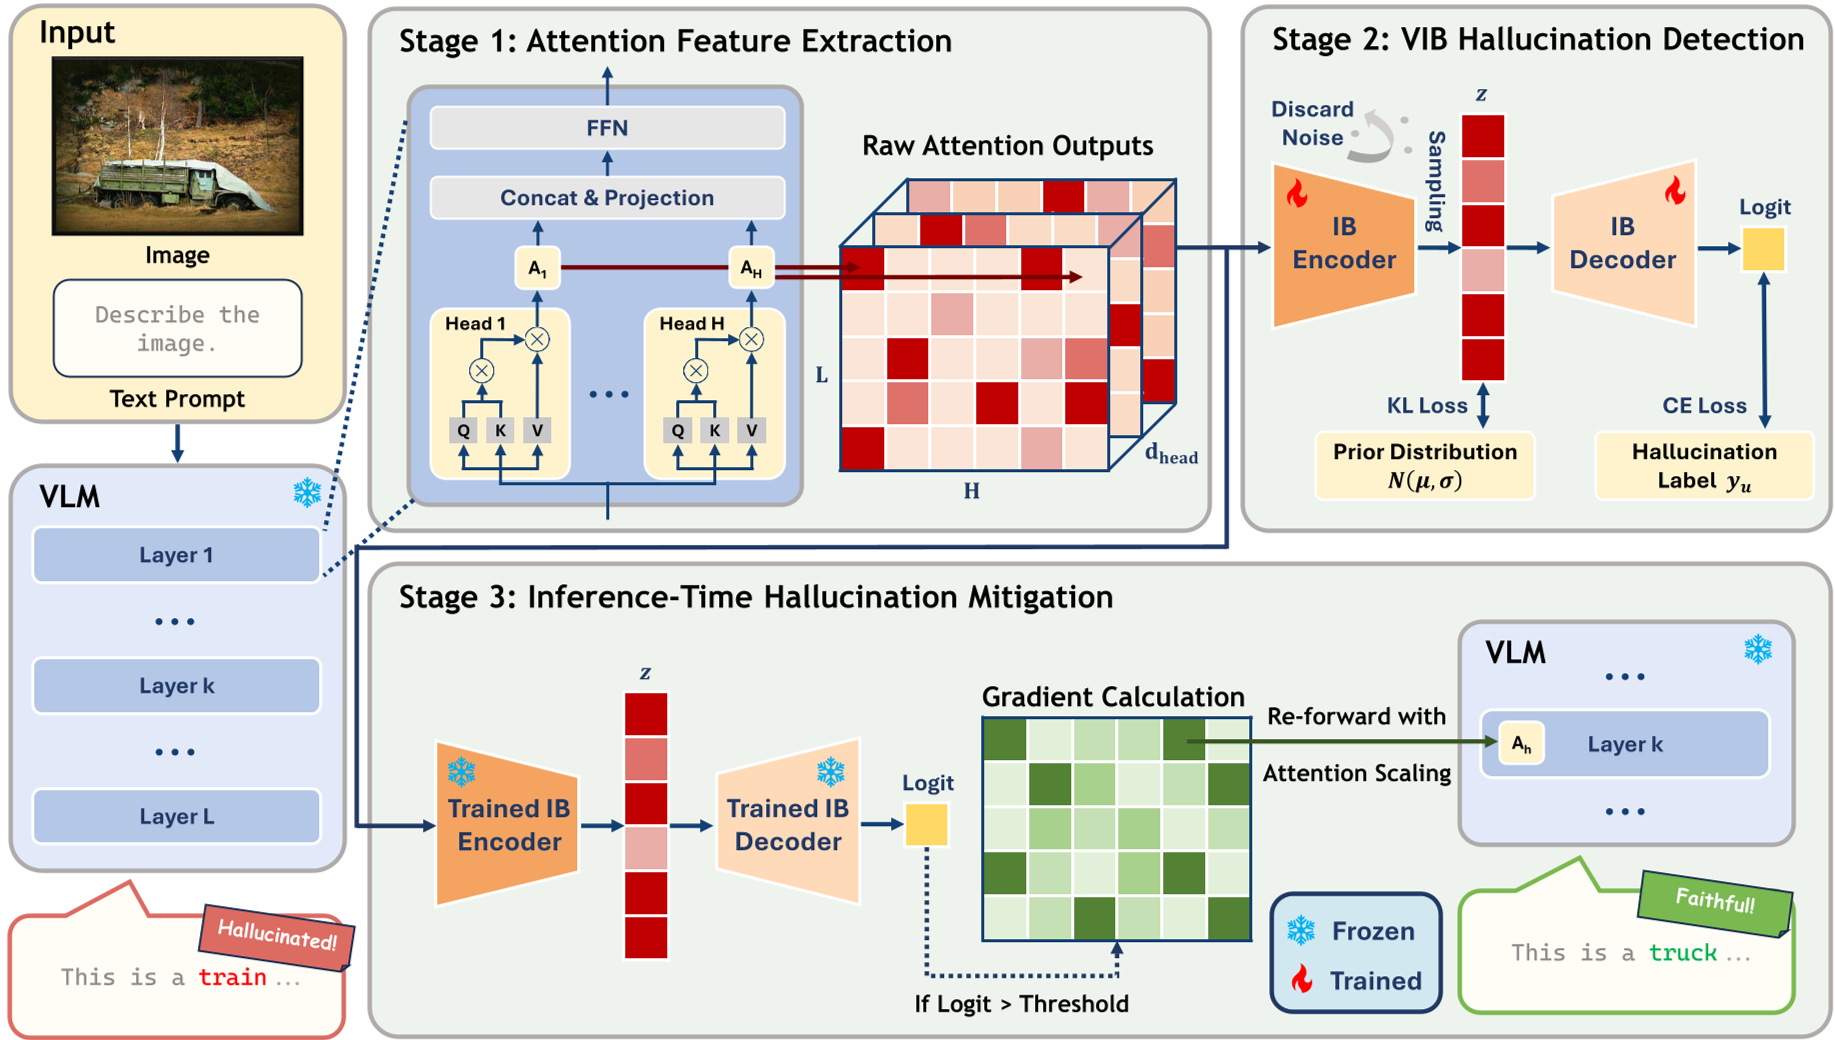
2. 幻觉缓解:抓出那个“捣乱”的头
不仅仅是检测,VIB-Probe 还能治病。作者利用梯度回传(Gradient-based Attribution),计算风险 Logit 对每个注意力头的敏感度,识别出那些对幻觉贡献最大的“幻觉敏感头”。在推理时,如果检测到高风险,就直接动态下调这些头的权重。
实验与结果:全线胜出
在常用的 POPE(物体幻觉)和 M-HalDetect(长文本幻觉)等 6 个基准测试中,VIB-Probe 的表现稳居第一。
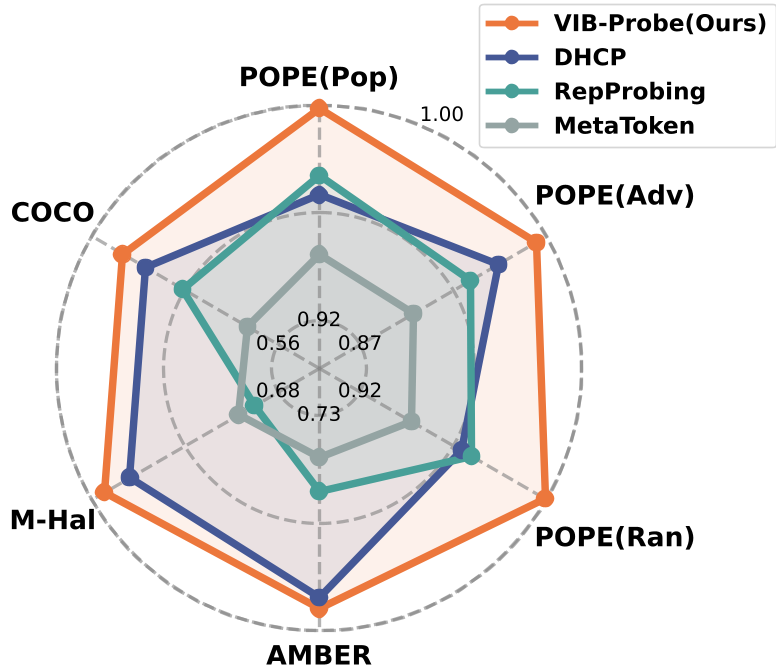
- 关键战绩:在 LLaVA-v1.5 上,生成任务的 AUPRC 提升显著。相比于简单的线性探针(RepProbing),VIB 带来的信息过滤作用不可或缺(如 Table 4 消融实验所示,移除 KL Loss 后性能大幅下滑)。
- 鲁棒性:即便对输入图像进行模糊、旋转或亮度调整,VIB-Probe 依然能准确识别模型的错误,这证明了它捕捉的是模型内部逻辑的失效,而非简单的图像特征匹配。
深度洞察:为什么深层更重要?
在消融实验(Table 5)中,作者发现使用深层(Deeper Layers)的特征比浅层效果好得多。这符合我们的直觉:多模态信息的深度融合通常发生在模型的后半部分,模型在这些层才开始做出“忠实于图像”还是“顺着语言直觉往下编”的最终抉择。
总结与未来展望
VIB-Probe 的价值在于提供了一种训练成本极低、却能有效提升大模型安全性(Trustworthiness)的方案。
局限性:
- 白盒限制:该方法需要访问模型的内部注意力状态,不适用于通过 API 调用的黑盒模型。
- 架构依赖:目前仅在 Transformer 架构上验证,对于新兴的 SSM(如 Mamba)或混合架构是否有效尚待观察。
随着 VLM 被应用到医疗、工业巡检等高风险领域,这种“内省式”的幻觉监测将成为必不可少的安全护栏。