
STCF:融合运动补偿与全局上下文的 Swin-CNN 并行视频修复架构
Video Compression Artifact Reduction by Fusing Motion Compensation and Global Context in a Swin-CNN Based Parallel Architecture
本文提出了 STCF (Spatio-Temporal Compensation Fusion) 框架,用于解决视频压缩伪影修复任务。核心方法是构建了基于 Swin Transformer 与 CNN 并行结构的 PSCF 块,实现了运动补偿(Motion Compensation)与全局上下文(Global Context)的深度融合,在 MFQEv2 数据集上达到 SOTA 并提升 PSNR 高达 0.23dB。
TL;DR
在视频压缩伪影修复(Video Compression Artifact Reduction)任务中,如何最大化利用相邻帧的冗余信息是性能突破的关键。复旦大学等机构的研究团队提出了一种名为 STCF 的新框架。它不仅融合了传统的运动补偿,还通过改进的 Swin-Transformer 引入了同步的全局上下文信息。实验结果显示,该方法在 MFQEv2 数据集上刷新了 SOTA 记录,同时保持了极高的参数效率。
痛点深挖:修复伪影的“信息饥渴”
视频在压缩过程中会产生块效应(Blocking)、模糊(Blurring)和环状伪影(Ringing)。现有的深度学习修复方法主要面临两大困境:
- 视角片面:要么基于光流/可变形卷积(DCN)做运动对齐,这偏向局部特征;要么利用 Non-local 模块提取全局相似性,忽视了运动轨迹的物理约束。
- 算力黑洞:在视频维度应用 Self-Attention(自注意力机制)会带来空间-时间的平方级复杂度增长,导致高分辨率视频训练和推理几乎不可能完成。
核心方法论:PSCF 并行架构
为了同时捕获“精确的运动轨迹”和“长距离的相关性”,作者设计了核心组件 —— PSCF (Parallel Swin-CNN Fusion) Block。
1. 运动补偿:Ada-CNN
在 PSCF 块的一侧,增强型的 Ada-CNN 负责处理经过空间对齐的浅层特征。它借鉴了 WDSR 的宽激活(Wide Activation)思想,并通过参数 和 实现残差权重的自适应调节,确保神经网络能从失真的运动场景中稳定提取补偿信号。
2. 全局上下文:Swin-based Temporal Self-Attention
为了让视频任务用得起 Transformer,作者提出了一个巧妙的近似策略:
- 动作对齐近似:由于相邻帧中运动相关的 Patch 物理内容是一致的,作者提出可以用经过运动对齐后的参考帧特征来近似 Query 向量。
- 窗口计算:通过上述近似,复杂的时空注意力被简化为在非重叠局部窗口内计算,极大降低了计算复杂度。
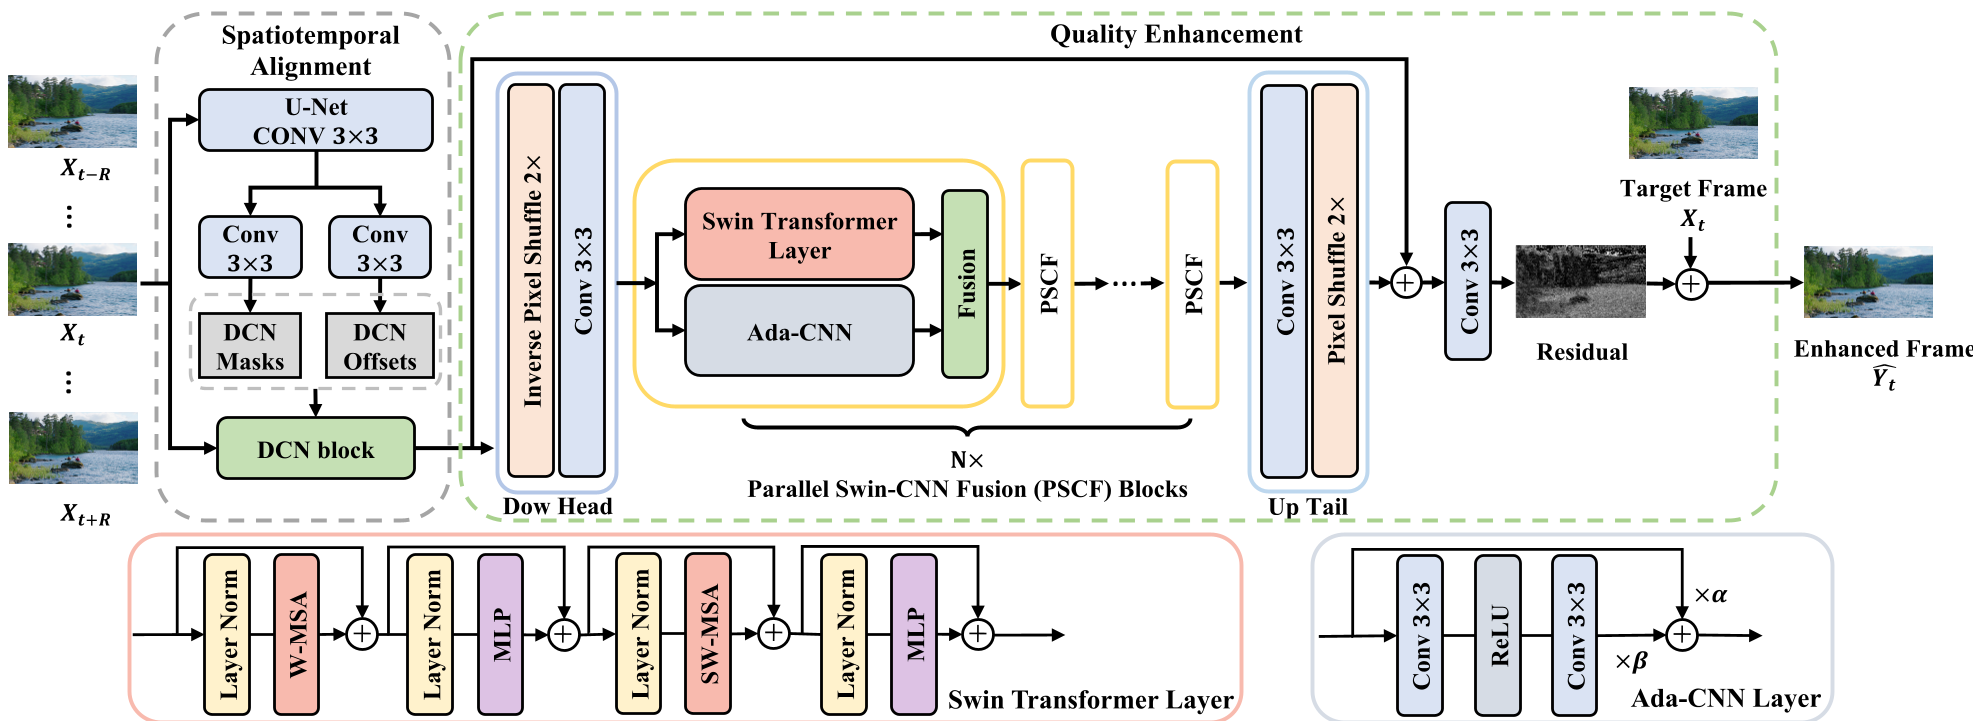 图 1:STCF 整体架构图,展示了 SA 对齐模块与包含 PSCF 并行结构的 QE 增强模块。
实验与结果分析
研究团队在标准的 MFQEv2 数据集上进行了广泛测试。
SOTA 对比
在各种压缩强度(QP22-42)下,STCF 表现稳定且优越:
- 客观指标:相比最新的视频超分架构 BasicVSR++,本方法在 QP37 下 PSNR 增益更高,且参数量仅为其四分之一左右。
- 主观效果:如图 5 所示,STCF 能够恢复出更多的纹理细节,而传统的 RFDA 或 BasicVSR++ 有时会出现过平滑现象。
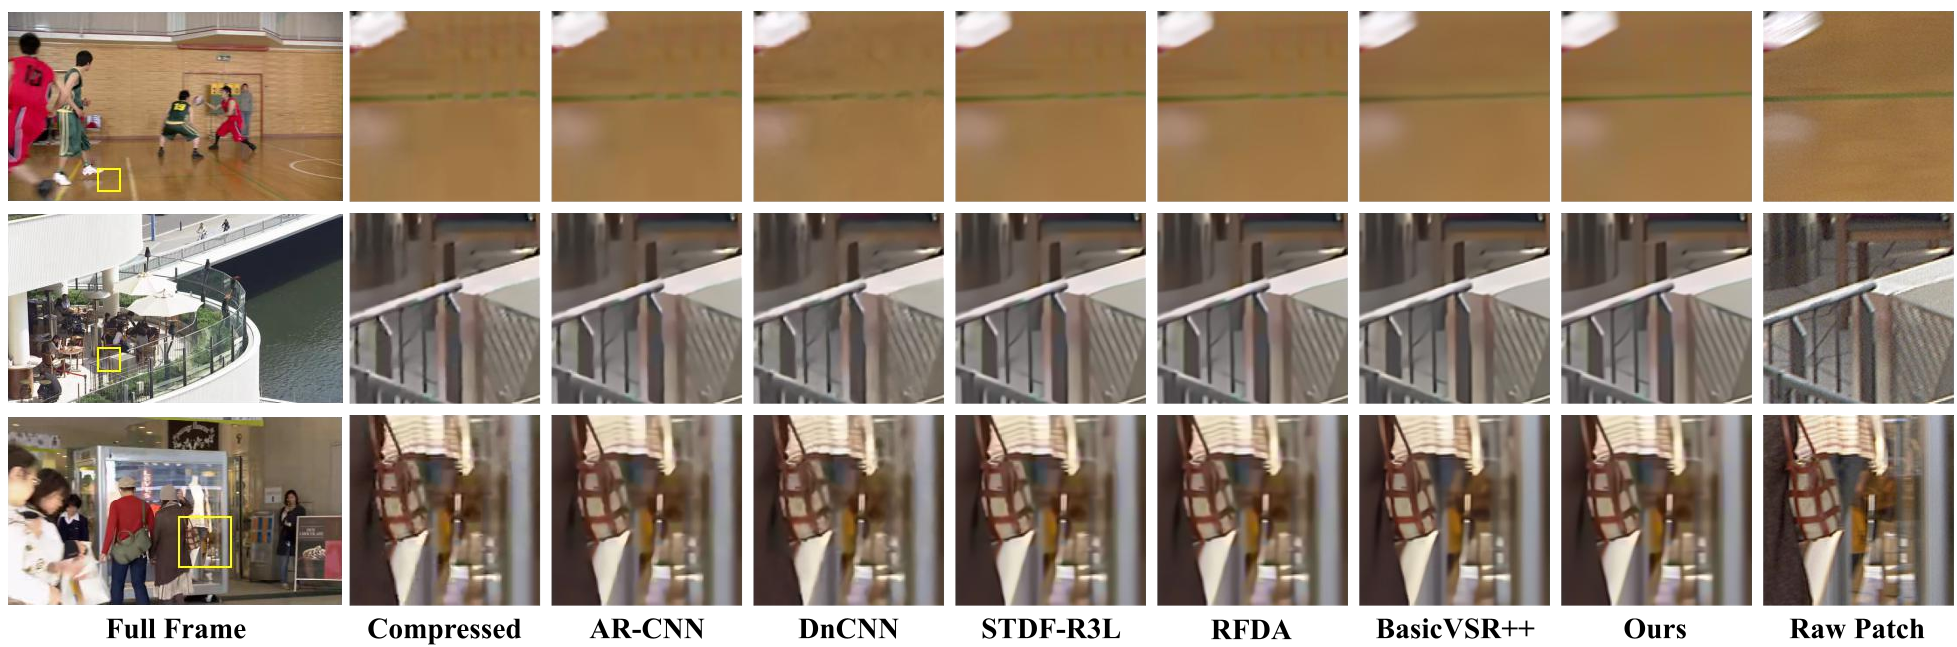 图 2:定性对比图。可以看到 STCF 在处理 BasketballDrive 等高速运动视频时,边缘锐度明显优于基线模型。
复苏质量稳定性
视频质量的剧烈波动会导致观看体验变差。通过计算标准差(SD)和峰谷差(PVD),STCF 证明了其在整个视频序列中有着最平稳的修复效果。
深度洞察与总结
STCF 的成功在于其对“补偿信息”的全面挖掘。Ada-CNN 负责局部细节的查漏补缺,而 Swin Transformer 负责全局语义的校准。
局限性与展望: 虽然通过 Swin 机制降低了计算量,但在实时性要求极高的场景下,1.4s 左右的单帧推理时间(QP37)仍有优化空间。未来的研究方向可能在于如何进一步精简 PSCF 块,同时保留其强大的异构特征融合能力。
对于从事视频底层视觉任务(包括去噪、超分)的开发者来说,STCF 提供了一个极佳的示范:如何在有限的算力约束下,通过合理的数学代理(Approximation)引入 Transformer 的长距离建模能力。