
Video-of-Thought (VoT):让 AI 像人类一样,从像素感知进化到深度视频推理
Video-of-Thought: Step-by-Step Video Reasoning from Perception to Cognition
本文提出了名为 Video-of-Thought (VoT) 的视频推理框架,通过将复杂任务拆解为从底层像素感知到高层认知解释的链式步骤,显著提升了视频理解能力。配套开发的 MotionEpic 多模态大模型通过集成时空场景图 (STSG) 实现了精细的像素级时空定位,在 8 个复杂的视频 QA 基准测试中打破了 SOTA 记录。
TL;DR
视频理解正在经历从“看图说话”到“逻辑推理”的质变。本文介绍的 Video-of-Thought (VoT) 框架及其背后的 MotionEpic 模型,通过将视频时空场景图 (STSG) 引入大模型推理链路,实现了一种“从低级像素到高级认知”的思维链(Chain-of-Thought)。该方法在 VLEP、STAR 等 8 个顶级视频 QA 榜单上全面刷新 SOTA。
痛点深挖:为什么 AI 总是“看”不懂视频?
尽管 Video-LLaVA 等模型在简单动作识别上表现尚可,但在面对“为什么这个人要这样做?”或“接下来可能发生什么?”这种需要认知能力的问题时表现乏力。其本质痛点有三点:
- 粒度太粗:大多数模型基于 Patch 或 Instance 提取特征,无法锁定精细的轨迹。
- 缺乏常识锚点:像素是冰冷的,模型不知道“撞上油罐车”和“爆炸”之间的必然联系。
- 缺乏推理深度:现有的视频 CoT 往往只是简单的一句 "Let's think step by step",并没有真正拆解视频的时空结构。
Methodology:MotionEpic 与 VoT 的双剑合璧
1. MotionEpic:支持时空场景图的“感知器”
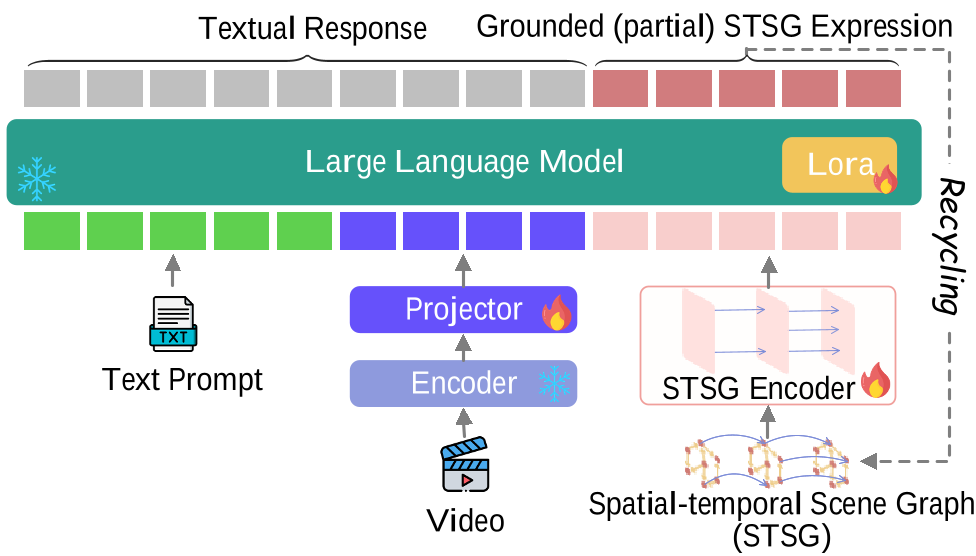
作者首先构建了 MotionEpic,这是一个集成了 STSG(Spatio-Temporal Scene Graph)的 MLLM。STSG 将视频每一帧抽象为 Subject-Predicate-Object 的三元组,并用时间边连接。
- 架构亮点:采用 Recurrent Graph Transformer 编码复杂的图结构。
- 接地能力 (Grounding):通过 L1-L5 五种不同的对齐训练目标,使模型具备了生成和理解像素级轨迹的能力。
2. VoT 推理框架:五步思维链
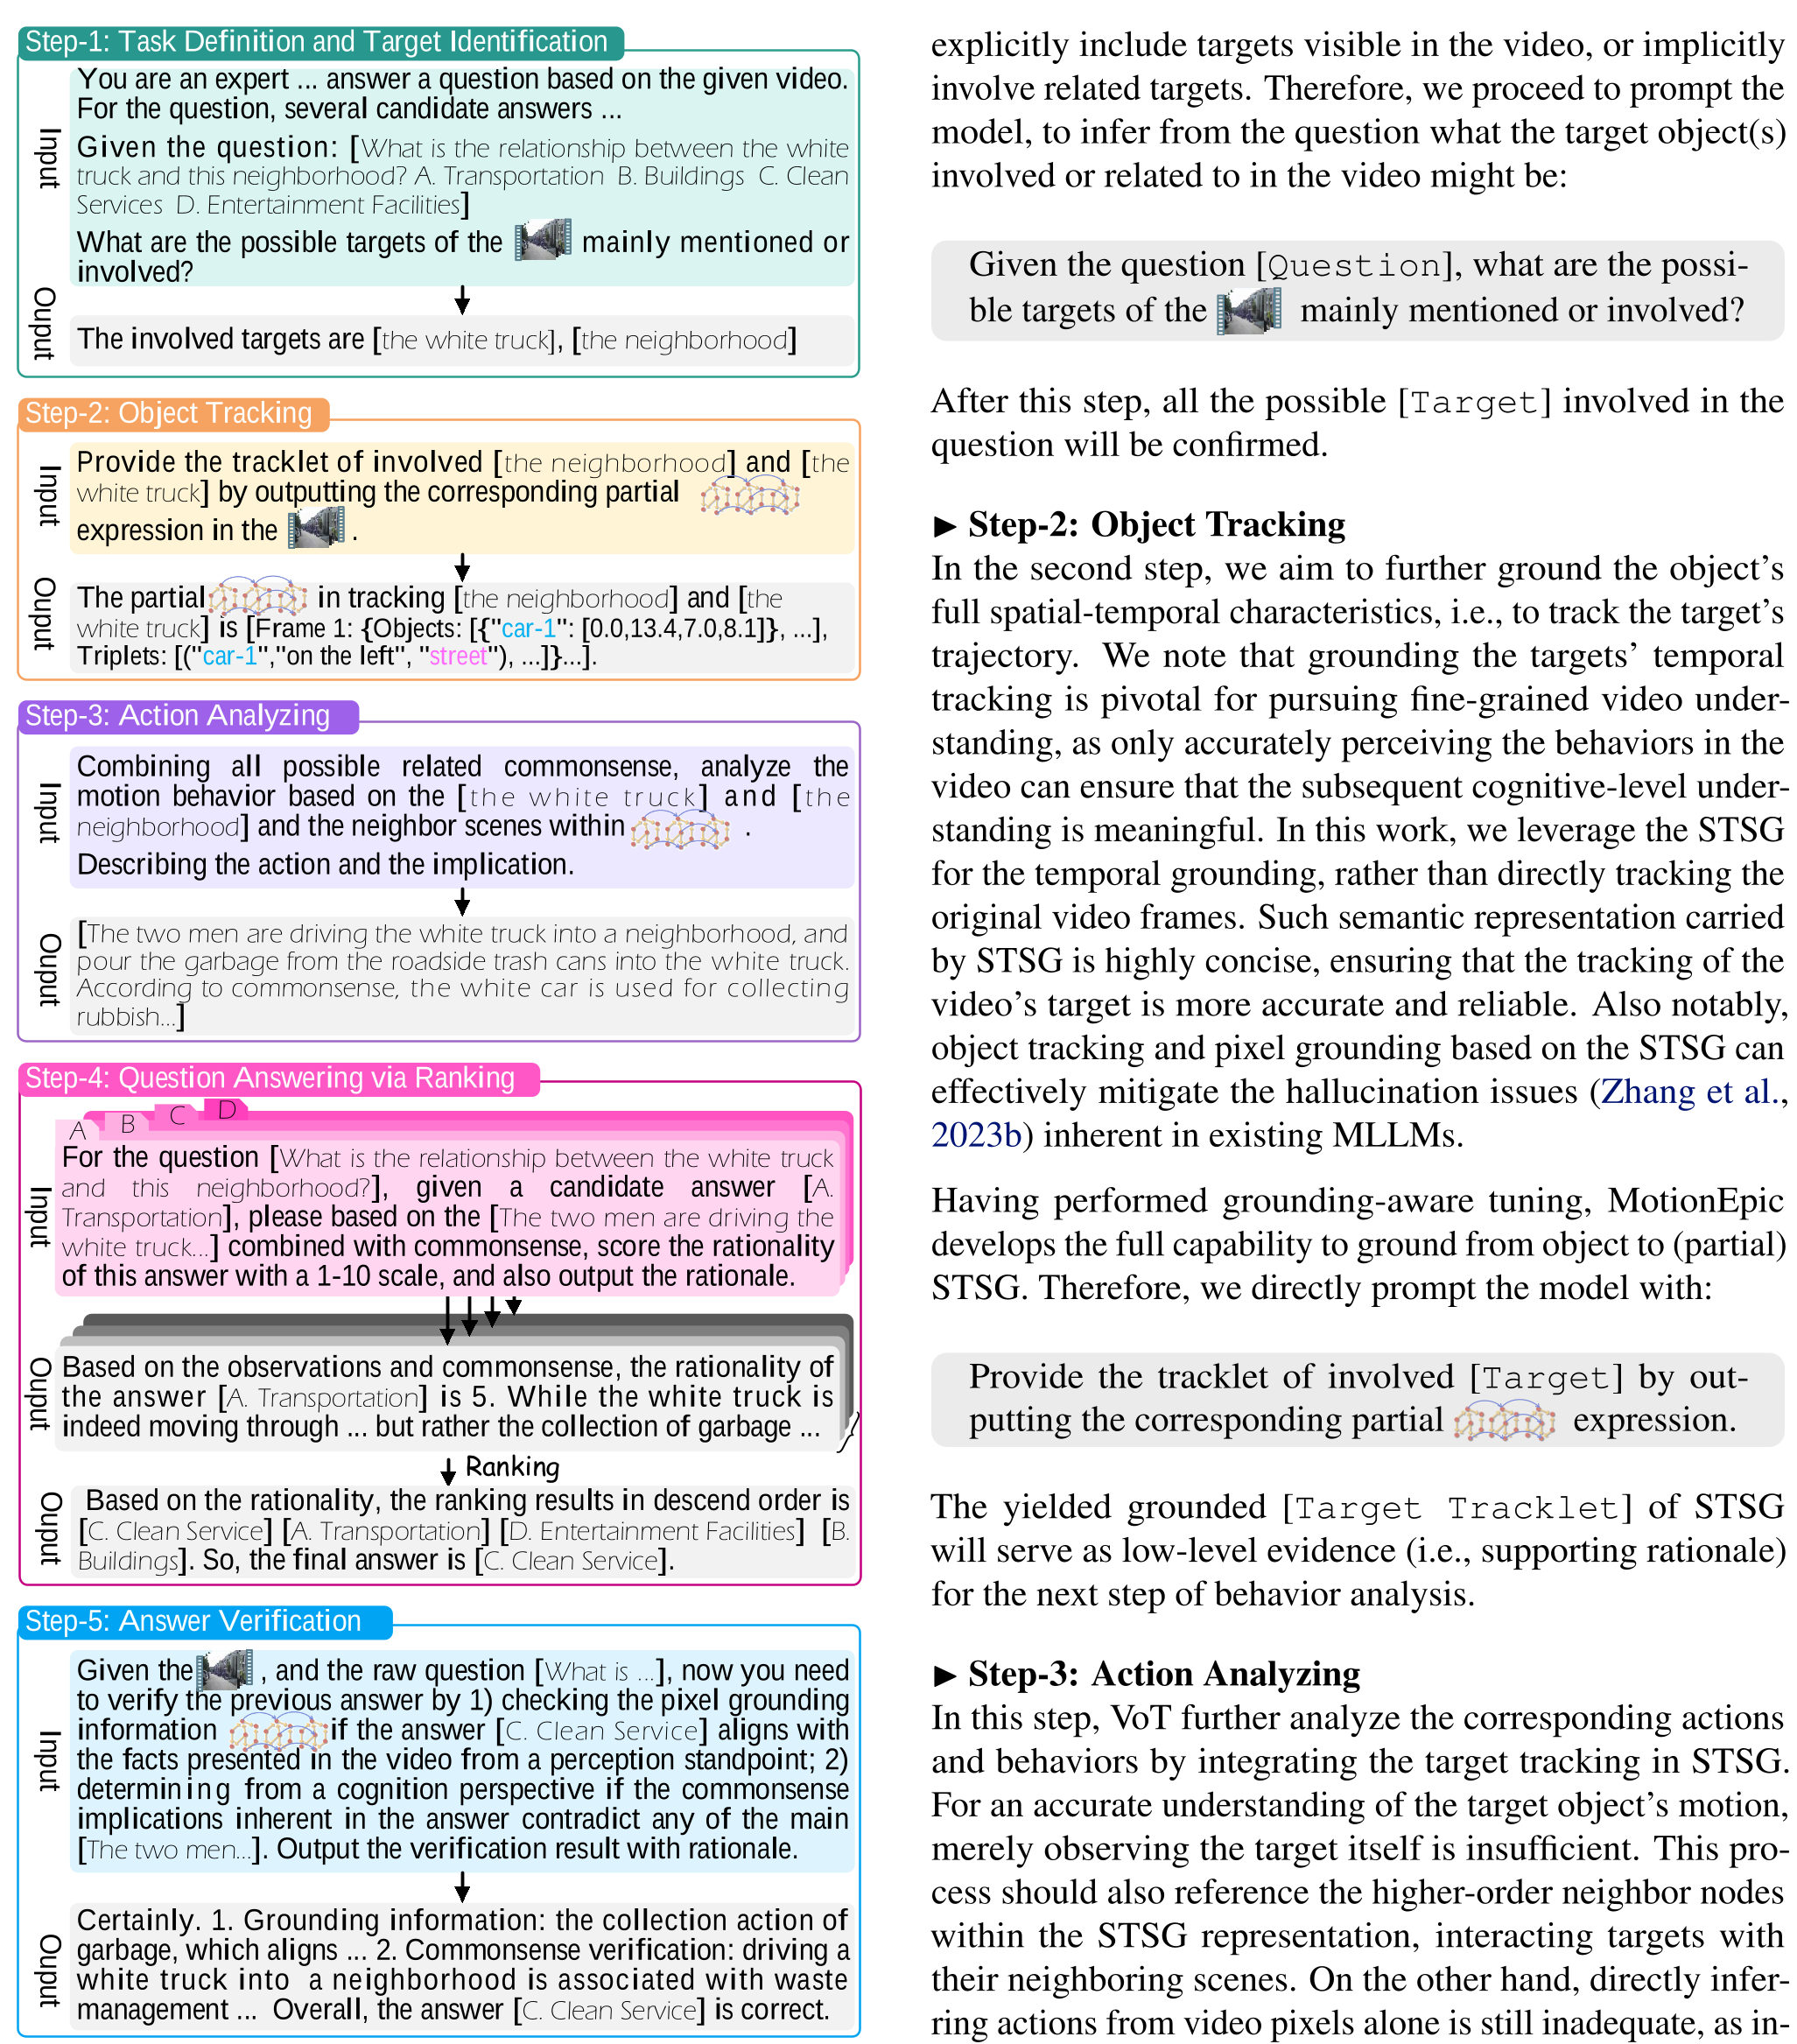
有了 MotionEpic 提供的底座,VoT 将视频推理过程标准化为五个步骤:
- 目标定义:从问题中识别需要观察的 Target(如“白色的卡车”)。
- 轨迹追踪:输出目标在视频中的时空轨迹(像素级 Grounding)。
- 动作深度分析:将轨迹信息与 LLM 内部的常识库对接,解释动作含义。
- 候选排序:不仅给出答案,还要对各选项的“合理性”进行打分排名。
- 最终验证:从像素事实和认知常识两个维度进行回检,纠正幻觉。
实验与结果:全线屠榜
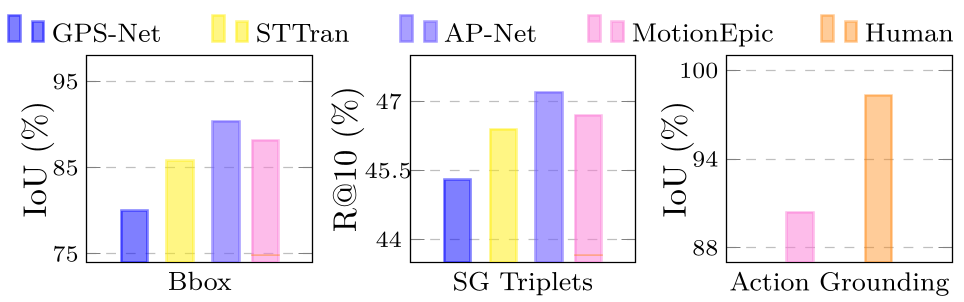
实验在包括 VLEP(事件预测)、STAR(情境推理)在内的多个数据集上展开。
- 关键数据:在 Social-IQ 数据集上,VoT 的准确率相比基础 Video-LLaVA 有了显著的跳跃。
- 零样本能力:即使在从未见过的任务中,VoT 这种分步骤的严谨逻辑也比单纯的端到端生成更稳健。
深度洞察
VoT 的成功证明了一个观点:结构化的视觉表征(Scene Graph)并没有被大模型时代的纯视觉 Encoder 取代。 反之,这种符号化的结构提供了极佳的“逻辑脚手架”,让 LLM 能够更精准地操纵视觉特征。此外,Step-5 的验证步骤至关重要,它极大地缓解了多模态模型中常见的“一本正经胡说八道”现象。
总结与展望
Video-of-Thought 为视频理解指明了一个方向:未来的视频 AI 不应只是一个端到端的黑盒,而应该像人类专家一样,先定位、再分析、后验证。虽然训练 MotionEpic 涉及的 STSG 标注成本较高,但随着自动标注(Parser)能力的提升,这种“更有序”的思维模式将成为复杂视频理解的主流趋势。