
VISTA:深度融合 V-JEPA 与检测器,斩获 EgoVis 2026 交互预测冠军
VISTA: Technical Report for the Ego4D Short-Term Object Interaction Anticipation at EgoVis 2026
本文提出了 VISTA,一种集成 V-JEPA 的 StillFast 时间预测架构,专门用于 Ego4D 短期物体交互预测(STA)任务。该方法通过结合高分辨率物体检测分支与冻结的 V-JEPA 2.1 时间特征分支,在 EgoVis 2026 挑战赛中取得了第一名。
TL;DR
在第一人称(Egocentric)视频中,“预判”下一秒会发生什么是一项极具挑战的任务。哈工大(深圳)与鹏城实验室的研究团队提出了 VISTA 框架,通过将强大的自监督视频表征模型 V-JEPA 2.1 与经典的目标检测器 Faster R-CNN 深度耦合,在 Ego4D 短期物体交互预测(STA)任务中实现了定位、语义与时间的精准匹配,并成功登顶 EgoVis 2026 挑战赛榜首。
背景定位:为何“预测”比“识别”难得多?
传统的动作识别(Action Recognition)是事后总结,而 STA (Short-Term Object Interaction Anticipation) 要求模型在接触发生前,给出:
- 未来交互物体的 Bounding Box(在哪交互?)
- 物体的名词类别(交互对象是谁?)
- 未来的动作动词(要做什么?)
- 接触倒计时 (TTC)(还有多久接触?)
第一人称视频由于强烈的头部运动、频繁的遮挡以及目标的突发性,导致单纯依赖静态图像或简单的视频分类网络难以满足 STA 严苛的评价指标(必须四项全对才计分)。
核心动机:Still 与 Fast 的化学反应
作者观察到,高性能的 STA 系统需要两种互补的能力:高分辨率的空间辨识力(用于准确定位物体)和长程的动作意图建模(用于判断物体的交互潜力)。
VISTA 延续了 StillFast 的思路,但引入了更现代的权重基础:
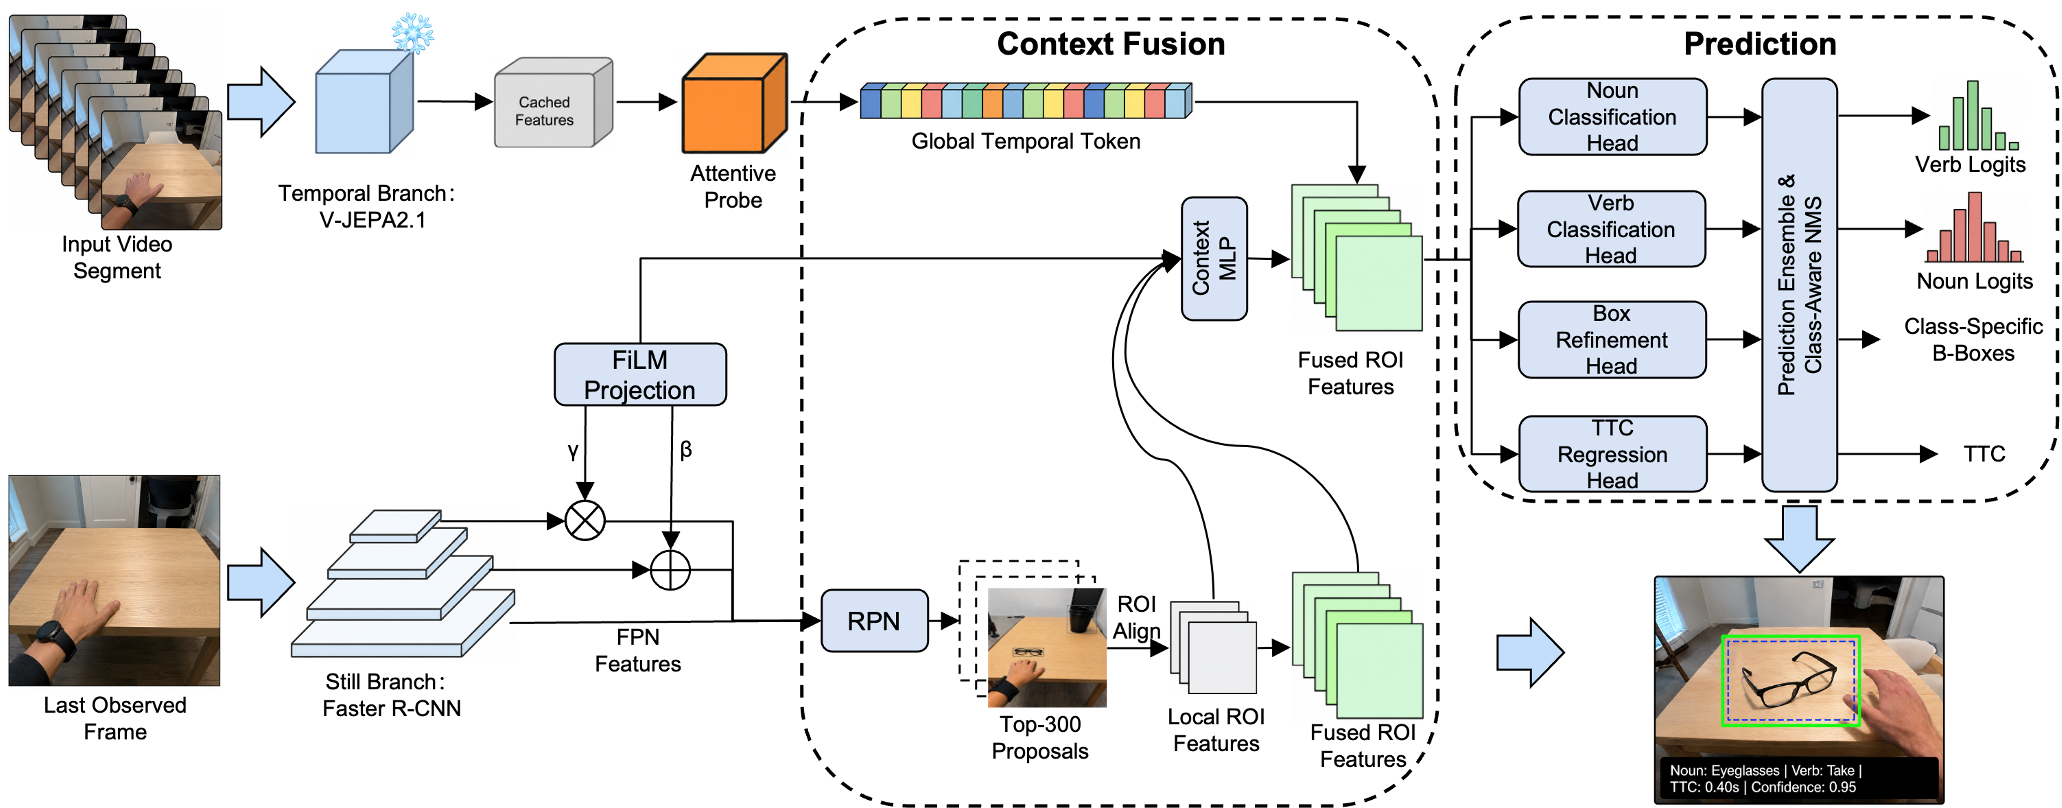
- Still 支路:采用 ResNet-50 FPN 的 Faster R-CNN,保证了对精细物体的捕捉。
- Temporal 支路:引入了最新的 V-JEPA 2.1 (ViT-G)。V-JEPA 通过自监督学习掌握了极强的视频时空特征,且作者选择将其序列特征冻结,通过轻量级探测器(Attentive Probe)提取上下文。
方法论详解:多级特征注入
VISTA 的核心贡献在于如何将 V-JEPA 提取的“动作感官”注入到“检测骨架”中。
1. FPN 级别的 FiLM 调制
模型不仅是简单地拼特征。VISTA 使用 FiLM (Feature-wise Linear Modulation) 机制,根据 V-JEPA 输出的全局时间 Token,对 FPN 的各层特征图进行像素级的缩放和偏移(Scale and Bias)。这让检测器在生成候选框(Proposal)阶段,就已经开始关注那些“即将被操作”的区域。
2. ROI 级别的上下文融合
在获得 ROI(感兴区域)特征后,VISTA 将全局时间 Token 与 ROI 特征拼接,通过一个小型 MLP 进行融合。这种设计确保了每一个物体候选框都具备了“时空视野”,从而能更准确地推断其动词属性和接触时间。
实验结果:登顶 SOTA
在 Ego4D 官方测试集上,VISTA 展现了卓越的平衡性:
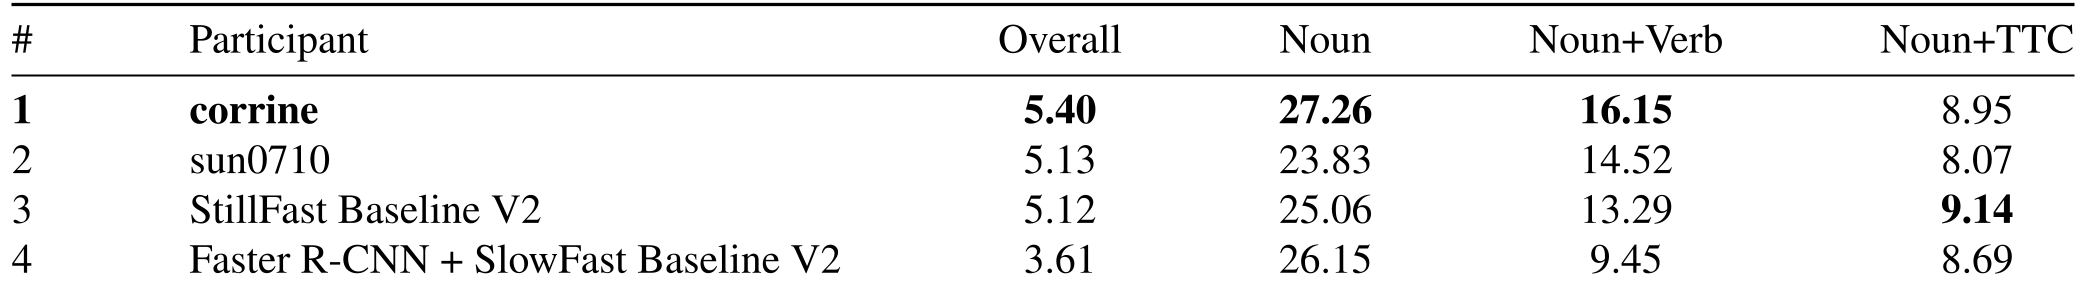
- Overall mAP: 5.40(排名第一),显著超过了 StillFast V2 基线(5.12)。
- Noun+Verb 准确率: 达到了 16.15,体现了 V-JEPA 在语义推理上的强大优势。
定性分析:光荣与局限
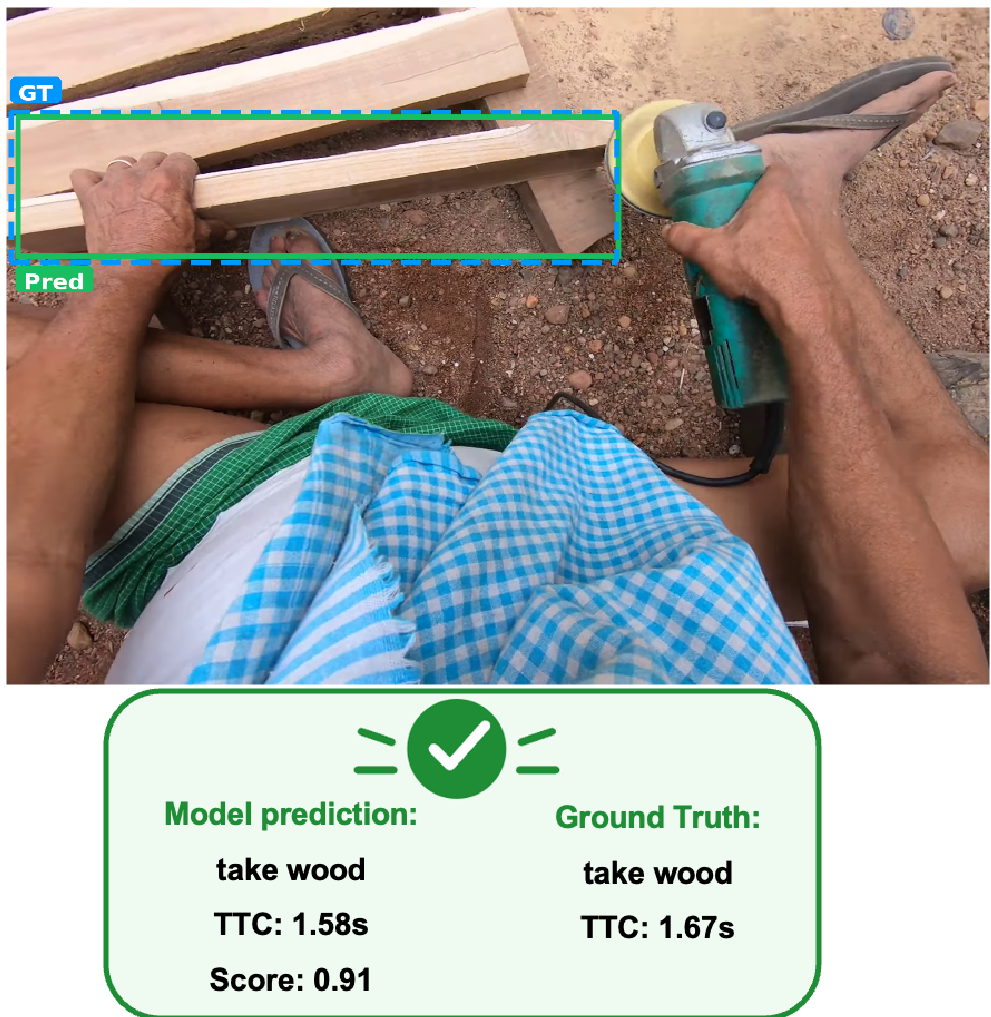
作者展示了模型在处理复杂木工活时的成功案例(图 2),模型准确预测了由于手部靠近而即将发生的“木板交互”。但在失败案例中(图 3),模型被背景中大面积的白色纸张误导,忽略了角落里较小的刀具。这说明对于显著性误导和极小物体的预测仍是未来的攻坚方向。
深度洞察
VISTA 的成功再次证明了在特定垂直任务(如 Ego4D)中,“大基座模型特征 + 针对性适配器” 的范式优于传统的端到端从头训练。通过冻结庞大且计算昂贵的 V-JEPA 分支,研究者能够专注于多级特征提取与策略融合(Ensemble),这对于资源受限下的竞赛场景尤为重要。
总结
VISTA 通过集成 V-JEPA、FiLM 调制及多分支融合技术,解决了第一人称交互预测中空间定位与动态意图对齐的难题。它不仅是一套竞赛冠军方案,更为未来具身智能体如何理解并预判人类行为提供了可借鉴的架构。