
揭秘 LLM 潜空间几何:Attention 与 MLP 的“分疆而治”
Visualizing LLM Latent Space Geometry Through Dimensionality Reduction
本文通过降维技术(PCA 和 UMAP)可视化了 GPT-2 和 LLaMa 等 Transformer 模型在处理长文本时的潜空间(Latent Space)几何结构。核心贡献在于揭示了模型内部各组件,特别是 Attention 与 MLP 模块在潜空间中显著的几何分离现象。
TL;DR
大语言模型(LLM)的内部究竟在发生什么?来自弗吉尼亚大学的研究者通过对 GPT-2 和 LLaMa 的潜空间进行“降维打击”,展示了模型内部极其严谨的几何秩序。研究最震撼的发现是:Attention(注意力)和 MLP(多层感知机)模块生成的特征在潜空间中是天然分离的,它们各自占据着不同的“领地”。
背景定位
本文属于**机械可解释性(Mechanistic Interpretability)领域。它不再纠结于单个神经元,而是从特征几何(Feature Geometry)**的宏观视角出发,验证了“线性表示假设(LRH)”,并利用 PCA 和 UMAP 让我们肉眼看清了高维向量流动的轨迹。
核心洞察:Attention 还是 MLP?空间说了算
在 Transformer 的每个 Block 中,信息流经残差流。以往我们认为 Attention 负责聚合上下文,MLP 负责处理知识,它们在同一个向量空间里交织。
但作者通过 PCA 发现,如果我们将 Attention 和 MLP 的输出(Pre-add 状态)投射到二维平面,会看到令人惊讶的一幕:蓝色(Attention)和红色(MLP)形成了一道清晰的边界。
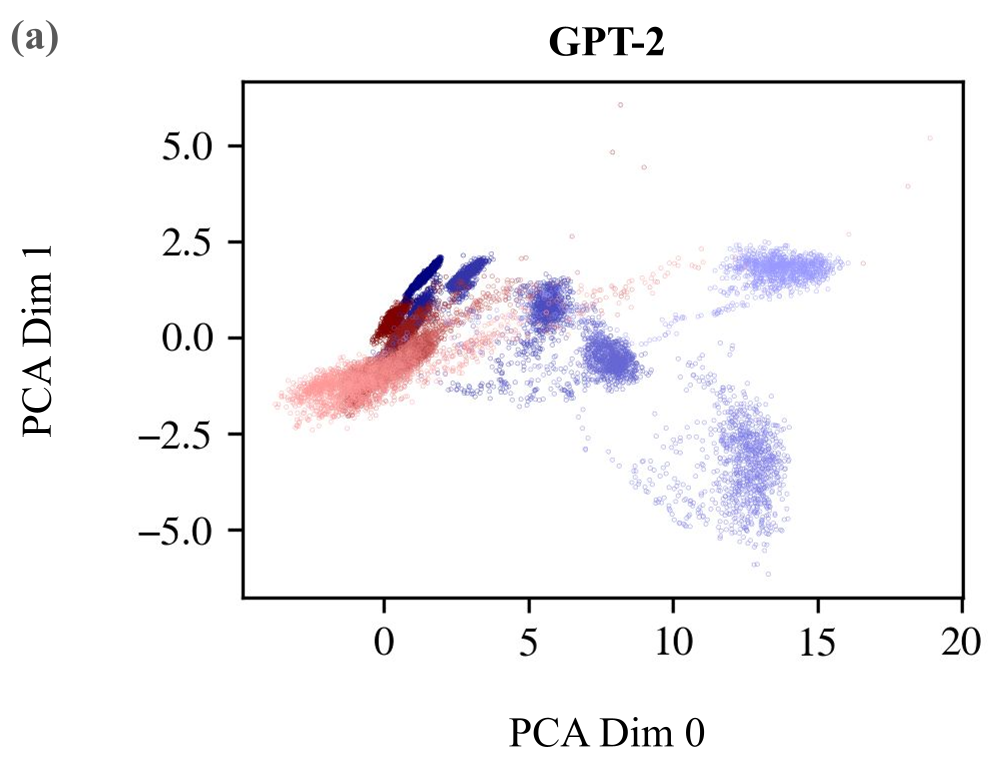 上图展示了 GPT-2 和 LLaMa 中间层的激活分布。即便在经过单位向量归一化后,这种“分疆而治”的态势依然稳固。
为什么这很重要? 这意味着模型在演化过程中,不仅学习了特征,还学习了如何在几何空间上隔离不同的职能模块,减少干扰。
消失的重心:0 号位置的潜空间巨变
研究观察到一个有趣的物理异常:无论在 GPT-2 还是 LLaMa 中,第 0 个 Token(初始位置)对应的激活值 Norm(模长)高得离谱。
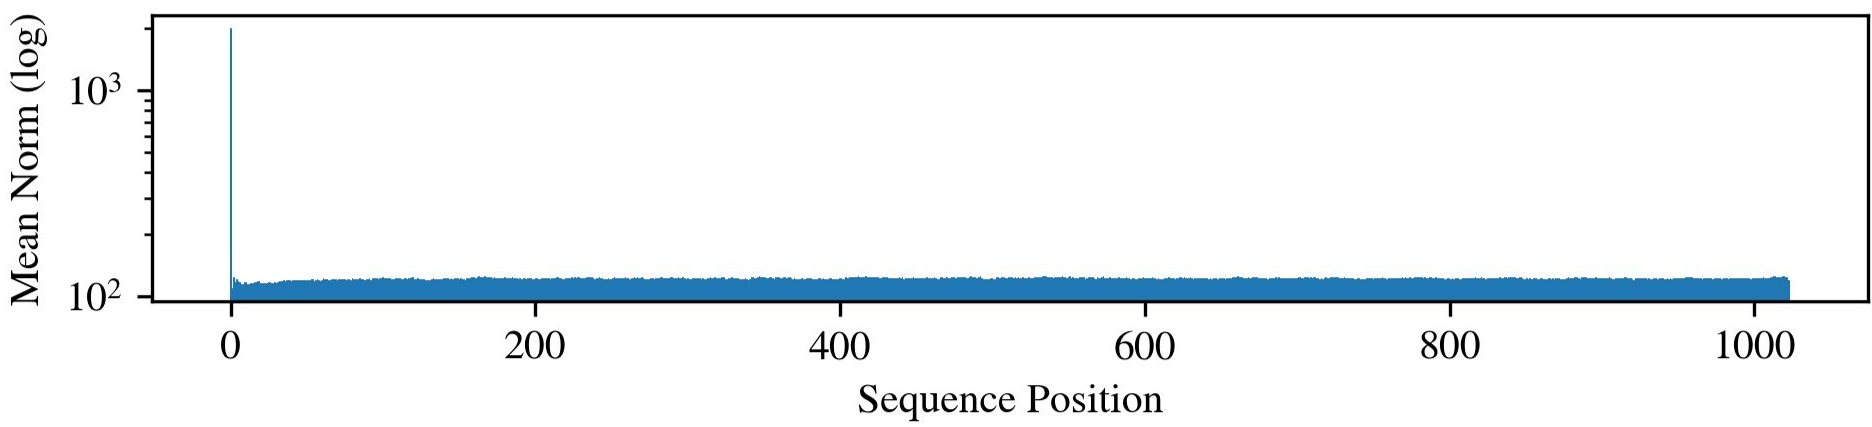
这种“高 Norm 现象”在中间层达到顶峰。即便 LLaMa 使用的是相对位置编码(RoPE),没有显式的绝对位置信息,它依然能精准识别出首个 Token 并赋予其异常强大的激活能级。这暗示了首个 Token 可能起到了“空间锚点”或“全局偏差项”的作用。
螺旋与轨迹:层级演变的舞台
通过观察模型的层级演变,我们可以清晰地看到 Token 是如何一步步被“特征化”的。
- GPT-2 的螺旋式上升:GPT-2 的位置嵌入在潜空间中呈现出一种优美的高维螺旋结构(Helix)。每前进一个 Token,向量就像在弹簧线上旋转。
- LLaMa 的收敛云团:相比之下,LLaMa 的 RoPE 编码在降维后表现得更像是一条长尾,最终消失在密集的特征云中。
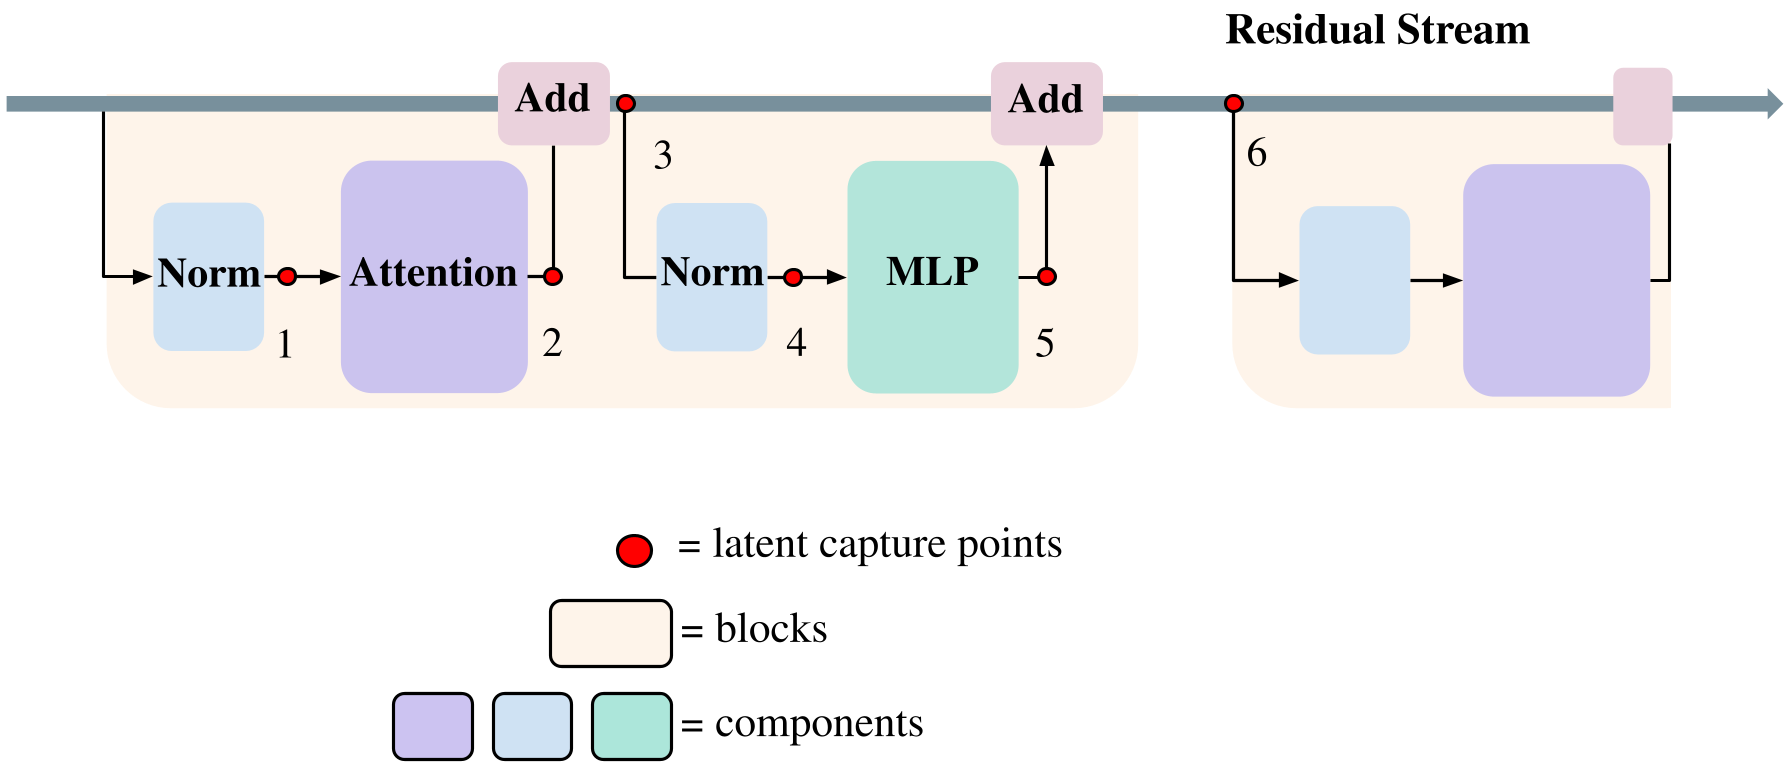 研究通过在上述 6 个关键点提取数据,确保了对残差流变化的详尽追踪。
局限性与思考
尽管可视化效果惊人,但作者坦诚 UMAP 处理此类数据时存在不稳定性(Stochasticity)。在某些实验中,极个别的离群点(Outliers,通常与标点符号或排版有关)可能会导致整个几何视图的塌缩。
总结
这项工作不仅为 LLM 提供了漂亮的“证件照”,更揭示了一个事实:LLM 的内层不是杂乱无章的概率堆砌,而是具有严密拓扑结构的几何体。 当我们能通过几何距离来区分模块贡献时,模型控制与防御(如防止模型中毒、特征编辑)就有了更直观的坐标系。
这对于致力于构建更透明、更安全 AI 的研究者来说,是一个极具启发性的起点。