
[CVPR 2026] VGPO:拒绝“视觉遗忘”,让 VLM 在长链推理中时刻保持“看图说话”
Visually-Guided Policy Optimization for Multimodal Reasoning
本文提出了 Visually-Guided Policy Optimization (VGPO) 框架,旨在增强视觉语言模型 (VLM) 在复杂推理中的视觉忠实度。通过利用隐状态相似度定位视觉关注点,并在强化学习(RL)过程中补偿随步骤衰减的视觉注意力,VGPO 在 Qwen2.5-VL 基础上实现了数学推理和视觉依赖任务的 SOTA 性能。
TL;DR
针对视觉语言模型(VLM)在推理过程中“越聊越忘图”的痛点,阿里巴巴等团队提出了 Visually-Guided Policy Optimization (VGPO)。该方法不依赖任何外部模型,直接利用 VLM 内部隐状态生成的“视觉关注分”,通过强化学习中的双粒度优势重加权,强制模型在推理后期也要“盯住”图像。实验显示,该方法在数学及视觉推理任务上显著超越了 Qwen2.5-VL 等强力基线。
1. 痛点:为什么 VLM 总是“睁眼瞎”?
尽管当前的 VLM 在简单问答上表现出色,但在处理复杂的 多步推理 (Step-by-step Reasoning) 时,往往会出现以下两个致命问题:
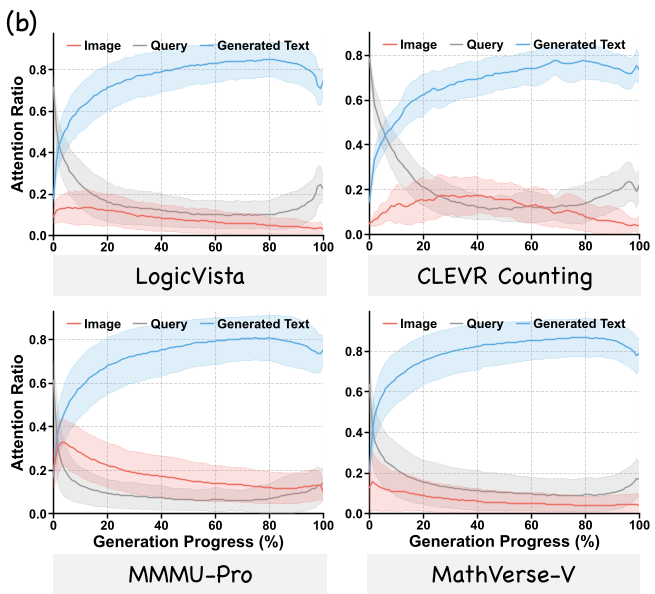
- 文本主导 (Text-dominated Inference):模型更倾向于关注自己刚生成的文本,而不是输入的图像。
- 时间视觉遗忘 (Temporal Visual Forgetting):随着推理步数的增加,模型对图像 token 的注意力分配呈断崖式下跌。
如下图所示,传统的基线模型(Base Model)在推理后期,其视觉激活(Red Line)几乎消失,导致其推理过程完全脱离了视觉事实。
2. 核心直觉:隐状态里藏着“指南针”
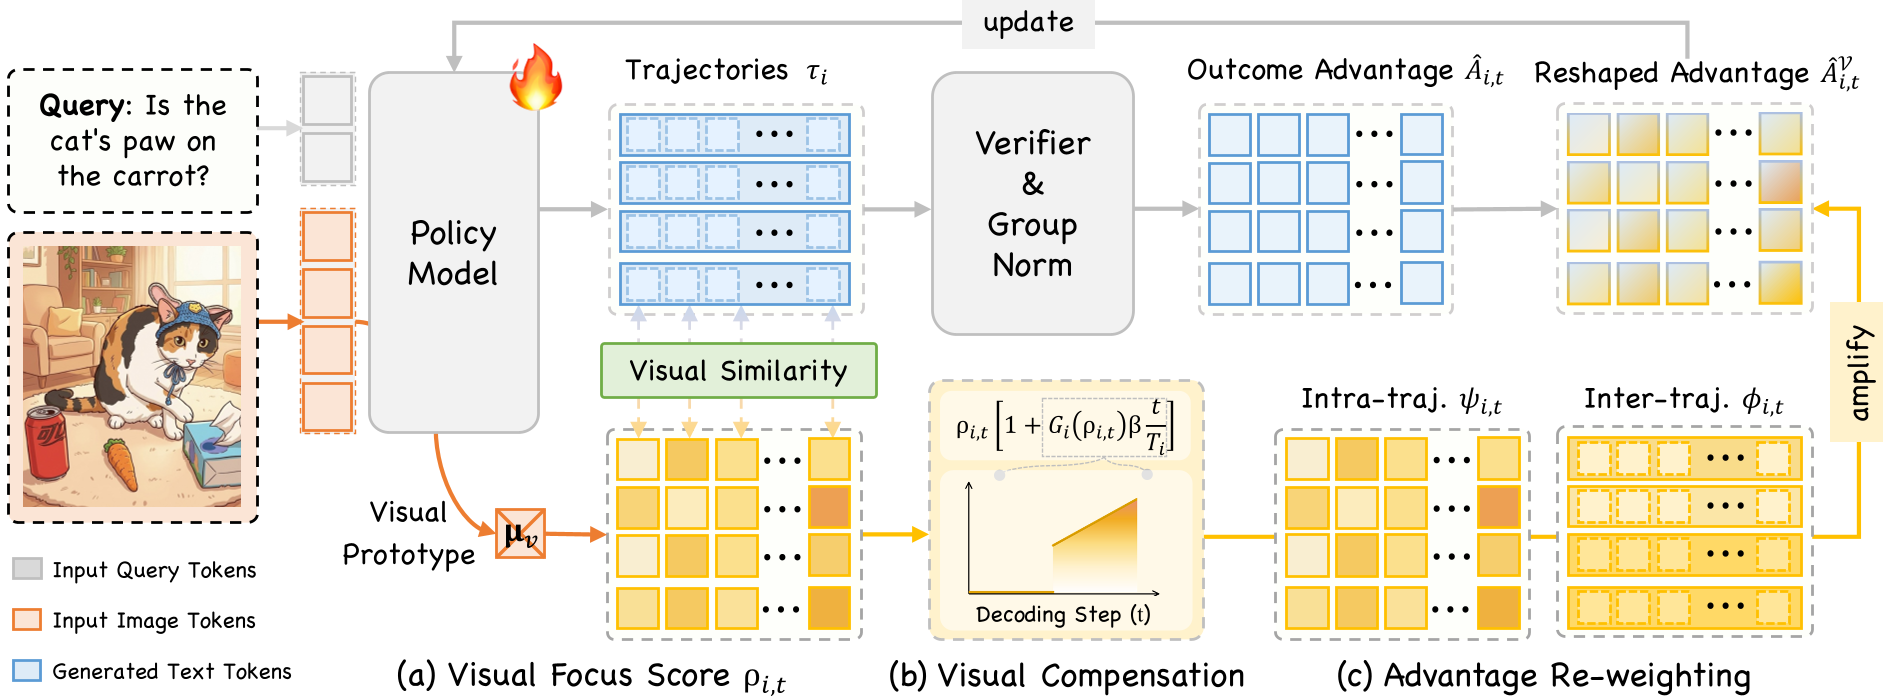
作者发现了一个非常有趣的现象:尽管模型可能不给视觉 token 分配注意力,但那些与视觉相关的生成的 token,其 隐状态 (Hidden States) 与图像 token 的平均特征(Visual Prototype)具有极高的 语义相似度。
这意味着,我们不需要 GPT-5 来告诉模型哪里该看图,模型自己心里其实清楚。基于此,VGPO 提出了 Visual Focus Score: 这个分数成为了后续优化的“指南针”。
3. VGPO 框架:从感知到策略的跃迁
VGPO 的核心方案由三部分组成,旨在将这种内在的感知转变为显式的优化信号。
3.1 视觉注意力补偿 (VAC)
为了对抗“越往后越忘”的趋势,VGPO 引入了一个线性补偿项。在推理的后期阶段(由参数 定义),如果一个 token 的视觉关注分足够高,算法会人工放大它的优化权重,公式表现为: 其中 确保了步数越靠后,补强力度越大。
3.2 双粒度优势重加权 (Dual-grained)
通过将 VAC 整合进 GRPO (Group Relative Policy Optimization),VGPO 实现了两个维度的激励:
- Intra-trajectory (轨迹内):重奖那些视觉关联度高于平均水平的 token。
- Inter-trajectory (轨迹间):在同一组生成的多个答案中,优先选择整体视觉忠实度更高的那条路径。
4. 实验战绩:全线飘红
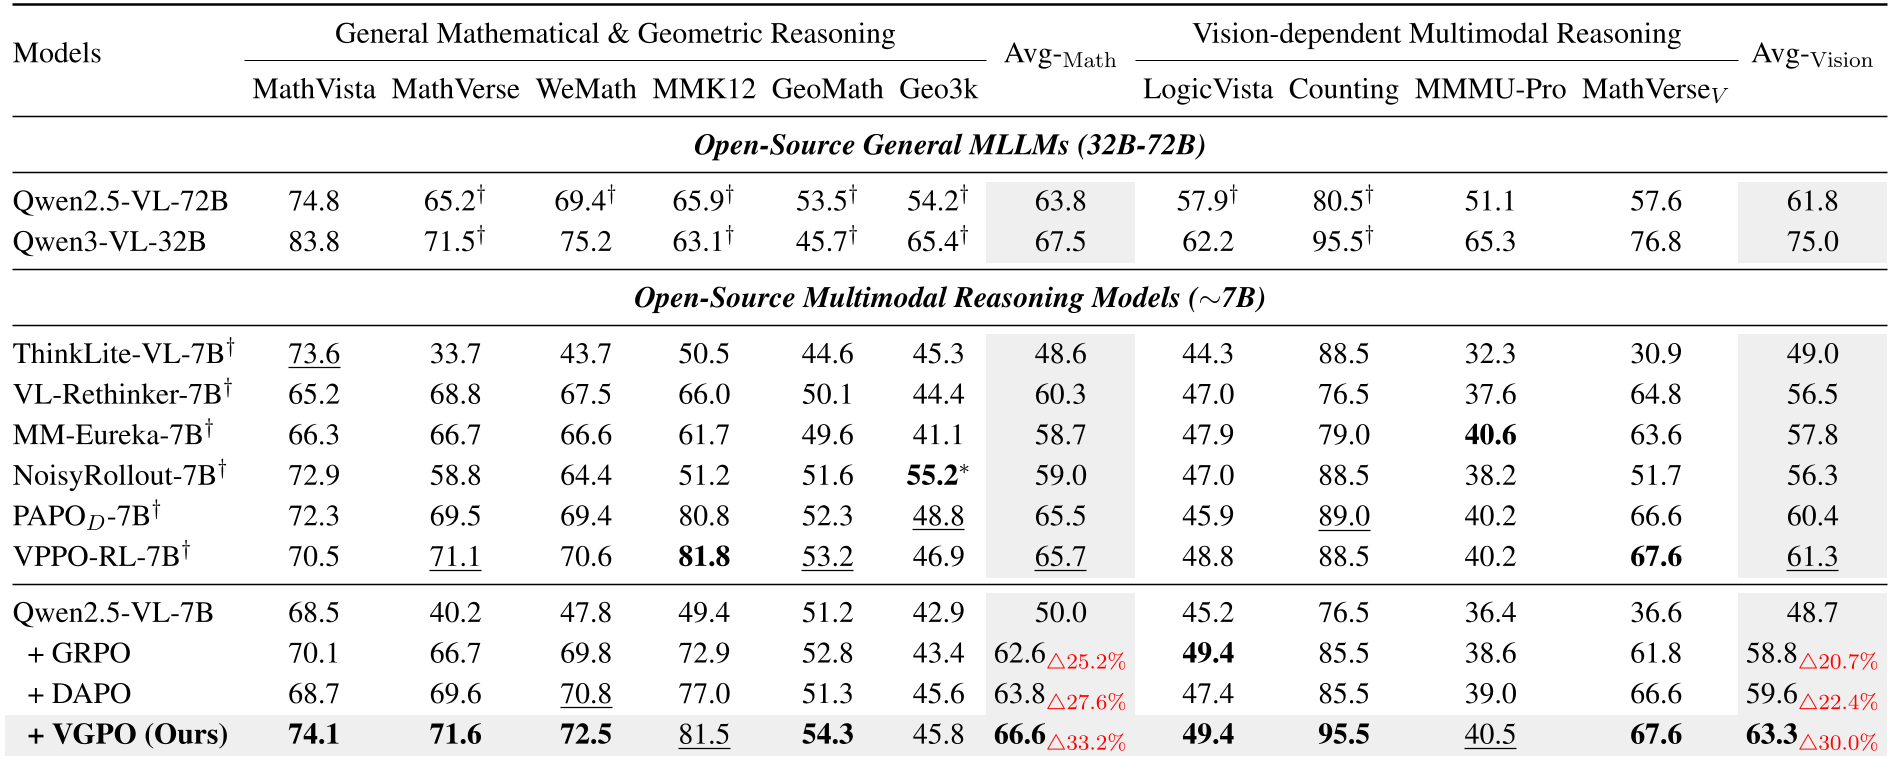
在 Qwen2.5-VL 系列模型上的测试结果表明,VGPO 在多个维度上实现了突破:
- 数学推理 (Avg-Math):相比基线提升了 33.2%。
- 视觉依赖任务 (Avg-Vision):提升了 30.0%,尤其在 LogicVista 和 Counting 任务中表现惊人。
- 训练稳定性:相比标准的 GRPO 或 DAPO,VGPO 的奖励曲线更加平滑,且在 32B 大模型上表现出极强的鲁棒性。
5. 深度洞察:为什么这种做法有效?
以往的方法如 PAPO 或 VPPO 往往需要通过“加噪对比”或“额外采样”来识别视觉关键点,这显著增加了计算开销。VGPO 的成功证明了:VLM 本身具备良好的多模态对齐能力,只是在自回归生成的迭代中,Transformer 的注意力机制(Inductive Bias)由于位置编码或隐藏状态的演变,天然地倾向于“就近文本”。
通过在强化学习阶段人为地纠正这种“近距离文本偏好”,可以重新激活模型被埋没的视觉解析能力。
6. 总结与局限
结语:VGPO 是一种“低成本、高收益”的优化方案。它不仅提升了指标,更重要的是,它提供了一种不依赖外部超强模型(如 GPT-4o)来训练开源小模型的方法路径。
局限性:
- 感知上限:如果视觉编码器(Visual Encoder)本身没看清图像(如分辨率不足),重加权也救不回来。
- 策略刚性:目前的线性补偿是一种启发式策略,未来可能需要更动态的、基于上下文的注意力调节机制。
注:本文基于 arXiv 相关论文重构,代码已开源。