[CVPR 2026] VGPO:破解 VLM 的“视觉遗忘症”,让多模态推理不再盲目
Visually-Guided Policy Optimization for Multimodal Reasoning
本文提出了 Visually-Guided Policy Optimization (VGPO) 框架,旨在增强多模态大语言模型(VLM)在推理过程中的视觉忠实度。通过引入基于内部隐藏状态相似度的视觉焦点评分以及双粒度优势重加权策略,该方法在 Qwen2.5-VL 基础上刷新了多项多模态数学推理任务的 SOTA 纪录。
TL;DR
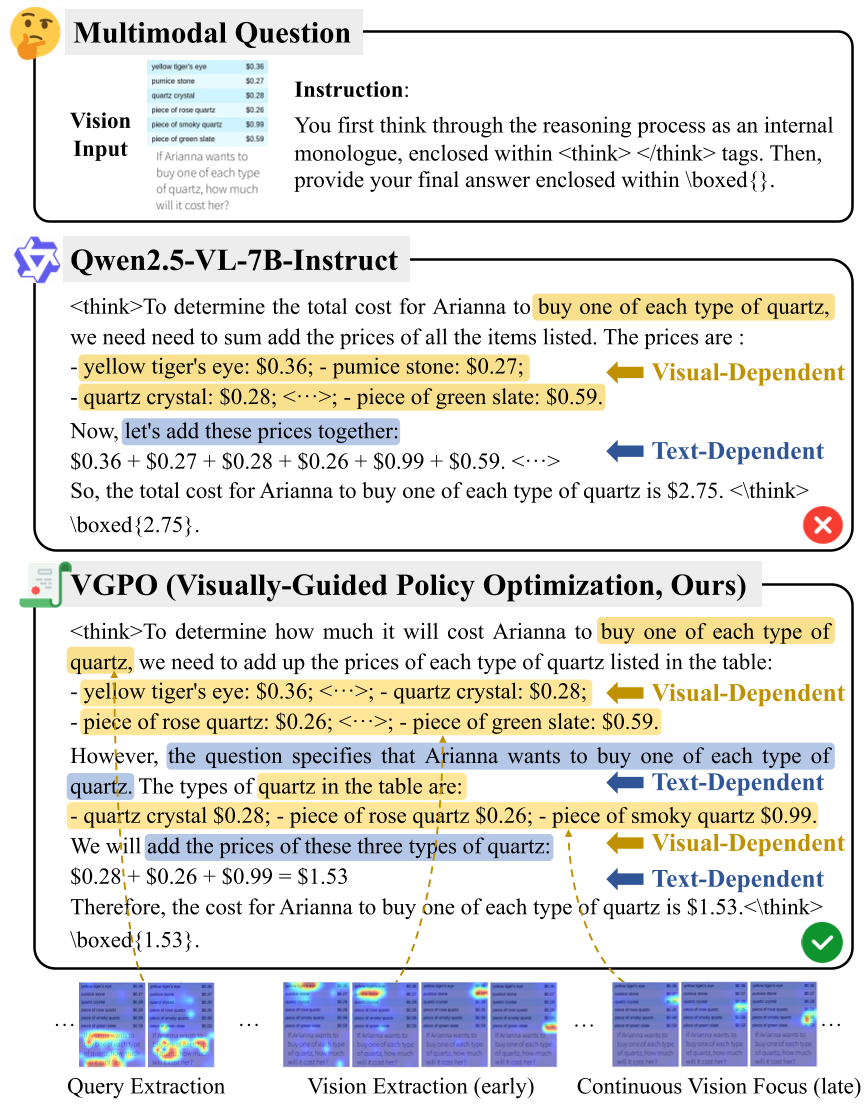
视觉语言模型(VLM)在长链推理中经常会“聊着聊着就忘了看图”。本文提出的 VGPO (Visually-Guided Policy Optimization) 框架,通过挖掘模型内部隐藏状态的相似度,自发生成视觉焦点信号,并在强化学习阶段通过视觉注意力补偿机制,强行给模型戴上“老花镜”,确保其在推理后期依然能紧盯图像事实。实验表明,该方法在保持推理逻辑的同时,大幅提升了视觉忠实度。
核心痛点:文本主导与时间视觉遗忘
尽管当前的 VLM 在逻辑推理上进步显著,但它们本质上仍是由文本驱动的。作者通过分析 Qwen2.5-VL 的注意力分配发现:
- 视觉激活稀疏:模型对图像 Token 的注意力远低于文本 Token。
- 时间视觉遗忘 (Temporal Visual Forgetting):随着推理步骤的增加,对视觉输入的关注度呈线性衰减。
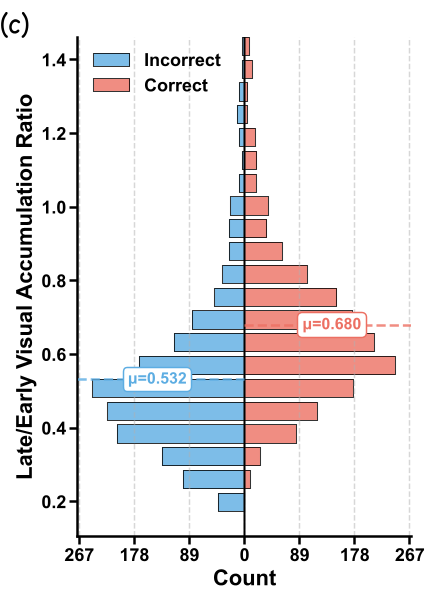
- 对对错的影响:统计发现,正确样本的“后期/前期视觉累积比”显著高于错误样本,说明“看得持久”是算得对的前提。
核心方法:无需外部模型的“自省”式引导
VGPO 最精妙的地方在于它不依赖 GPT-5 这种昂贵的外部教师模型,也不增加额外的 forward pass。
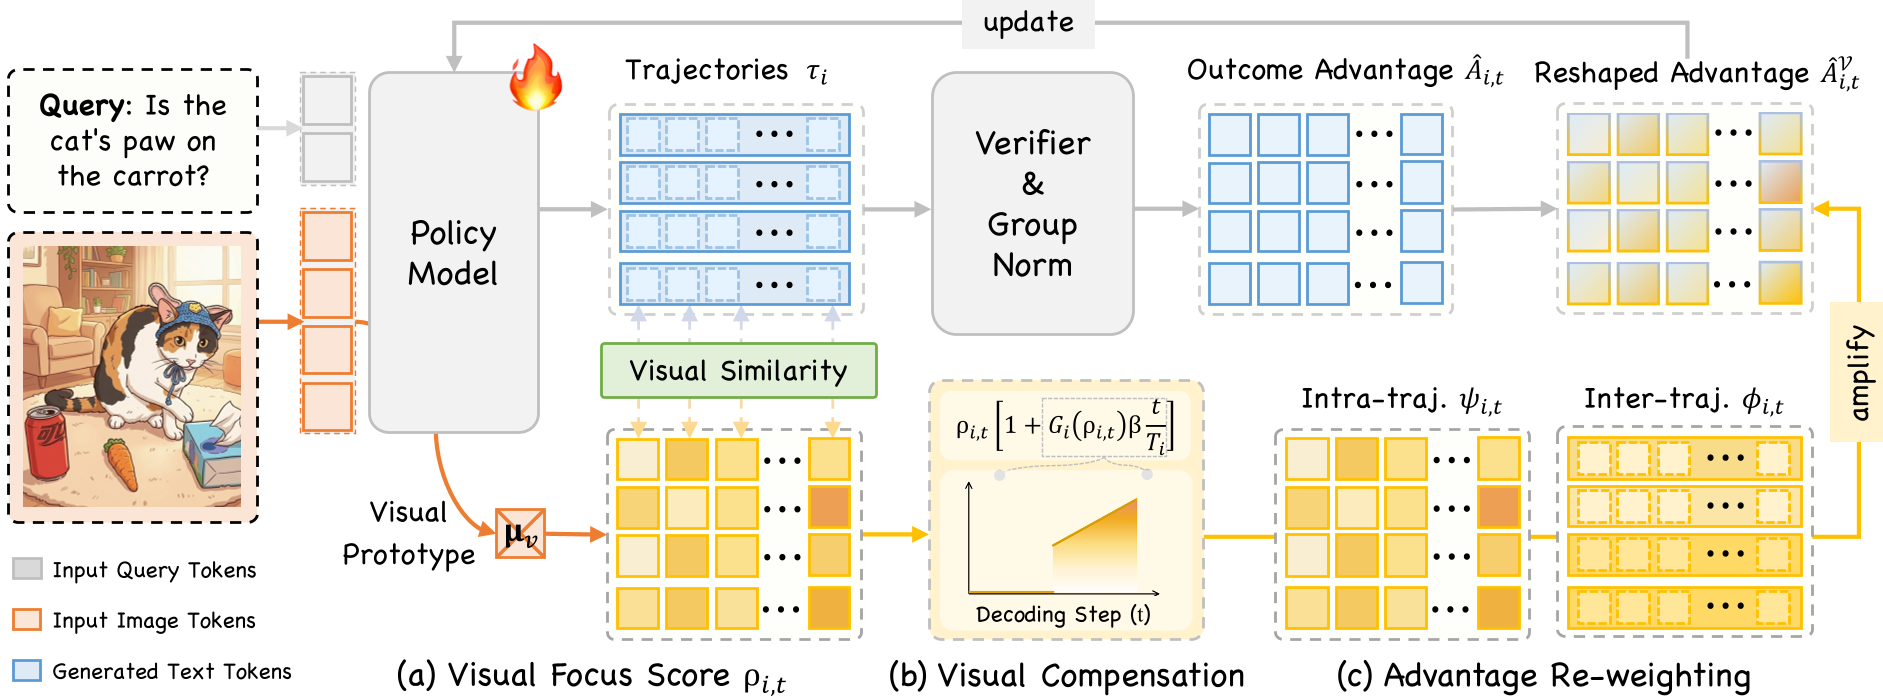
1. 视觉焦点评分 (Visual Focus Score)
作者发现生成的 Token 隐藏状态与图像 Token 的隐藏状态之间的余弦相似度,本身就是一个极佳的“视觉焦点”探测器。
- 原理:计算当前 Token 与视觉原型(所有图像隐藏状态的均值)的 Cosine Similarity,归一化后作为该步的视觉参与度指标。
2. 视觉注意力补偿 (VAC)
为了对抗遗忘,VGPO 引入了线性增长的补偿系数。推理步骤越靠后,模型被期待的视觉关注度就越高。这就像是在考试最后阶段提醒模型:“别只顾着写字,再回过头对查一下图中的数据!”
3. 双粒度优势重加权 (Dual-grained Advantage Re-weighting)
基于上述评分,VGPO 改进了经典的 GRPO 算法:
- Intra-trajectory (轨迹内):重奖那些视觉激活高于平均值的关键 Token。
- Inter-trajectory (轨迹间):在同组生成的多个结果中,优先选择整体视觉忠实度更高的那条路径。
实验战绩:全线超越 SOTA
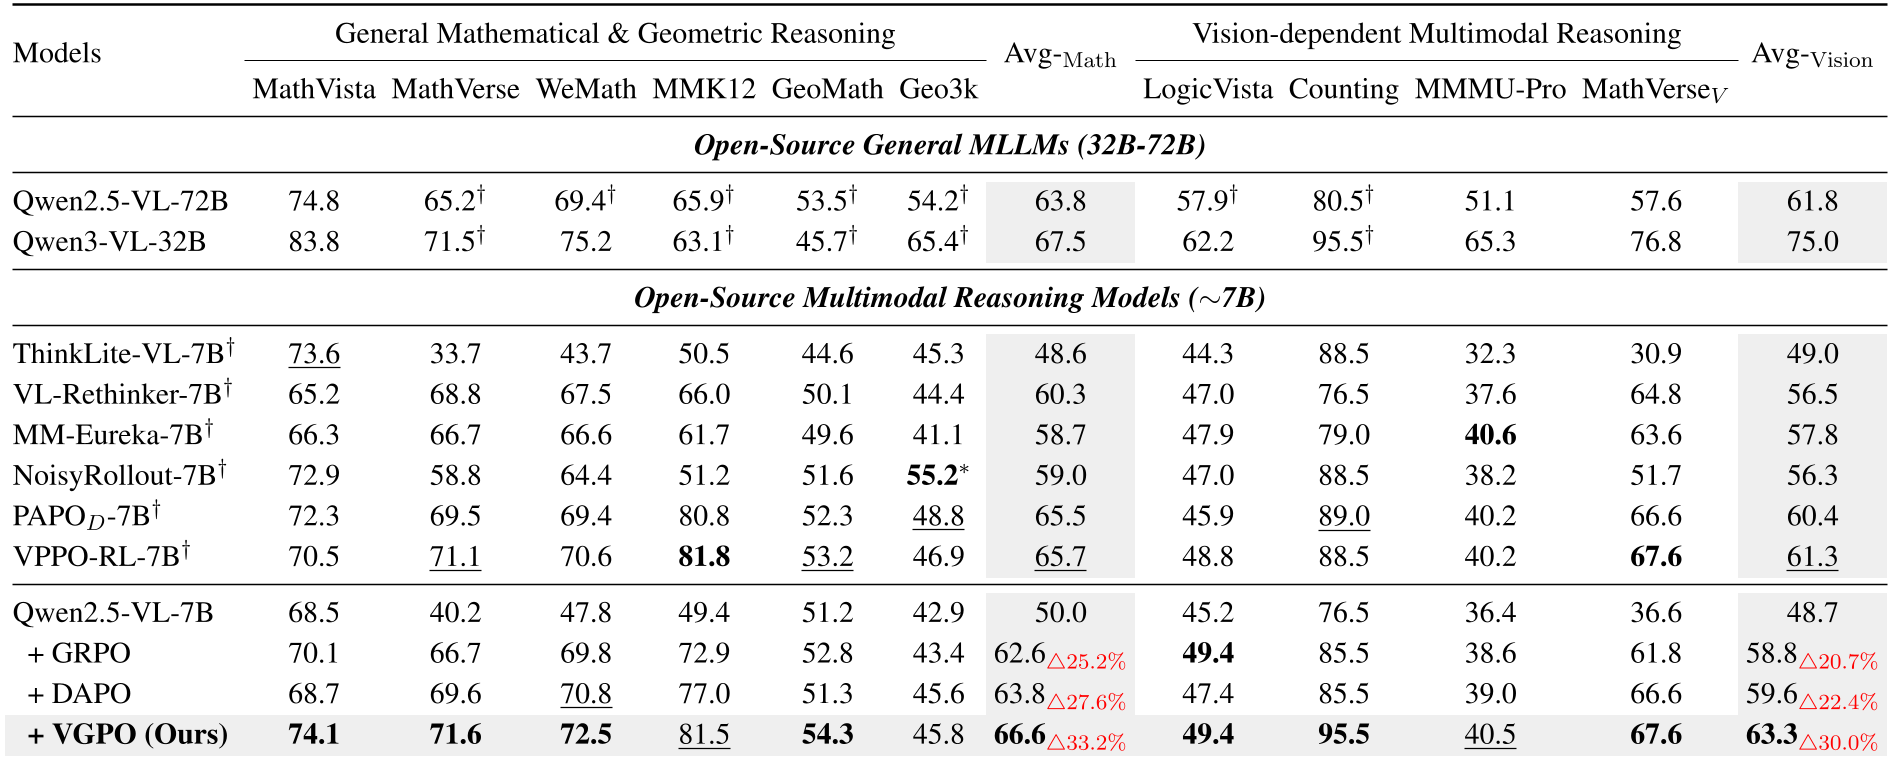
在涵盖 MathVista, MathVerse, LogicVista 等 10 多个主流榜单的测试中,VGPO 表现卓越:
- 小模型逆袭:VGPO 训练出的 7B 模型在某些任务上甚至能与 72B 的原版模型掰手腕。
- 数据效率:即便在有限的训练数据下,VGPO 的曲线也比传统的 DAPO 或 GRPO 更稳、更高。
- 消融验证:实验证明,线性补偿策略(Linear Strategy)优于阶梯函数或指数函数,因为它最契合注意力衰减的物理本质。
深度洞察:视觉关注是必要非充分条件
虽然 VGPO 解决了“看图不认真”的问题,但作者也冷静地指出了该方法的局限性:
- 感知天花板:如果 Visual Encoder 最初就没能在特征空间里编码出关键信息(如分辨率太低导致看错数字),再怎么加强注意力也是徒劳。
- 逻辑与知识的短板:失败案例分析显示,有些错误源自模型几何定理记错了,即便模型盯着图看,也还是会得出错误的推导。
总结
VGPO 的出现为 VLM 的强化学习提供了一个新范式:不仅要结果对(Outcome-based),过程中的视觉忠实度也必须作为指导信号(Process-guided)。这种基于模型内部状态的微调方法,不仅计算开销极低(仅增加 5%-10%),而且具有极强的通用性,是通往高可靠多模态推理的重要一步。