
VGPO:对抗视觉遗忘,让多模态大模型“看”到推理结束
Visually-Guided Policy Optimization for Multimodal Reasoning
本文提出了 Visually-Guided Policy Optimization (VGPO) 框架,旨在解决多模态大模型在推理过程中对图像关注度不足及随步骤增加而产生的“视觉遗忘”问题。该方法在 Qwen2.5-VL-7B 上实现了数学推理性能提升 33.2%,并在多项视觉依赖型任务中达到 SOTA。
TL;DR
视觉语言模型(VLM)在面对复杂数学或逻辑题时,常会犯“虎头蛇尾”的毛病:刚开始还看两眼图,推理到一半就开始瞎编(幻觉)。阿里巴巴 AMAP 等团队提出的 VGPO (Visually-Guided Policy Optimization) 框架,通过提取模型内部隐状态的秘密,给那些“看图仔细”的推理路径加鸡腿,成功解决了推理过程中的**视觉遗忘(Visual Forgetting)**难题。
痛点深挖:模型为什么总是“视而不见”?
在多模态推理中,VLMs 往往表现出两个致命弱点:
- 文本主导 bias:模型更喜欢看题目里的文字和自己刚生成的废话,对图像 Token 的注意力极低。
- 时间性视觉遗忘:随着推理步骤(Reasoning Steps)的增加,图像信息的权重呈线性衰退。这导致长链推理的后期,模型几乎是在闭眼盲猜。
作者通过对比正确与错误样本发现,正确样本在推理后期的视觉积累比例显著高于错误样本。这意味着,想让模型变聪明,必须让它在最后一步也记得盯着图看。
核心内功:VGPO 的三板斧
1. 挖掘隐状态里的“视觉关注得分”
作者发现,不需要什么 GPT-5 监考,模型自己的 Hidden States 就能说话。通过计算当前生成的 Token 与图像原型(Visual Prototype)之间的余弦相似度,就能精准识别出哪些词是在“根据图说话”。
2. 视觉注意力补偿 (VAC)
既然视觉注意力会随时间衰减,VGPO 就反其道而行之,引入了一个线性增长的补偿机制。在推理路径的后期,人为地放大视觉信号的奖励权重。
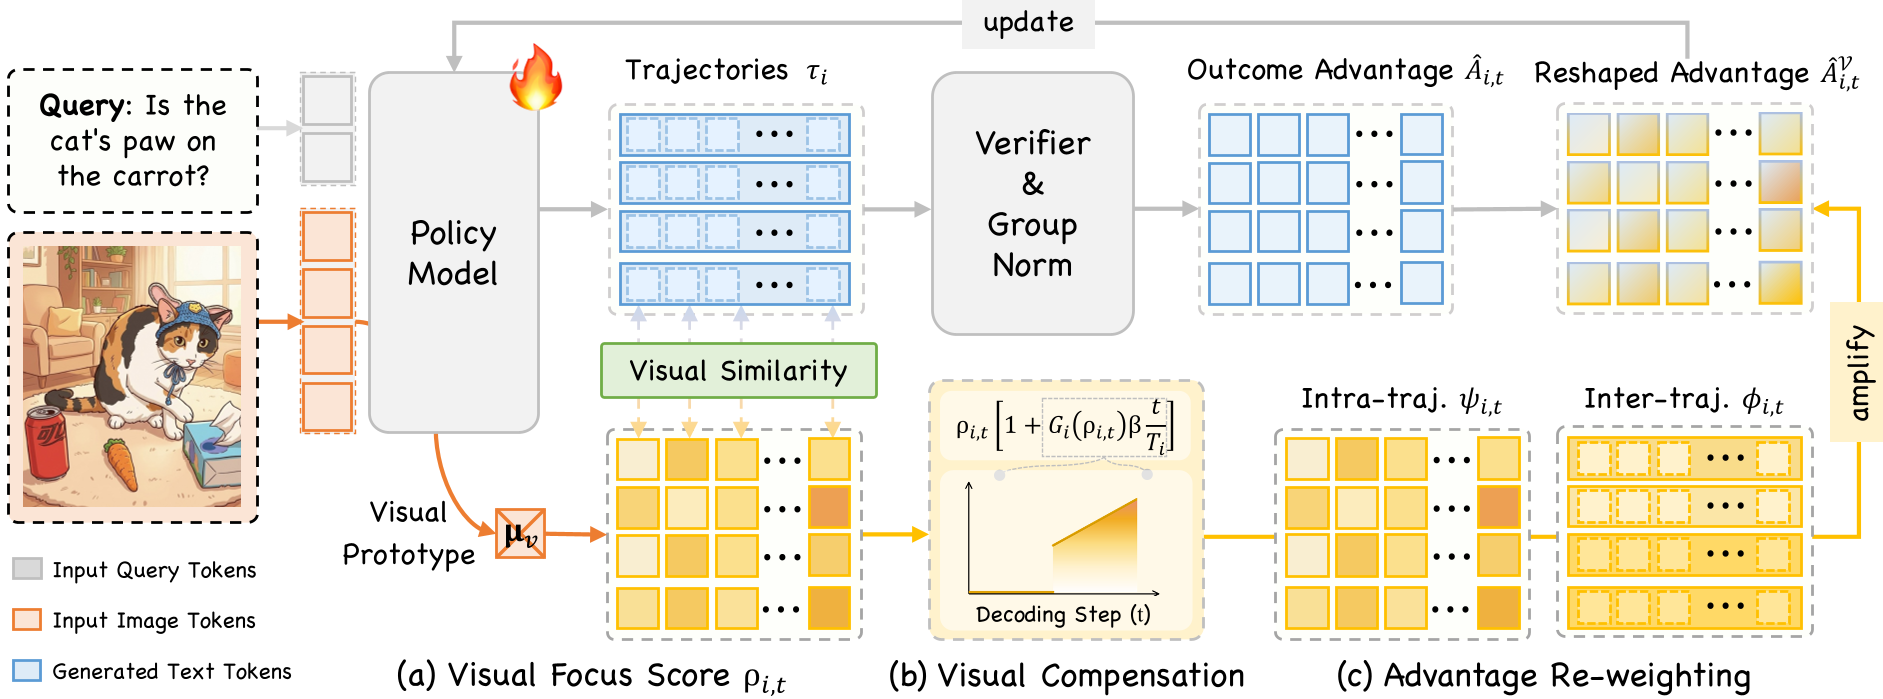 图 1: VGPO 框架概览,展示了从隐状态提取到双颗粒度重加权的全过程
3. 双颗粒度优势重加权 (Dual-grained Advantage Re-weighting)
这是 VGPO 的核心训练逻辑。它在强化学习的 Advantage 函数上动了手术:
- 轨迹内 (Intra-trajectory):如果某个 Token 的视觉关注度高于平均值,奖励它!
- 轨迹间 (Inter-trajectory):如果这整条推理路径比其他路径更“关注视觉”,优先优化这条路径。
实验战绩:7B 逆袭 72B
VGPO 的表现堪称惊艳。以 Qwen2.5-VL-7B 为基座训练后,它在数学和视觉任务上的表现提升了约 30%。
| 任务类型 | 原始基座 | GRPO 提升版 | VGPO (本文) |
|---|---|---|---|
| 数学推理 (Avg) | 50.0 | 62.6 | 66.6 |
| 视觉依赖任务 (Avg) | 48.7 | 58.8 | 63.3 |
更离谱的是,经过 VGPO 强化后的 7B 模型,在多项指标上超过了参数量十倍于它的 Qwen2.5-VL-72B。这证明了:优化推理质量比盲目堆参数更高效。
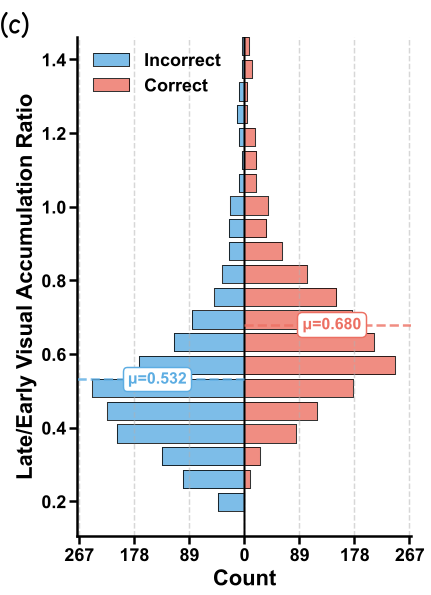 图 2: 推理过程中视觉注意力的演变,VGPO 有效维持了后期的关注度
深度洞察:为什么这种做法有效?
传统的 RLVR (可验证奖励的强化学习) 只管最后答案对不对。但这可能导致模型通过“凑数”或“背题”拿到高分。VGPO 实际上是加入了一种 Inductive Bias(归纳偏置):它规定了“正确答案必须是从图像里推导出来的”。
这种对推理过程的强干预,从物理直觉上纠正了 Transformer 架构在多模态理解中的弊端。
局限性与展望
尽管 VGPO 很强,但它也有短板:
- 如果 Base 模型的特征提取器(Visual Encoder)一开始就看错了(比如把 6 看成了 8),VGPO 会甚至会加强这种“自信的错误”。
- 目前是线性补偿,未来是否可以根据逻辑上下文(比如最后一步纯计算时)动态调整视觉权重?
总结
VGPO 为我们揭示了一个事实:大模型的潜能远未被榨干。通过巧妙地利用模型内部信号并结合强化学习,我们可以让它学会“专注”,而不仅仅是“预测”。