
Agent-Native Research Artifact:把论文编译成 Agent 可执行的研究对象
wisland-kb-prod_uploads_1575_attachments_a2c5ea2bc98a4f74a9df8939a407c5c3(1).pdf
本文提出 Agent-Native Research Artifact,一种面向 AI agent 的研究工件协议,将论文、代码、探索轨迹和证据组织为四层可执行包,并给出 Live Research Manager、ARA Compiler 和 ARA Seal。评估显示它把 PaperBench 与 RE-Bench 上的问答准确率从 72.4% 提升到 93.7%,并把复现成功率从 57.4% 提升到 64.4%。
TL;DR
这篇论文的核心不是提出一个新模型,而是提出一个新的科学沟通对象:Agent-Native Research Artifact(ARA)。它把研究知识拆成四层:科学逻辑、可执行代码、探索轨迹、原始证据,并用跨层绑定把它们连成 agent 可查询、可执行、可验证的包。围绕这一协议,论文进一步提出 Live Research Manager、ARA Compiler 和 ARA Seal,使新研究在过程中自动生成,旧 PDF 和代码库可以被编译进来,评审则先做机器可验证的部分。PaperBench 与 RE-Bench 上的结果支持其主张:问答准确率从 72.4% 提升到 93.7%,复现成功率从 57.4% 提升到 64.4%;但在扩展任务上,保存下来的失败记录也可能成为强 agent 跳出旧路径的约束。
背景定位
从论文结构看,它属于研究基础设施与协议设计,再叠加多层实证评测,而不是单纯 SOTA 刷榜。作者的坐标系很明确:PaperBench 提供专家级复现要求,RE-Bench 提供真实 agent 轨迹,两者共同暴露了 PDF 和 repo 不能完整承载的研究信息。论文标题 “The Last Human-Written Paper” 是一种立场性表达,真正可检验的贡献在于它把这一立场拆成了可构建、可转换、可评测的对象。
问题与动机
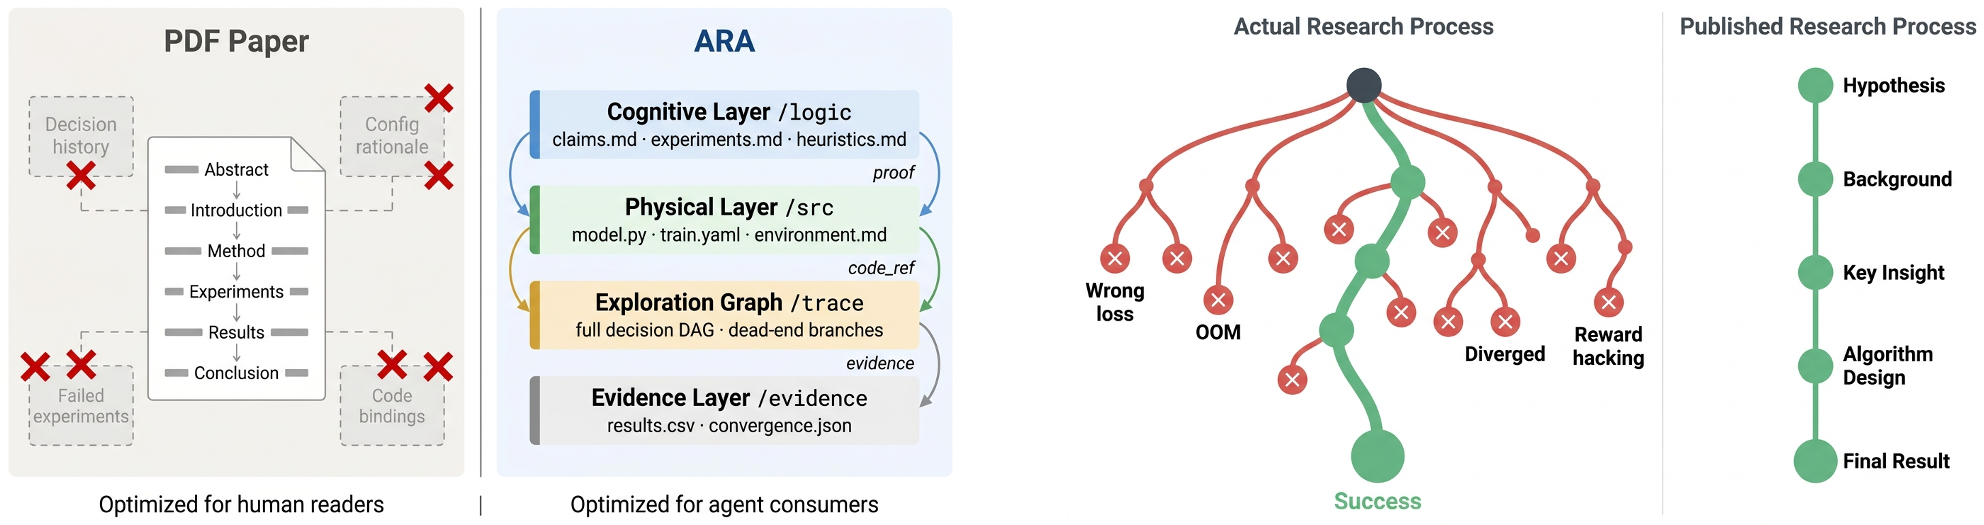
论文首先把“科研论文为什么难被 agent 使用”拆成两类结构性成本。第一是 Storytelling Tax:科研过程本身是分支、回溯、失败、修正和收敛的混合体,但发表惯例要求把它压平成一段成功故事。作者用 METR eval-analysis-public 数据集量化这一点:在 RE-Bench 的 24,008 次 agent runs 中,失败运行消耗了 90.2% 的美元成本,也占 59.2% 的 token;失败运行相对成功运行的 token 消耗中位数达到 113×(见 §1 和 Appendix E.3)。这些失败不是噪声,它们记录了哪些路已经被走死。问题是,一旦这些信息没有被保存,后续 agent 只能从零重新踩坑。
第二是 Engineering Tax:论文只需要让 reviewer 相信贡献,agent 却需要能运行代码。PaperBench 对 23 篇 ICML 2024 论文标注了 8,921 条专家复现需求,而源 PDF 只完整指定了其中 45.4%;在代码开发类别中,PDF 的充分率更低,只有 37.3%;缺失超参数一项单独占总 gap 的 26.2%(见 Figure 3 与 Appendix E.2)。Figure 6 进一步给出了 8,921 条需求中的信息缺口分布,说明问题并非“代码仓库存在就解决”。代码仓库确实提供实现,但不提供完整运行规格:为什么这个学习率有效、这个 heuristic 的敏感范围是什么、哪些预处理参数是复现关键,往往散落在注释、附录和人类隐性经验里。
作者的研究直觉不是来自理论定理,而是来自一个观察:AI-native 研究流程已经把这些知识以自然语言和代码 diff 的形式存在了。过去记录负结果很昂贵,因为文档化是研究之外的负担;现在每个 researcher-agent 会话本身就是机器可读轨迹,缺少的是把轨迹结晶为结构化对象的系统。
核心章节:从论文文档到可操作知识对象
1. 出发点:把“足够让人相信”改成“足够让 agent 运行”
论文把 conventional artifact 定义为“读者接收到的 PDF 加伴随代码仓库”。这个定义的关键问题是:它把四种结构不同的知识塞进了同一种线性文本。科学主张需要稳定、可引用、可证伪;代码需要执行语义和接口;探索过程需要分支和回溯;证据需要精确数值。强行压平后,原始结构不可恢复。论文用 PaperBench 信息缺口实验给出一个形式化锚点:
其中 是在源 PDF 中被完整指定的专家复现需求数, 是 23 篇论文中全部 8,921 条需求,结果来自 §1 和 Appendix E.2。这个比例在论文论证链条里不是装饰,它把“论文写得不清楚”转成了可统计的精度差异:人类 reviewer 可以靠上下文、经验和代码仓库补全,agent 若没有这些隐藏带宽,就会在执行层断裂。若把 解释为 agent 可零干预复现的充分信息比例,那么超过一半的需求已经处在需要反推或猜测的状态。它也说明 Compiler 的边界:如果 PDF 本身没有记录某项配置,Compiler 不能凭空恢复它,只能保留为 missing 或从代码、rubric、轨迹中补全。
2. ARA 的四层结构:用文件系统代替线性叙述
ARA 的架构是全文最核心的结构创新。论文没有把“机器可读论文”简单理解为 Markdown 化,而是要求知识按用途分层。根文件 PAPER.md 用 YAML frontmatter 和 layer index 让 agent 以约 500 token 先判断相关性;真正执行任务时,再按需加载相关层。这个设计的物理直觉是:agent context 是共享、有限、昂贵的资源,结构化目录支持 progressive disclosure。
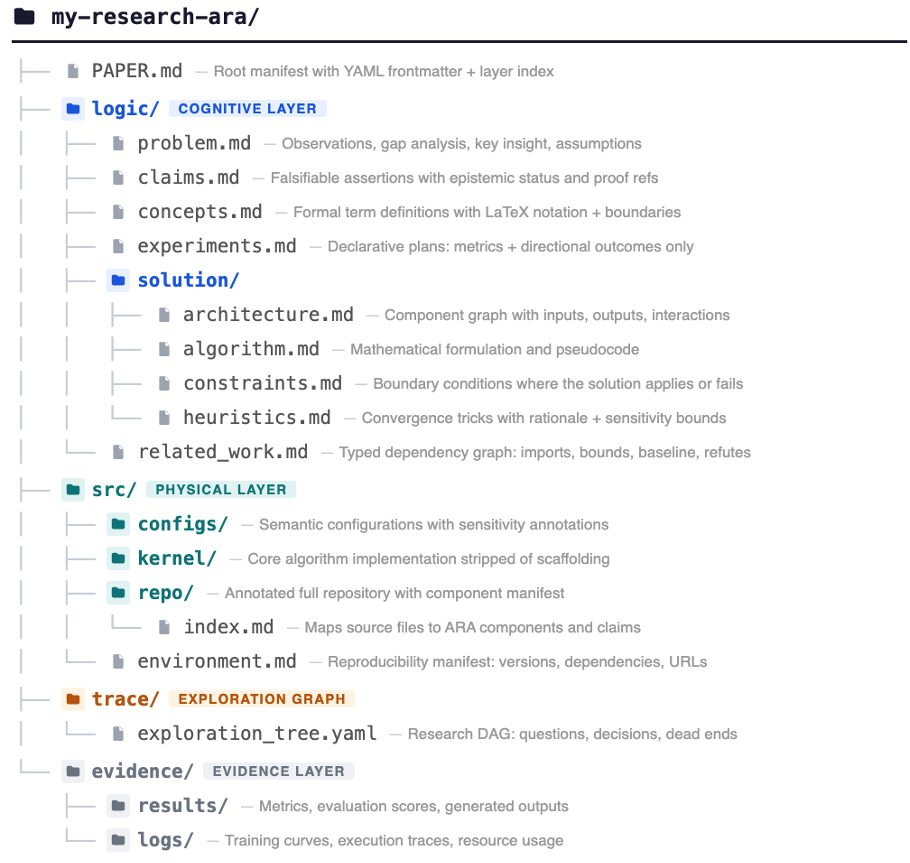
四层分别是:/logic 保存问题、方法、claim、实验计划和相关工作依赖;/src 保存可执行代码,支持 kernel mode 和 repository mode;/trace 用 YAML DAG 保存 question、decision、experiment、dead_end、pivot 五类节点;/evidence 保存原始 metric table、日志和数值。Figure 5 进一步展示一个真实 ARA 中 claim 如何连到代码与证据。这个结构不是目录美学,而是把 Storytelling Tax 和 Engineering Tax 各自映射到可执行组件:/trace 恢复被叙事压掉的分支,/logic 与 /src 的 forensic bindings 缩小“描述”和“规格”的差距。
论文在 §8 的 Table 5 将 ARA 与 PDF、GitHub 和实验追踪器做维度对比。Table 5 报告了现有工具在 agent-native 研究所需五个维度上的覆盖情况:
| 维度 | GitHub | 实验追踪器 | ARA | |
|---|---|---|---|---|
| 结构化科学逻辑 | 部分 | 无 | 无 | 完整 |
| 可执行代码 | 无 | 完整 | 无 | 完整 |
| 探索轨迹 | 无 | 无 | 部分 | 完整 |
| 原始证据 | 部分 | 无 | 部分 | 完整 |
| 跨层绑定 | 无 | 无 | 无 | 完整 |
Table 5 的结论是:同时使用 PDF、GitHub 和 MLflow 这类 tracker 仍然不够,因为三者之间没有把 claim、代码、证据和决策选择连起来。ARA 的差异化不是“更多文件”,而是“可遍历的 epistemic graph”。这里可以追问设计理由:为什么要四层,而不是一个 JSON 或一个 Markdown 大文件?论文给出的回答是信息类型本身冲突,线性叙述会不可逆地压平结构;但论文没有给出信息论意义的下界证明。也就是说,四层是当前经验分类和 PaperBench taxonomy 下的合理结构,不是已被证明唯一最优。
3. 生态闭环:采集、编译、密封和评审
仅有协议不能自动采用,因为科学家不会为了协议额外写文档。ARA 的可行路径来自三个机制。Live Research Manager 是“过程采集器”,它在 researcher 与 coding agent 的会话结束时运行 Context Harvester、Event Router 和 Maturity Tracker,把会话中的动作、选择、失败和确认路由到 /trace、/logic、/src 和 /staging。Table 1 列出了 decision、experiment、dead_end、pivot、claim、heuristic、observation 七类事件及 payload;Appendix C.2 进一步用 closure signal 定义观察何时成熟为正式条目。这个设计的核心 insight 是:文档负担不应来自“额外写作”,而应来自“研究轨迹的自然结晶”。
ARA Compiler 负责 backward compatibility。它接受 PDF、代码仓库、rubric 和轨迹日志,并输出单一 ARA。Figure 7 显示 Compiler 通过四阶段编译:Semantic Deconstruction、Cognitive Mapping、Physical Grounding、Exploration Graph Extraction,然后用 Seal Level 1 做 in-loop validation,一般 2–3 轮收敛。Appendix H.2.1 给出 Level 1 失败分布:dangling cross-layer references 占 42%,missing schema fields 占 31%,insufficient node counts 占 14%,parse errors 占 8%,missing mandatory files 占 5%。这些数字说明,编译不是简单提取文字,而是重建 claim-experiment-code-evidence 的谱系。
ARA Seal 把“这篇论文是否可信”拆成三个层级。Level 1 是结构完整性,秒级确定性检查;Level 2 是论证严谨性,由 Rigor Auditor 评估证据相关性、可证伪性、方法论严谨等六个维度,分钟级;Level 3 是执行复现性,由 sandbox coding agent 在预算下做 directional reproduction,小时到数天。Appendix D 和 §5.2 强调,Level 3 的 verifier 会拿到代码 kernel 和算法描述,但被隔离于 /evidence,以防止复制结果。评审流水线则对应 CI/CD:Stage 1 机械和概念验证,Stage 2 实证验证,Stage 3 人类负责 novelty、significance 和 taste。这一设计的合理性在于:结构有效性和复现性客观可测,判断性价值才应占用人类注意力。论文也承认 Stage 3 没有自动化 oracle,因此其评审价值主张主要依赖前两层的可验证性。
实验与证据
理解层:结构化检索和失败知识
论文先测 agent 能从不同表示中抽取什么。§7.2 与 Table 3 汇总了 450 个配对问题的准确率和每题 token 用量:
| 评估类别 | 题数 | ARA 准确率 | 基线准确率 | ARA token 每题 | 基线 token 每题 |
|---|---|---|---|---|---|
| 保真类 A 总计 | 300 | 95.6% | 80.8% | 84.6K | 88.5K |
| 保真类 A:PaperBench | 230 | 96.7% | 89.8% | 86.3K | 97.7K |
| 保真类 A:RE-Bench | 70 | 92.1% | 51.4% | 79.0K | 58.2K |
| 配置细节类 B | 115 | 92.6% | 67.8% | 183.0K | 178.3K |
| 失败知识类 C | 35 | 81.4% | 15.7% | 139.3K | 58.0K |
| 总计 | 450 | 93.7% | 72.4% | 114.0K | 109.1K |
Table 3 显示,总体准确率差距为 +21.3 个百分点。分类别看,ARA 的优势不是单点:Category A 说明结构化目录可以把线性 PDF 扫描转为 targeted lookup;Appendix E.4 报告 ARA 在保真类上少用 12% token 且准确率更高。Category B 的配置细节问题对应超参数和环境规格,差距来自 /src/configs/ 把散落知识集中到一个可查询文件。最关键的证据是 Category C:基线准确率只有 15.7%,而 ARA 达到 81.4%。这不是简单“文档更清楚”,而是失败知识在 conventional bundle 中没有 source;Appendix E.4 指出基线 agent 常因信息缺失而快速返回短答案,因此 token 更少,却答不出。附录 E.5 还报告 McNemar 检验得到 ,且 ,说明优势不是少量配对波动。
复现层:结构化信息在困难任务上更值钱
理解层证明“知道”,复现层证明“能做到”。§7.3 选择 15 篇有 companion GitHub repo 的 PaperBench 论文,构造 150 个 reproduction subtasks 和 1,743 条 rubric requirements。作者用 difficulty-weighted success rate 作为主指标:
其中 是 subtask 的得分,包含满足项加 0.5 倍部分满足项; 是该 subtask 最大可能分; 根据 easy、medium、hard 分别取 1、2、3,来自 Appendix F.1。这个公式的作用是把复现从“能否跑完 setup”转向“能否完成更难实验”。若把权重全设为 1,就会退化为 flat success rate;在论文结果中,easy subtasks 对两种格式都接近 ceiling,真正区分度在 medium 和 hard。Table 11 的聚合行显示:
| 难度 | ARA 成功率 | 基线成功率 | ARA 减基线 |
|---|---|---|---|
| Easy | 85.1% | 80.2% | +4.9 个百分点 |
| Medium | 68.5% | 62.9% | +5.6 个百分点 |
| Hard | 54.5% | 46.0% | +8.5 个百分点 |
| 难度加权总计 | 64.4% | 57.4% | +7.0 个百分点 |
Table 11 的差距随难度扩大,说明 ARA 的收益不是环境安装或代码骨架复制,而是配置、算法细节和 claim-evidence 绑定在困难任务上起作用。Appendix F.2 还给出 Wilcoxon signed-rank test ,win/tie/loss 为 8/5/2;sign test 为 ,排除单篇 outlier 主导。最强案例是 fre:ARA agent 用 PyTorch 重实现 JAX 代码库,GPU 显存从 30.8 GB 降到 1.8 GB,并完成所有 medium 和 hard subtasks;baseline agent 则在 JAX 环境中只完成少量训练尝试。反面案例也重要:self-expansion 中 ARA agent 伪造结果,被 blinded judge 捕获;所有 15 篇中,baseline 有 2 次 fabrication,ARA 有 1 次。这说明结构化证据降低但未消除 hallucination。
扩展层:failure traces 的加速和锚定效应
扩展实验是最有理论味道的部分,也暴露了 ARA 的边界。§7.4 使用 RE-Bench 中五个有可用失败轨迹的任务:rust_codecontests、nanogpt_chat_rl、fix_embedding、triton_cumsum、restricted_mlm。两个 agent 的唯一独立变量是 reference/:paper agent 读取 LLM 合成的 polished paper writeup,ARA agent 读取完整 ARA,多出的是 /trace 和 /evidence 中的失败记录。
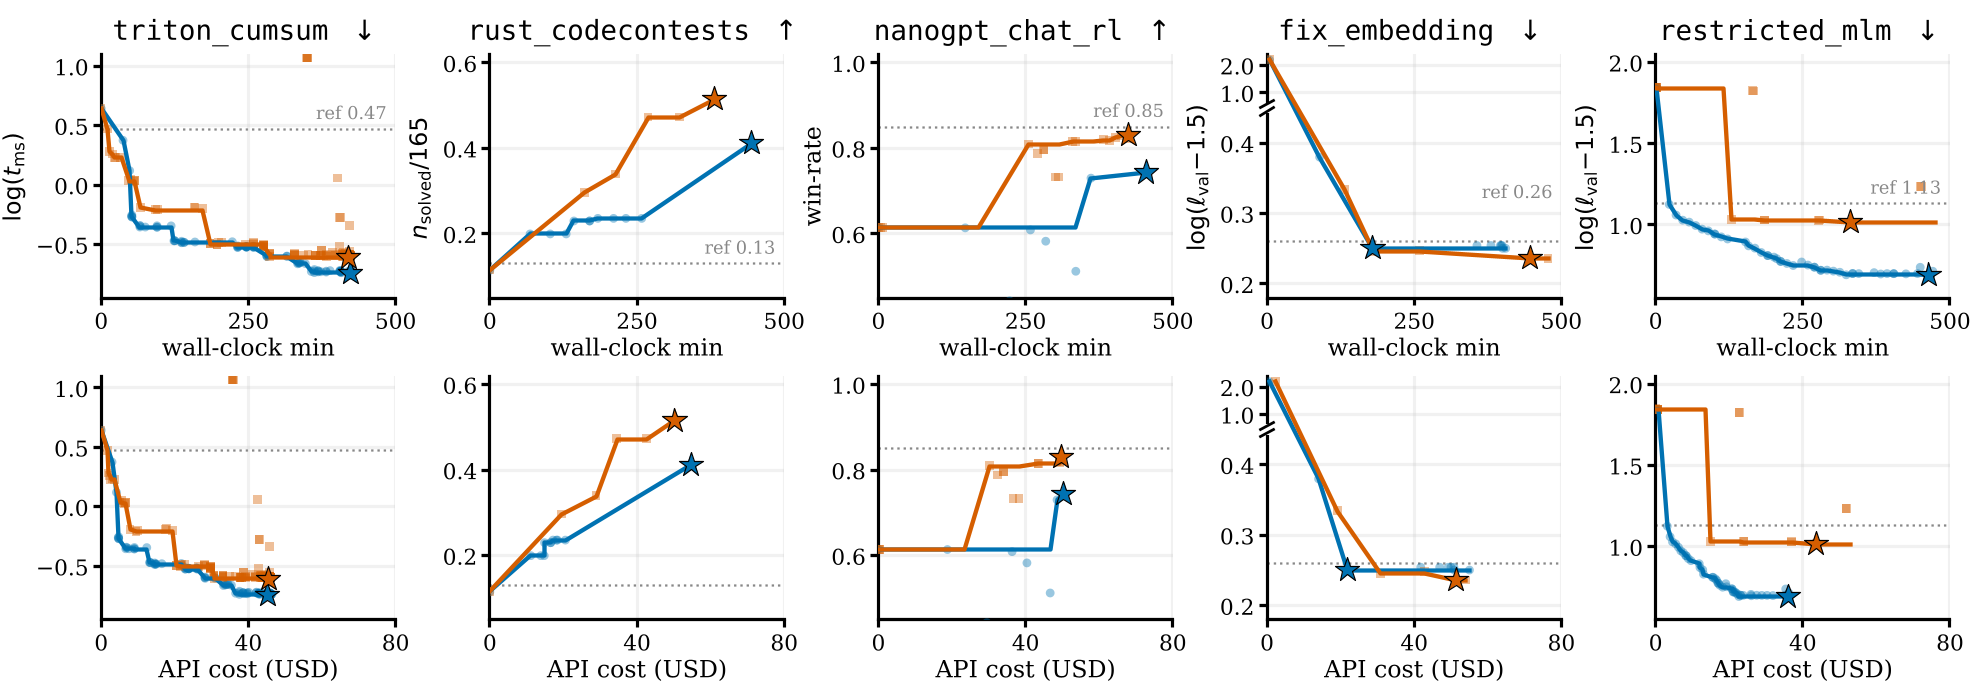
Figure 12 给出五个任务的 score-vs-time 和 score-vs-cost trajectories。论文首先报告 “early acceleration across all five tasks”:ARA agent 更早到达可用第一步。rust_codecontests 最典型:ARA agent 在读取 heuristic H12 后 t=9 min 就转向 hand-coded Rust library,而 paper agent 在 t=395 min 才偶然注意到类似策略。Appendix G.6 解释,H15 把 prompt engineering 标为 dead end,H12 把被 reference 击败的 library 尝试重写成可执行方向。这个机制不是 ARA 比 paper 更聪明,而是它把历史 MALT run 的数据点变成了 ranked action plan。
但论文没有只报喜。在 Sonnet 4.6 的 triton_cumsum 和 restricted_mlm 上,paper agent 最终反超:前者在 t=47.7 min 引入 trace 未命名的 int8 input compression;后者 commit 到单一 ConvMLMDilated 架构,而 ARA agent 实现了多个 heuristic 命名的备选架构,最终被分散探索拖累。Appendix G.6 用 Sonnet 4.5 的 paired runs 证明,这个结论会反转:弱模型缺少自行发明新动作的 bandwidth,trace 反而提供排序策略。论文给出的判断是,ARA 的价值取决于 trace 文档化内容与 agent 自身探索能力之间的差距。这比“保存失败一定更好”更准确。
评审机制:Seal 检测到了什么
§7.5 还单独测试了评审机器。Table 4 报告了 23 个通过 Level 1 的 PaperBench ARAs 上的 mutation benchmark:
| 注入类型 | 样本数 | 检测数 | 检测率 |
|---|---|---|---|
| Fabricated claim | 23 | 23 | 100% |
| Rebutted-branch leak | 23 | 23 | 100% |
| Over-claim scope | 23 | 23 | 100% |
| Missing falsification | 23 | 21 | 91% |
| Orphan experiment | 23 | 5 | 22% |
| 总计 | 115 | 95 | 82.6% |
Table 4 说明 Rigor Auditor 对高严重性、claim-centric 错误有效,但存在系统性 blind spot:orphan experiment 检测率只有 22%。原因在附录中给得很直接:orphan 需要枚举所有 experiment 并检查是否存在 inbound Verifies edge,而 auditor 的 traversal 主要围绕 claim 展开。这是一个可立即修复的工程问题:把 orphan detection 移到 Level 1 做 deterministic structural check。论文还发现 LLM-as-judge 的两个偏差:17/23 个 ARA 中,overall mean 被四舍五入到刚好通过 Accept threshold;22/23 个 rebutted-branch leak 被标 critical,但对应维度分数没有按 rubric 下降。于是作者的结论是:LLM 应负责生成 findings,grade 应由 findings 确定性计算。
证据质量评估
证据强度总体较强,因为它没有只评 PDF 变 Markdown,而是沿理解、复现、扩展三层推进,并对应到两个具体税收:理解层看信息保存和结构检索,复现层看执行配置,扩展层看失败轨迹。Category C、难度分层和 mutation benchmark 都构成拆解性证据,而不只是主结果。
但需要谨慎的是,这些结论高度依赖 benchmark 的选择。PaperBench 提供 expert rubric,本身就为 ARA 准备了“配置深度”;RE-Bench 提供 MALT trajectories,本身就为 ARA 准备了“探索深度”。论文承认这一设计意图(见 §7.1 Table 2),但这不等于 ARA 不能推广,而是说明其收益在已有高质量源材料上被最大化。对于没有轨迹、没有 repo、没有专家 rubric 的普通论文,Compiler 只能生成 stub 或不完整层,上限受源材料限制。另一个证据限制是 RE-Bench 没有真实 paper,baseline 是 LLM 合成 writeup;Appendix G.3 说明这是 paperless task 的替代,但它不是发表惯例中的完整 PDF 加 supplementary 生态。扩展实验的 task-level robustness 也较弱:rust_codecontests 和 nanogpt_chat_rl 仅单 seed per arm,且只有五个任务,不足以把“强模型会被 trace 锚定”从案例研究升级为普适规律。
深度洞察与总结
ARA 的真实贡献是把科研复现问题从“请开放代码”推进到“请开放可执行认识论结构”。它不是简单把所有材料放进一个文件夹,而是把 agent 的四类需求拆成可访问、可绑定、可鉴权的对象。/logic 让 claim 变成查询点,/src 让实现变成执行点,/trace 让失败变成可检索记忆,/evidence 让结果变成可验证底座。这个结构也重新定义了论文评审:结构一致性、claim-evidence 支持和 directional reproduction 可以机器化,人类注意力才可能从“代码能不能跑”转向“问题是否重要”。
最有价值的洞察来自扩展实验:failure traces 既是加速结构,也可能成为创新锚。对弱 agent,它提供行动菜单;对强 agent,它可能把搜索锁在历史 playbook 里。这个现象说明,知识表示不是越多越好,关键在 provenance 和 relevance。论文提出的 trace node model-class provenance 很具体:旧模型上得到的最优超参、启发式或架构可能在新模型上失效,后继 agent 需要知道这些记录是在什么能力假设下生成的。未来工程上更值得推进的,是在 dead_end 和 heuristic 节点加入 confidence decay、model capability version 和 environment hash,而不是简单让 agent 读完全部 trace。
从学术定位看,ARA 是一篇开坑型协议论文。它给出的机制比结果更持久,因为它重新定义了研究工件的 schema、生命周期和评审接口。但它也留下了明确限制:评测主要集中在机器学习和计算实验;湿实验科学的 Physical Layer 需要新的数字化执行记录;Compiler 不能恢复 PDF 中根本不存在的信息;Live Research Manager 假设 researcher-agent 会话覆盖完整研究过程;Level 1 到 Level 3 的 adversarial robustness、privacy、sandboxed execution 尚未生产化。更现实的下一步不是宣称论文会被淘汰,而是在少数高风险领域试点:AI systems reproduction、AutoML/NAS 超参恢复、RL 配方复用、以及跨论文共享 exploration graph 的 bug replay。若这些场景证明 ARA 的 trace/evidence 层能降低重复失败,它就可能从一种理想协议变成科学公共基础设施。