
World in World:用免训练证据接口让冻结视频世界模型读取相机、几何与历史
World in World: Explore the World with World Models
World in World 提出一个 training-free 视觉证据接口,把源视频、目标视角投影、几何渲染和历史检索统一转换为带相机与时间标签的 clean visual states。该接口通过冻结因果视频模型的原生自注意力读取证据,并用 CGAR 与 EWA 分别定位证据和调节每个证据通道的注意力贡献。实验表明,在 DAVIS 与 OpenVid-1M 的 camera-controlled video rerendering 上,本文方法的 VBench Overall 达到 85.192,旋转相机误差为 2.8326 度。
TL;DR
World in World 解决的是如何在已经训练好的自回归视频世界模型中接入多种控制证据。它不重新训练 backbone,也不增加任务专用 adapter,而是把源视频观测、DepthCrafter 投影、LHM++ 与 SMPL-X 的人体几何渲染以及 rollout-wide 检索历史全部转换成带相机、事件时间与空间支持权的 clean visual states,并让冻结模型用原生 self-attention 读取这些证据。Correspondence-guided attention routing 通过持久点身份和几何对应修正注意力定位,evidence-wise attention CFG 则在同一 denoising 前向中逐通道调制注意力响应。实验在 DAVIS 和 OpenVid-1M 上给出 VBench Overall 85.192、RotError 2.8326 度、PSNR 23.1511、SSIM 0.787205。
背景定位
从论文结构看,它不是提出新的 world-model backbone,也不是纯 benchmark;它更接近方法改进型工作,但改进点发生在 inference-time interface 上。论文把 LingBot-World 2.0 的 causal-fast checkpoint 作为冻结基座,所有预训练参数不变,视觉证据在推理时构造和附加。这个定位很关键:它的学术主张不是“我学会了一种新控制”,而是“同一个预训练注意力机制本来就有一个干净状态入口,只要把外部证据压进同一入口,就能扩展控制”。因此,World in World 的价值主要在重新定义扩展点,即把灵活控制问题转成 visual evidence construction and orchestration。
问题与动机
自回归视频世界模型可以连续预测观测,因此适合交互,但一旦目标相机离开源视频,困难就不再只是生成好看画面。用户从新视角观看同一段动态事件时,生成结果必须继续与源视频中的事件同步,必须把观测到的内容放到正确空间位置,必须补全源视频中从未看见的主体表面,还必须在长时重访时找回此前生成过的外观。现有 camera conditioning、source-video rerendering、geometric control、long-term memory 等方法往往为不同控制建立不同通路。这样的设计在一个任务上有效,但每增加一种证据类型或一种证据组合,就可能重新设计模块或重新训练。
更具体地说,失效机制有四类。第一,源视频观测提供外观和内容,却不知道自己在新视角下应该出现在哪里;第二,大视角变化会暴露新的主体表面,纯外观证据无法给出形状和深度;第三,因果模型的 rolling cache 只保留近期状态,一旦镜头绕回早期区域,原始 appearance 和 layout 已经从上下文移除;第四,不同证据通道在不同空间区域和去噪阶段可靠程度不同,若以同一强度注入,过强的辅助证据会压制模型原本的生成分布,过弱的证据又无法控制相机。World in World 的核心直觉因此是:不要为每种控制修改模型,而要把控制变成模型已经会读取的视觉状态,再解决“从哪里读”和“读多强”两个问题。
核心章节
原生入口:clean-state attention 是共享读取接口
论文首先利用冻结因果视频模型的既有行为。在生成当前 chunk 时,backbone 会通过 native self-attention 读取初始观测和近期 finalized states,并依赖相机与时间编码说明这些状态来自哪里、对应何时。World in World 把这一机制反过来使用:既然模型愿意读取 clean visual states,那么外部证据也可以被编码成同类状态,而不是强行塞入新的条件模块。
其中 标记不同证据通道, 是通道 的原始证据, 是目标相机轨迹, 是当前 denoising step。 表示证据的视觉内容, 记录每帧相机内参、位姿和事件时间索引, 是证据 token 的空间支持权重,取值在 , 决定该通道在去噪阶段 是否激活,取值为 或 。这个式子在论文里的作用是把异构控制证据统一到同一个接口:每个通道都必须同时回答“我是什么内容”“我从哪个相机和哪个时间出现”“我支持哪些区域”“我现在是否参与注意力”。相比直接拼接特征图或增加 cross-attention adapter,这种表示保留了 backbone 原有的 QKV projections 和文本、相机条件通路。若令 在某些阶段为 ,对应证据完全退出注意力;若令 接近 ,该 token 对当前查询的贡献被抑制。这使“空间覆盖”和“时间可用性”不再是口头概念,而成为 token 级可控量。
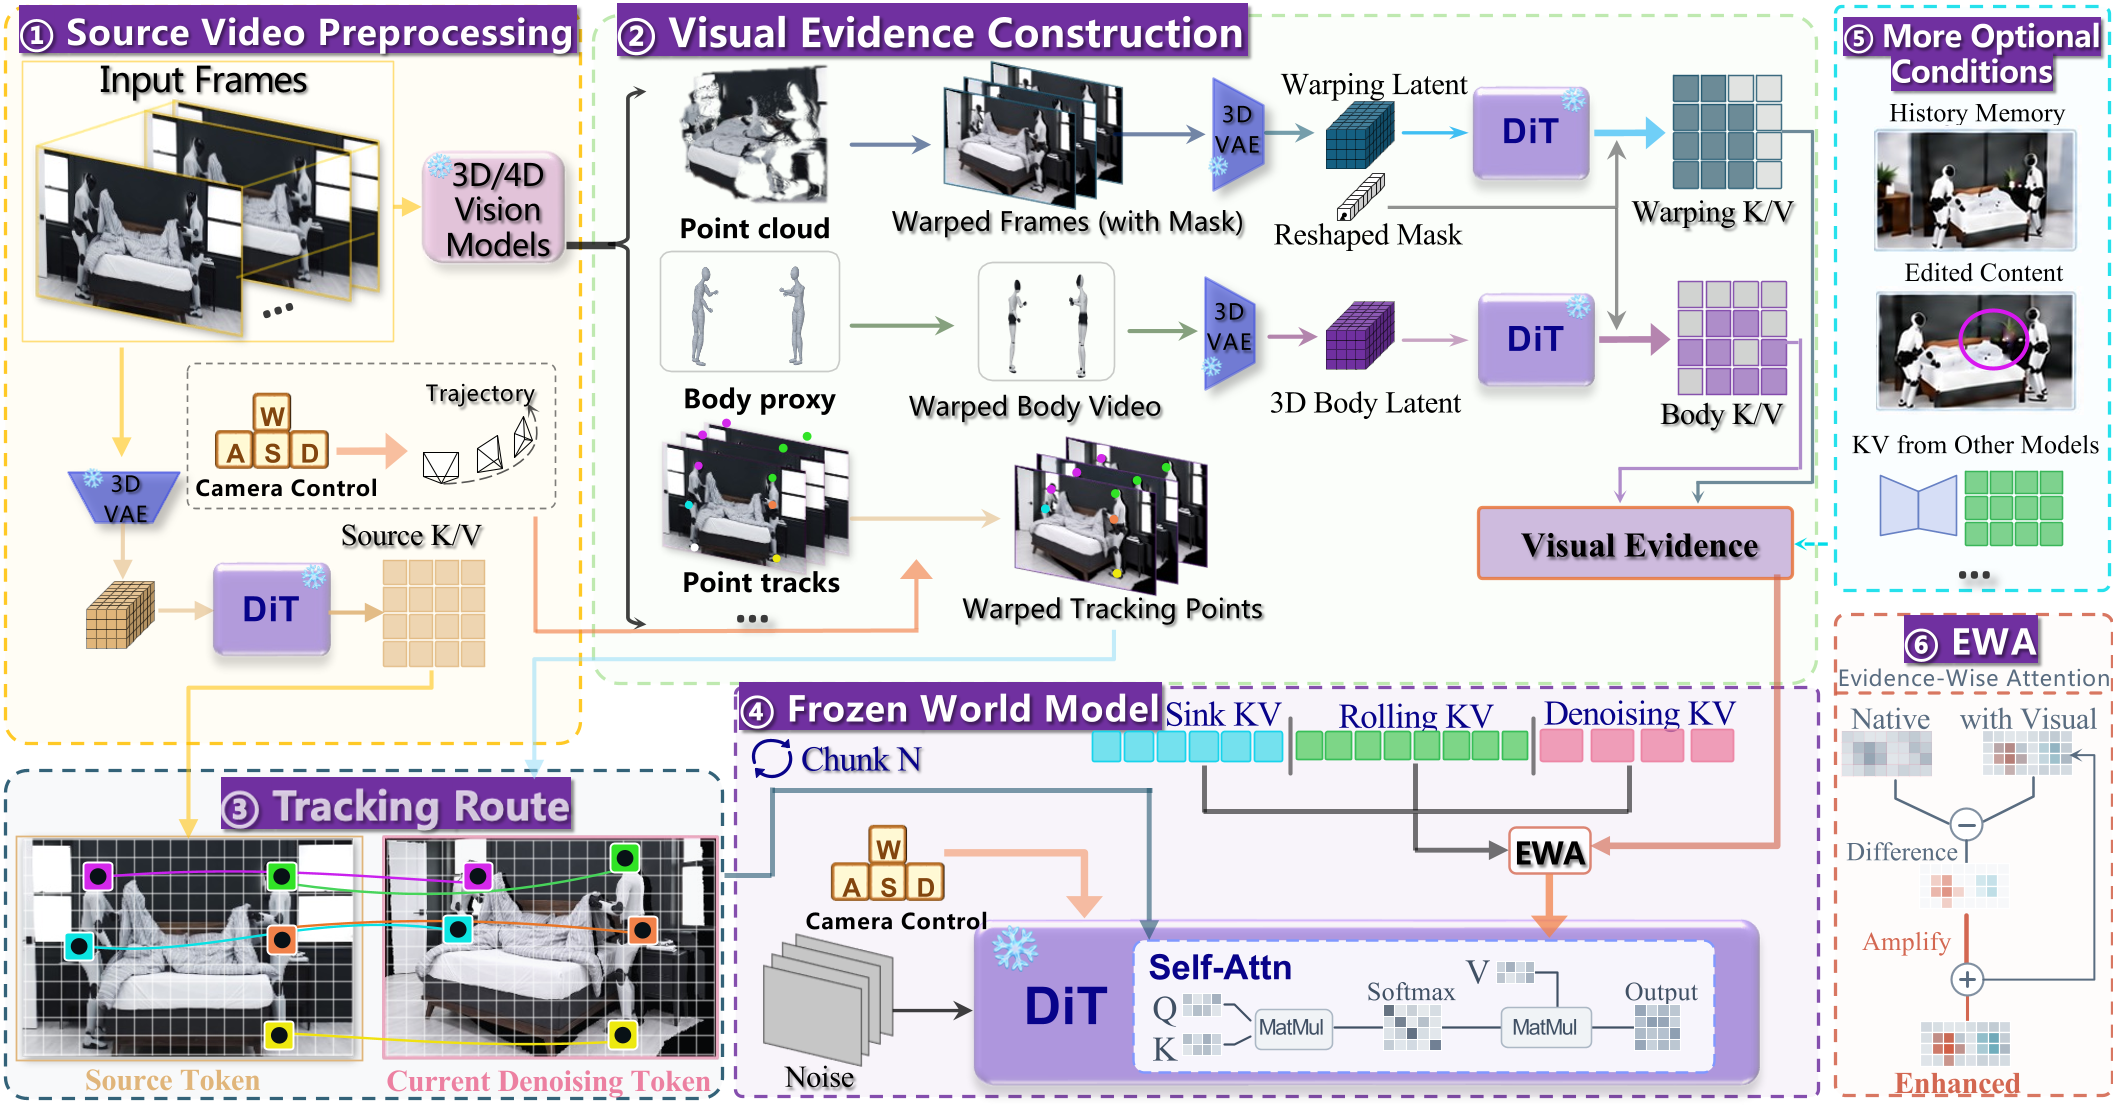
Figure 2 概括了完整管线。目标视角投影、渲染几何和检索到的历史状态作为临时辅助块参与注意力;每个 chunk 完成后,临时证据块被移除,而 finalized outputs 进入 rolling cache,其视觉特征在 eviction 后进入历史库。论文还说明 native block 保留 18 个 latent-frame-state slots:六个 source anchors、八个 recent-history states 和四个当前 chunk states。这个细节很重要,因为它表明 World in World 并未无限堆叠所有历史,而是在固定原生槽位之外插入 temporary auxiliary blocks。
证据构造:从视角投影、主体几何到检索历史
有了统一接口之后,第二步是为不同控制需求提供互补证据。源视频观测本身是外观锚点,但它停留在 source-camera view;当目标相机变化时,观测内容需要被重新放置。World in World 用 DepthCrafter 估计深度,再把源像素反投影到三维空间,并从源相机重投影到目标相机,从而得到显式空间布局证据。
这里 是与目标帧 在事件时间上对齐的源帧 的 RGB, 是估计深度, 是源相机, 表示目标相机,其中 是内参, 是 camera-to-world pose。输出 、 和 分别是目标视角 RGB、可见性 mask 和目标相机深度。相比仅把源视频作为 appearance anchor,这个式子增加了“空间放置”的显式信息,让查询能够在几何支持区域中读取目标视角布局。论文进一步把可见性和几何可靠性转成 token-level support weights。若深度或 pose 错误,投影会错位,因此该通道不能以全强度参与;support weights 的作用就是让模型只在可信区域使用布局证据。去掉这一通道会退化成依赖外观注意力隐式对齐,而 Table 2 的消融正说明这种退化代价极大。
投影只能搬运源视频中已经可见的内容。当相机快速移动或绕到主体另一侧时,源视频从未观测到的主体表面没有直接外观参考,模型可能生成错误形状或姿态。为此,World in World 引入 renderable subject representation,在目标相机和对应事件时间下产生形状与外观提案。
其中 是事件时间 下的主体状态, 是目标相机,输出分别是目标视角 RGB、几何支持 mask 和目标相机深度。论文给出的一个典型主体状态是 ,其中 是由 LHM++ 从清晰、少遮挡全身源帧重建出的 avatar, 是驱动 avatar 的每帧 SMPL-X 参数。这个式子在证据链中的作用是“补全提示”:它不要求生成器凭空想象新表面,而是把可渲染的几何和外观作为辅助证据送到注意力入口。论文还用目标相机深度解决主体间遮挡,并比较人体几何深度与投影场景深度,以删除主体边界附近不可靠的背景投影。其边界也很明显:这一路证据依赖可重建主体、深度尺度对齐以及 avatar-body 参数;论文示例主要围绕人体,复杂非刚体物体或一般场景物体没有被同等形式化地覆盖。
检索历史证据则解决第三个问题:长时重访。native rolling cache 只保留有限近期状态,早期 finalized states 会在 eviction 后不可读。World in World 在 eviction 时把每层 clean K/V 连同相机位姿和时间索引归档,形成 rollout-wide history bank。每个目标 chunk 根据目标视角表面覆盖和 viewing-direction compatibility 排名,再选择有界数量的 个多样化 top-K 历史状态。这个选择逻辑的物理直觉很直接:镜头回到某个区域时,需要的是能解释该区域旧外观的参考,而不是重复但视角相近的状态。若没有历史库,生成器只能根据当前观测和近期 cache “重新编造”旧区域;若有库但不做覆盖和方向选择,注意力又会被冗余参考淹没。
证据读取控制:路由对应关系并调节每个通道的强度
提供证据只是第一步,更大的问题是模型能否在正确位置读取正确证据。论文指出,纯外观 attention 在大视角变化、动态运动和重复纹理下会歧义:一个表面换角度后外观改变,两个不同位置可能看起来相似。CGAR 因此用持久点身份和相机几何建立当前生成 token 与源视频 token 的对应,并在 attention score 中加入对应权重。
这里 是当前查询, 是源视频键, 是 attention head 维度, 是正实数对应置信度,只有在存在有效几何匹配时才会出现。式中的基础项仍是原生自注意力分数, 则作为先验偏置;由于 softmax 对 logit 取指数,这个对数项在未归一化 attention 中等价于对匹配键乘以 。它把“从哪里读”从外观相似性部分转交给几何对应。若删除 ,系统退化为外观引导 attention,论文在文字中说明这会在重复纹理和大幅视角变化下变得含糊;若 很小,则错误匹配被削弱,模型更依赖其他证据通道。CGAR 的输出再与其他 attention-block responses joint normalization,因此它不是单独替换注意力,而是在多个证据块之间建立可解释的优先级。
不同证据通道的可靠性随空间和 denoising stage 变化,所以还需要调节“读多强”。论文受 CFG 与 NAG 启发,提出 evidence-wise attention CFG。它不是简单地给每个辅助块乘一个固定权重,而是在同一 attention layer、同一 query 下比较 native-only response 与 evidence-conditioned response,只放大证据带来的互补方向。
其中 是只 attend native block 得到的响应, 是同时 attend native block 与证据 后 joint normalization 的响应, 是非负引导强度, 表示把 投影到 方向上的分量。方括号项是证据响应中去除 native 方向后的残差,也就是论文所说的 complementary direction。这个式子的设计理由很关键:如果直接放大 ,原本已经由模型自身完成的生成也会被反复放大,容易造成过强指导和不自然;如果去掉证据与 native response 的夹角门控,冲突方向也可能被误加。若令 ,修正项消失,输出仍是联合 attention 响应但没有额外互补增强;若 不高于 ,修正项被门控关闭。论文还说明 EWA 复用同一次 denoising forward 中的 attention responses 和 normalization 结果,因此不增加 denoising network 的 NFE。它的代价从“额外前向”转移到了证据构造和 auxiliary token 上,而非 backbone 的多轮调用。
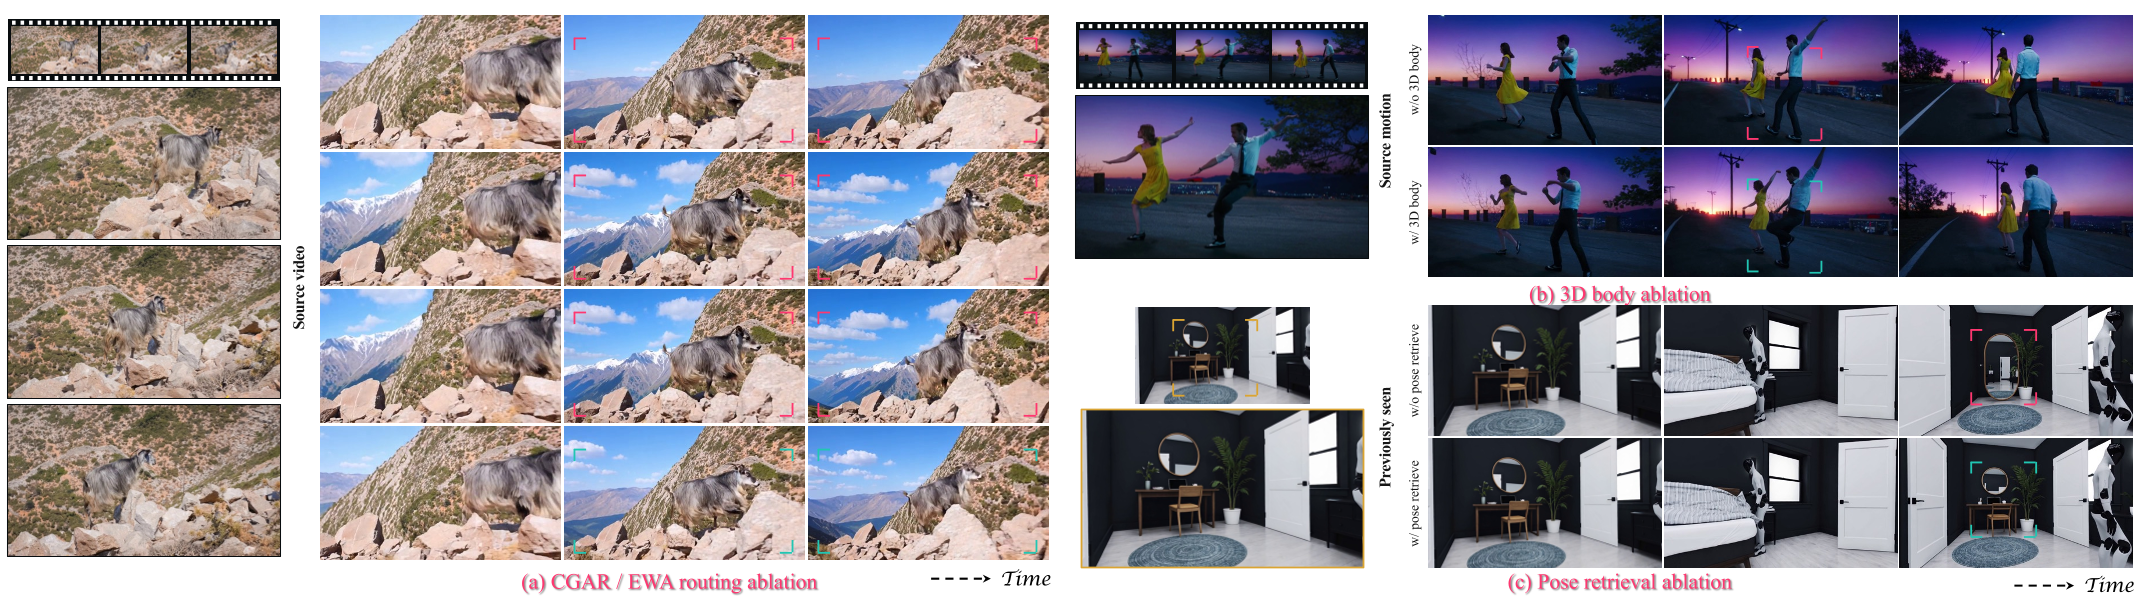
Figure 6 的定性消融与上述机制对应。子图 a 说明 CGAR 与 EWA 有助于保持主体外观和背景结构;子图 b 说明 rendered body geometry 可以引导新暴露主体区域补全;子图 c 说明 camera revisits 已生成区域时,historical retrieval 能恢复之前建立的外观与 layout。这里值得注意,论文没有把所有证据都写成同等重要的定量增益,而是区分了“证据是否可用”与“证据是否被正确读取”两个层面。
实验与证据
实验围绕 camera-controlled video rerendering 展开。论文在 LingBot-World 2.0 的 publicly released causal-fast checkpoint 上实例化 World in World,所有预训练参数冻结。对比方法包括 ReCamMaster、TrajectoryCrafter、WorldForge、InSpatio-World、UniWorld-View 和 CameraAnything,均使用官方实现、checkpoint 和推荐配置;所有方法接收同一 source video 和连续目标相机路径,并在评估前对齐相机角度与帧数。评价包括 VBench 多个维度、camera trajectory errors 以及 image fidelity。相机轨迹误差用 Depth Anything 3 和 ViPE 分别估计生成视频轨迹,再与目标轨迹比较并平均。
Table 1 报告 DAVIS 和 OpenVid-1M 上的主结果。由于原文表格在提供文本中存在列对齐不完整的风险,下表只保留能够明确对应的 VBench、相机误差和保真指标。
| 方法 | 美学质量 | 画质 | 时闪 | 平滑 | 主体 | 背景 | 动态 | Overall | TransError | RotError 度 | PSNR | SSIM |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ReCamMaster | 54.283 | 66.290 | 95.178 | 97.503 | 88.941 | 92.154 | 92.500 | 83.836 | 0.124289 | 7.8626 | 15.1383 | 0.444346 |
| TrajectoryCrafter | 51.322 | 61.466 | 94.169 | 97.423 | 87.032 | 90.727 | 98.750 | 82.984 | 0.090812 | 5.3254 | 19.9689 | 0.625112 |
| WorldForge | 49.915 | 62.356 | 94.262 | 96.934 | 84.683 | 90.017 | 98.524 | 82.384 | 0.079961 | 4.5021 | 19.6494 | 0.589250 |
| InSpatio-World | 53.162 | 66.076 | 93.622 | 96.764 | 87.070 | 91.188 | 96.250 | 83.447 | 0.082399 | 4.4011 | 20.6855 | 0.613398 |
| UniWorld-View | 54.237 | 67.534 | 93.444 | 96.627 | 88.946 | 91.777 | 97.500 | 84.295 | 0.068705 | 4.1958 | 22.4735 | 0.770554 |
| CameraAnything | 54.365 | 67.526 | 94.489 | 96.908 | 87.399 | 91.817 | 88.750 | 83.036 | 0.186443 | 3.1868 | 15.1583 | 0.453712 |
| Ours | 56.556 | 68.004 | 93.711 | 97.749 | 88.948 | 92.627 | 98.750 | 85.192 | 0.068622 | 2.8326 | 23.1511 | 0.787205 |
Table 1 显示,本文方法的 VBench Overall 为 85.192,高于次高 UniWorld-View 的 84.295,差距为 0.897。更关键的是相机跟随:RotError 为 2.8326 度,低于 CameraAnything 的 3.1868 度;TransError 为 0.068622,也略低于 UniWorld-View 的 0.068705。同时,PSNR 为 23.1511、SSIM 为 0.787205,均高于 UniWorld-View 的 22.4735 和 0.770554。这说明 World in World 的性能并不只是 VBench 平均分提升,而是在相机控制误差和图像保真上同时改善。不过,Table 1 的个体维度并非全面第一:例如 Temporal Flickering 中 ReCamMaster 的 95.178 高于本文的 93.711。换言之,方法在总体一致性、相机跟随和保真上更强,但某些 flicker 指标存在权衡。
Table 2 给出 DAVIS 上的消融,重点比较 target-view warp、source-camera Plücker conditioning、CGAR 与 EWA。
| 变体 | 主体一致 | 背景一致 | 运动平滑 | 美学质量 | 时闪 | RotError 度 | TransError |
|---|---|---|---|---|---|---|---|
| w/o EWA and CGAR | 88.076 | 91.747 | 96.054 | 50.688 | 92.857 | 2.0346 | 0.056937 |
| w/o EWA | 88.056 | 91.706 | 96.055 | 50.720 | 92.867 | 1.9944 | 0.056608 |
| w/o CGAR | 88.055 | 91.728 | 96.072 | 50.713 | 92.891 | 1.7828 | 0.053913 |
| w/o Target-View Warp | 83.378 | 89.540 | 94.351 | 50.240 | 90.792 | 6.1158 | 0.581847 |
| w/o Plücker | 88.066 | 91.692 | 96.073 | 50.669 | 92.881 | 1.8811 | 0.056887 |
| Full method | 88.076 | 91.749 | 96.074 | 50.720 | 92.902 | 1.7823 | 0.053291 |
消融结果的核心归因非常清晰。去掉 target-view warp 是破坏性最大的配置:主体一致从 88.076 降至 83.378,背景一致从 91.749 降至 89.540,时闪从 92.902 降至 90.792,RotError 升至 6.1158,TransError 升至 0.581847。论文在 4.5 节中用约 3.4 倍和约 10.9 倍来描述这一退化,这与 Table 2 中 6.1158 对 1.7823、0.581847 对 0.053291 的比例一致。相比之下,去掉 source-camera Plücker 也会增加相机误差,RotError 从 1.7823 升至 1.8811,TransError 从 0.053291 升至 0.056887,说明目标视角布局和源视角相机信息都需要保留。CGAR 和 EWA 的定量效果在 Table 2 中相对温和,但结合 Figure 6 可以看出,它们主要服务于更难被平均指标捕捉的局部问题:重复纹理、主体外观、背景结构和新暴露表面。这也说明论文没有把每个模块都包装成平均分数暴涨,而是把它们放回对应的证据失效机制中。
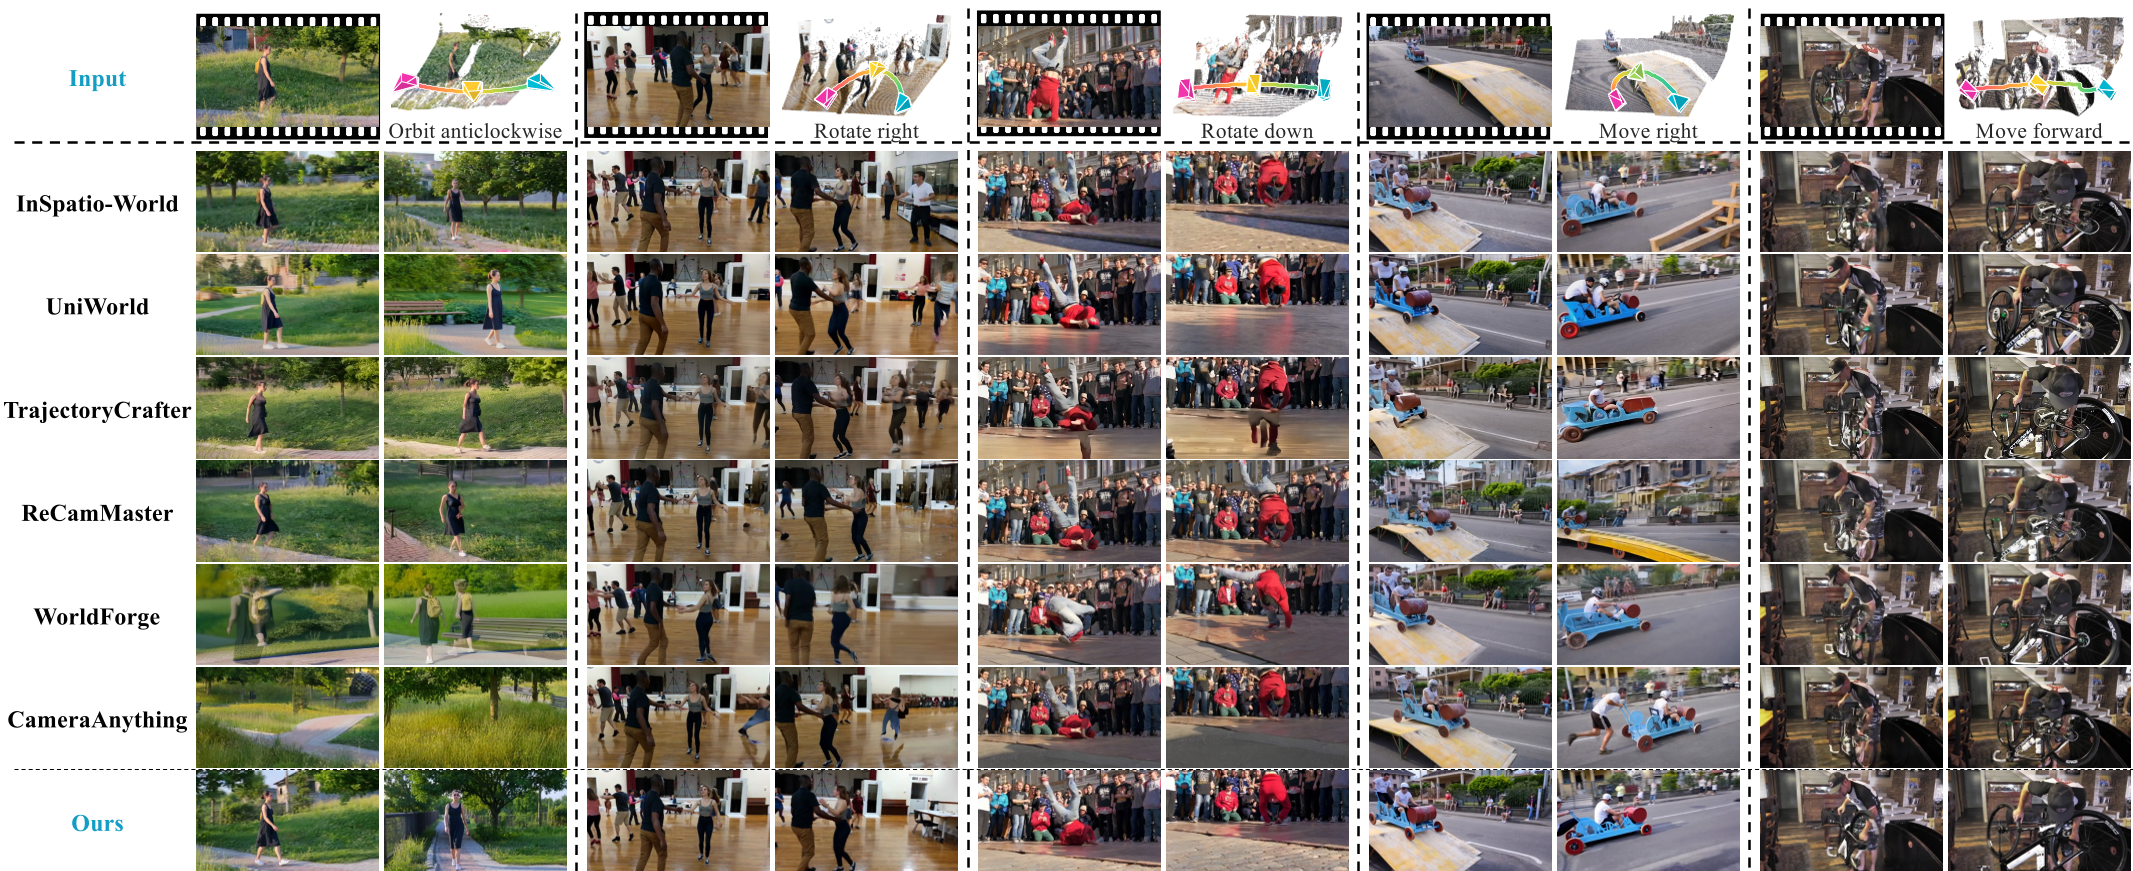
Figure 3 提供了多方法在同一 source video 和 target camera path 下的代表帧。它能直观支持 Table 1 的数字:World in World 在新视角放置、主体外观保持、背景结构和新生成区域补全方面更接近目标控制要求。不过,定性图本身不能替代定量证据,尤其不能说明不同 camera motion 分布下的统计稳健性。论文对更多下游应用如 bullet-time generation、video stabilization、video editing、K/V sharing 和 human-motion transfer 的展示主要是定性示例,这些例子说明接口具有延展性,但没有给出与 Table 1 同等级的基准数字。
从证据质量看,主结果跨 DAVIS 与 OpenVid-1M 两个数据集,且对比了多个官方配置 baseline,这比单场景 demo 更有说服力。消融集中在 DAVIS,并明确区分了 target-view warp、Plücker、CGAR、EWA,属于有效的拆解性证据。与此同时,论文没有报告 per-dataset breakdown,也没有给出 wall-clock latency、auxiliary token memory 或 external depth/rendering pipeline 的计算开销。论文强调 EWA 不增加 guidance NFE,这是准确且重要的,但它只是把额外成本从 denoising network 前向转移到证据构造和 auxiliary attention blocks;总推理代价仍需单独测量。
深度洞察与总结
World in World 的贡献不在某个单一 trick,而在把问题重新拆开:可控世界模型需要三件事同时成立——构造有用证据、定位相关证据、调节证据强度。它的核心机制是把源视频、投影、几何和历史全部变成同一类 clean visual states,再通过 native self-attention 读取;这使冻结 backbone 的 pretrained prior 成为可被外部证据“引导”的引擎,而不是每个控制任务都要重训的独立模型。CGAR 和 EWA 分别对应两个容易混在一起的问题:前者处理 attention 在外观歧义下“去哪读”,后者处理 attention “读多强”,并且只在同一前向里复用 responses,不引入额外 NFE。
局限性必须具体看。第一,整套接口高度依赖外部证据质量:DepthCrafter 深度、目标相机 pose、LHM++ 和 SMPL-X 对齐、persistent point tracking、history retrieval 的 ranking。若这些上游估计在复杂运动、遮挡或 scale ambiguity 下失败,target-view projection 和 geometry evidence 会一起退化。第二,论文示例中的 renderable subject evidence 主要围绕人体,虽然文字说明几何渲染可用于新暴露主体表面,但没有给出一般物体、复杂场景物体或非刚体运动的系统化定量基准。第三,实验 backbone 只有 LingBot-World 2.0 causal-fast checkpoint,接口是否依赖该模型的 clean-state cache、18-slot native block 或特定 RoPE 设计,论文没有跨 backbone 验证。第四,EWA 的 、support weights 的阈值、检索数量 和 denoising-stage activation 都影响最终结果,但论文未提供这些超参的敏感性实验。第五,VBench 与 image fidelity 能衡量视觉一致性和保真,却没有直接衡量“事件时间是否同步”的专用指标;这对 source-video rerendering 来说是关键维度。
未来的判断不应停留在“扩展更多场景”。更有价值的方向有三个。其一,把 World in World 的 clean-state interface 接到其他具有近期缓存的 causal video models 上,观察 native slots、RoPE temporal rotation 和 cache eviction 规则如何改变证据调度。其二,将 CGAR 的几何 routing 与 learned support weights 结合,用少量可学习模块预测每类证据的 、、,但仍保持 backbone 冻结,从而测试“训练-free”与“参数-free”之间的工程折中。其三,为 source-video rerendering 增加事件同步度量,例如动作阶段一致性、主体轨迹对齐、目标轨迹估计误差的分解报告,这样才能判断 EWA 的逐通道控制是否真正保持了 recorded event 的时间进程。总体而言,这篇论文给出了一个可落地的 inference-time 控制范式:冻结世界模型不必为每个新控制重学一遍,关键是要把新控制翻译成它能看懂、能定位、能调节强度的视觉证据。