
一个 Token 装下一整篇文档:xRAG 如何把检索向量变成 LLM 的一种模态
xRAG: Extreme Context Compression for Retrieval-augmented Generation with One Token
本文提出 xRAG,一种将检索式稠密向量重新定位为「检索模态特征」的极端上下文压缩方法,仅用单个 token 承载整篇文档信息。作者以两层 MLP 作为唯一的可训练模态桥,把检索器输出的文档向量投射进语言模型表示空间,检索器与 LLM 全程冻结。在六个知识密集型任务上,xRAG 相对无检索设置平均提升 16.2%(Mistral-7b)与 9.7%(Mixtral-8x7b),并把总 FLOPs 降低为原 RAG 的约三分之一。
TL;DR
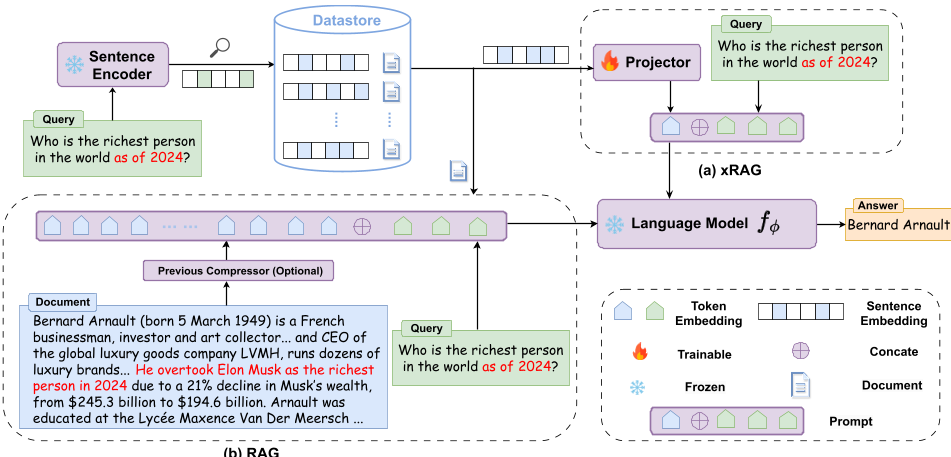
xRAG 要解决的问题很具体:RAG 把检索到的整篇文档拼进 prompt,输入长度动辄膨胀十倍以上,推理成本和上下文上限同时吃紧。它的做法是把稠密检索器早已算好的文档向量当成「检索模态」的特征,用一个两层 MLP 把它投影进语言模型表示空间,于是整篇文档只占一个 token。检索器和 LLM 全程冻结,可训练的投影器只占 Mistral-7b 参数的 0.46%,却在六个知识密集型任务上把平均分从无检索的 36.54 提到 42.46(Table 1),同时把 GFLOPs 降到原 RAG 的约三分之一(Table 2)。本质上,这是一次把多模态融合范式搬到 RAG 上的尝试,而不是又一次在文本表面做裁剪。
问题与动机
标准 RAG 的输入是文档与查询的拼接,语言模型要处理的是 ,长度为文档 token 数加上查询 token 数。论文引言用 Figure 1 说明这种做法的代价:一篇相关文档就能让输入相对原始查询扩大十倍以上。这不是"效果不够好"的问题,而是成本结构本身的问题——检索带来的收益被线性增长的输入长度持续侵蚀。
已有的上下文压缩工作分两派。软提示方法如 Gist、AutoCompressor、ICAE 把上下文压成稠密记忆槽,但代价是要为每个压缩 token 缓存 LLM 激活,论文引用 Gist 的数据称每个 token 需 1.05 MB;在包含数千万文档的检索语料上,这意味着要为整个语料预先存储激活,工程上不可行。硬提示方法如 LLMLingua、RECOMP 在文本表面做编辑或筛选,压缩率相对有限。两派的共同盲点是:它们都没有利用 RAG 系统里已经存在的那份"压缩结果"——稠密检索器通过大规模对比学习,早已把文档语义蒸馏进一个高维向量,论文引用 Morris 等人的结论称该向量几乎承载了与原文同等的信息量。
作者的直觉因此不是工程上的偷懒,而是有文献支撑的观察:既然检索器已经完成了信息浓缩,剩下的问题只是语言模型不认识这个模态。这一步恰好可以从视觉语言模型借来现成答案——CLIP 之类的模态编码器提取特征,再由模态融合桥接模块接入语言模型。检索器编码器与模态编码器在概念上的重合,构成了 xRAG 的立足点。
核心章节
出发点:压缩发生在哪个空间
先把标准 RAG 的输入形式写清楚。给定查询 与检索到的文档 ,语言模型 的输入是文档与查询的嵌入拼接:
其中 是 LLM 的词嵌入层, 是文档 token 数(实测平均 175.1,见 Table 1 最后一列), 是查询长度。这个式子的作用是定义压缩的靶子:所有压缩方法本质上都在缩小 这一项。它的边界也很清楚——只要压缩结果仍以文本 token 形式进入 ,压缩率就受限于"最少保留几个可读 token";而若压缩结果是连续向量,就必须解决"语言模型如何消费非文本向量"的问题,这正是软提示方法要缓存激活的根源。
xRAG 的回答是把压缩结果彻底移出文本空间。它的输入形式变为:
其中 是检索器对文档的稠密表示, 是待训练的模态投影器。相比上一个式子,改动只有一处: 被 替换,文档 token 数从 175.1 直接塌缩为 1。这个替换之所以成立,前提是 已经承载了文档语义;若换成随机初始化的向量, 不含任何文档信息,整个框架退化为带一个无用占位 token 的无检索模型。论文在 Table 3 里报告的 w/o finetune 一行(Mistral-7b 平均 37.87,对比完整版 44.58)正是这条边界的经验验证:投影器不训练时,单 token 几乎不带来增益。
核心内容:两阶段训练如何让 LLM 学会"读"向量
投影器本身只是两层 MLP,论文在 Design Principle 一节明确说这是为了保持框架简单,并承认 Q-Former 这类更复杂的模块也可以考虑。真正的难点不在结构,而在训练信号:一个纯文本预训练的 LLM 从未见过非文本输入,直接拿它做下游任务会立刻失效。xRAG 因此设计了两阶段课程。
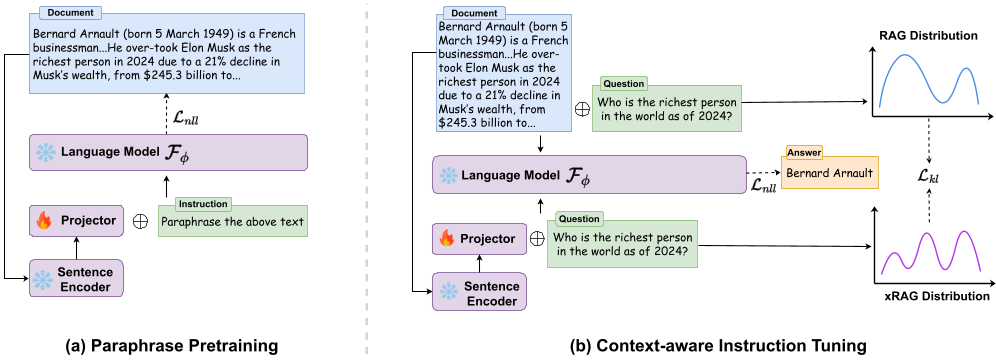
第一阶段是复述预训练,思路直接对标视觉语言模型用图像-描述数据对齐两个模态。对检索语料中的每个 (E, D) 对,用自然语言指令提示模型完成复述任务,例如「[X] 上述文本可以被复述为:[D]」,其中 [X] 是 的占位符。优化目标是标准的负对数似然:
其中 是 LLM 的 softmax 分布, 是文档的第 个 token, 是当前预测位置之前的文档 token(由因果注意力掩码保证)。这个式子的作用是在 与 之间建立可逆的表示对应:模型必须仅凭一个投影向量就重建整篇文档,梯度因此被迫把检索向量里的语义"翻译"成 LLM 能用的表示。它的边界在于,这一步只对齐了表示,没有教会模型"用"这些表示——论文在 3.3 节明确指出,预训练后的模型虽然有了内部兼容的表示,却从未被显式训练去把这些特征用于下游任务。附录 B 给出了 13 条语义等价但措辞不同的复述指令模板,这一细节暗示作者意识到指令措辞的多样性对避免过拟合单一模板是必要的。
第二阶段是上下文感知指令微调,数据规模约 95.5 万条(Table 7),混合阅读理解、开放域 QA 与摘要三类。这里同时优化两个方向。方向一是语言建模,把标准指令微调的上下文从文本换成稠密特征:
记号与前式同构,唯一区别是条件项从 换成了 ,即由上下文经句嵌入模型得到的向量; 是答案 token 序列。这一项的作用是把"能重建文档"推进到"能用文档答题"。但它单独使用会出问题:最大化答案似然会诱导模型过度依赖上下文,一旦检索器给出噪声文档,模型就会被带偏——这正是无检索基线之上的 RAG 在鲁棒性上的老毛病。
方向二正是为了修这个问题。作者引入自蒸馏,把使用完整文档的 RAG 当作教师、xRAG 当作学生,最小化两者输出分布的 KL 散度:
其中教师侧以文本上下文 为条件,学生侧以投影向量为条件,查询 为简洁起见省略。这一项在论证链条里的角色不是提升峰值性能,而是塑造行为:它要求学生在给定压缩上下文时复现教师的整个输出分布,从而学会在文档无关时退回内部知识,而不是盲从检索结果。若去掉这一项、只保留 ,模型会退化成"有文档就信文档"的形态,在误导性检索下崩掉——Table 3 的 w/o self-kd 一行给出了实证:Mistral-7b 的平均分从 44.58 掉到 41.49,resilience 从 82.3% 降到 76.2%,而 boost 率几乎不变(20.8% 对 22.2%)。这说明自蒸馏的作用点精确落在鲁棒性而非召回能力上。最终损失是两者的线性组合 ,附录 Table 10 记录 、KL 温度 1.0。
依据与代价:为什么是冻结而不是全参微调
一个值得追问的设计选择是:为什么不干脆全参微调 LLM 来适配压缩上下文?论文给出了两条理由。其一是即插即用性——RAG 本身对 LLM 是一个即插即用模块,它的压缩版本理当保持同样性质,若每个新 LLM 都要全参微调才能接压缩,这一性质就没了。其二是风险控制,论文引用已有研究指出全参微调可能损害 LLM 的其他核心能力。第三条理由更实际:全参微调无法复用离线构建的文档向量,而 xRAG 的全部内存优势正来自"不为每个压缩 token 存储激活"。
代价则体现在推理能力上。论文在 5.1 节和附录 G 都承认,在需要跨文档推理的任务上 xRAG 落后明显:HotpotQA 上 Mistral-7b 为 34.05,而完整 RAG 是 38.79;FactKG 上为 63.08,完整 RAG 是 67.76(Table 1)。作者给的解释是训练数据里没有推理相关样本,并把"让 xRAG 成为更好的推理器"列为未来工作。附录 Figure 7 展示了一个失败案例:检索到的文档列出若干大学,但最终答案需要判断这些大学都在瑞士,xRAG 无法完成这一步推理。这提示单 token 压缩丢失的可能是"可被下游逐步操作的结构化信息",而不只是语义内容。
实验与证据
Table 1 在两个骨干、六个任务上报告了完整对比,其中压缩方法与不压缩方法的检索文档完全一致、LLM 参数全部冻结:
| 方法 | NQ (EM) | TriviaQA (EM) | WebQA (EM) | HotpotQA (EM) | TruthfulQA (F1) | FactKG (Acc) | 平均 | 文档 token 数 |
|---|---|---|---|---|---|---|---|---|
| Mistral-7b 无检索 | 30.25 | 57.08 | 34.89 | 27.02 | 26.23 | 54.78 | 36.54 (0.0%) | 0 |
| Mistral-7b 有检索 | 42.71 | 65.88 | 37.84 | 38.79 | 26.50 | 67.76 | 43.63 (19.4%) | 175.1 |
| LLMLingua(高压缩率) | 28.81 | 57.09 | 32.33 | 29.13 | 26.10 | 63.57 | 37.48 (2.5%) | 61.1 |
| TF-IDF | 30.25 | 58.49 | 35.43 | 26.62 | 26.33 | 59.56 | 37.49 (2.6%) | 1 |
| xRAG (Mistral-7b) | 39.10 | 65.77 | 39.40 | 34.05 | 28.10 | 63.08 | 42.46 (16.2%) | 1 |
| Mixtral-8x7b 无检索 | 41.99 | 71.10 | 40.31 | 32.87 | 25.60 | 62.64 | 42.76 (0.0%) | 0 |
| Mixtral-8x7b 有检索 | 45.15 | 70.34 | 41.26 | 43.46 | 27.10 | 70.42 | 46.22 (8.0%) | 175.1 |
| LLMLingua(高压缩率) | 37.81 | 67.81 | 35.78 | 35.27 | 25.68 | 68.03 | 44.17 (-1.3%) | 61.1 |
| TF-IDF | 41.19 | 69.94 | 41.63 | 32.05 | 26.80 | 66.17 | 43.41 (1.4%) | 1 |
| xRAG (Mixtral-8x7b) | 47.28 | 74.14 | 44.50 | 39.66 | 27.80 | 68.20 | 46.91 (9.7%) | 1 |
这张表里最值得玩味的是 xRAG 与"完整 RAG"的相对位置。在 Mistral-7b 上,xRAG 拿回了 19.4% 增益中的 16.2%,差距只有 3.2 个百分点;而在 Mixtral-8x7b 上,xRAG 的 9.7% 反而超过了完整 RAG 的 8.0%。作者的解读是当前 RAG 系统在遇到无关或误导性文档时相当脆弱,这一解释在表内也有旁证:Mixtral-8x7b 上 TriviaQA 的完整 RAG 得分(70.34)甚至低于无检索(71.10),说明拼接文档确实可能伤害原本正确的答案。与此同时,同为单 token 的 TF-IDF 在 Mistral-7b 上只拿到 37.49,说明 xRAG 的收益不来自"压缩到 1 个 token"这件事本身,而来自压缩内容与 LLM 表示空间的对齐质量。
效率证据来自 Table 2,用 Torch Profiler 在 A100 上以 bfloat16 测量,GFLOPs 按生成 token 数归一化:
| 数据集 | RAG CUDA 时间 (ms) | xRAG CUDA 时间 (ms) | 时间加速 | RAG GFLOPs | xRAG GFLOPs | FLOPs 下降 |
|---|---|---|---|---|---|---|
| FactKG | 431.5 | 215.6 | 2.01 倍 | 4683.8 | 1289.5 | 3.63 倍 |
| NQ | 918.7 | 611.3 | 1.51 倍 | 1338.6 | 384.0 | 3.48 倍 |
| TriviaQA | 807.1 | 512.1 | 1.57 倍 | 1667.2 | 492.3 | 3.38 倍 |
| WebQA | 872.6 | 577.3 | 1.51 倍 | 1405.1 | 386.8 | 3.63 倍 |
| 平均 | — | — | 1.64 倍 | — | — | 3.53 倍 |
这里 FLOPs 下降幅度(约 3.5 倍)明显大于实际时间加速(约 1.6 倍),差值本身是重要信息:单 token 压缩消除的是 prefill 阶段随文档长度增长的那部分计算,而 decode 阶段的逐 token 生成成本与上下文长短关系较弱,且小规模单 token 输入可能受 kernel 启动与内存带宽限制,难以兑现全部理论收益。换句话说,xRAG 的成本优势在长文档、大 batch 的 prefill 密集场景下会更明显,论文未针对不同 batch 规模报告这一差异。
拆解性证据方面,Table 3 的系统消融给出了各组件的作用位置。以 Mixtral-8x7b 为例:完整版平均 51.45、resilience 84.9%、boost 20.0%;去掉预训练后平均降到 48.09,resilience 几乎不变(85.0%)但 boost 跌到 14.2%;去掉自蒸馏后平均 47.94、resilience 79.8%、boost 18.9%;不微调则平均仅 40.96、resilience 65.9%。这组数字勾勒出一条清晰的分工:预训练负责让模型"能读出内容"(影响 boost),自蒸馏负责让模型"知道何时不该读"(影响 resilience),二者不可互换。值得注意的是,论文在正文中称"自蒸馏比语言建模更重要",但表中 w/o nll 的下降幅度(Mistral-7b 从 44.58 到 43.02)其实小于 w/o self-kd(到 41.49),这一表述与表格的对应关系略有含糊,读者应以后者数据为准。
Table 4 的数据混合实验给出了另一个有价值的结论。仅用摘要数据(8.1 万条)训练的 xRAG 平均 43.42,仅用阅读理解(48.8 万条)则为 44.24,完整混合 44.58——差距远小于数据量之比。作者据此论证指令微调的收益并非来自任务特定知识,而是来自"使用投影上下文"这一通用能力的提升。这个论证是可信的,但也要注意它只在四个 QA 数据集上取平均,而这些数据集与训练集存在同分布风险。
Table 11 的嵌入模型消融则揭示了性能的来源结构。同一批 top-1 文档、七种嵌入模型下,SFR(MTEB 67.56)给出 44.5 的平均分,E5-Large(62.25)只有 42.1,而 BERT-base 规模的检索专用模型 Dragon 在 MTEB 无分数的情况下仍拿到 42.1,超过体积两倍的 BGE-Large(41.6)。这说明 xRAG 的上限既受通用句表示能力驱动,也受检索专用训练的影响,两者并非同一维度。
证据质量需要分层看。主结果在两个架构差异很大的骨干(稠密 7B 与 MoE 8x7b)上一致成立,且检索文档在压缩方法间严格对齐,这部分是稳健的。但所有实验都限定在 top-1 检索、单一稠密向量、英文维基语料上,论文附录 G 明确承认未覆盖 BM25 稀疏检索与 ColBERT 多向量检索,也未考虑 top-K 文档集成。这意味着"单向量足够"这一前提本身没有被检验:如果多向量检索能为单 token 提供更多互补信息,xRAG 的架构其实留有扩展空间(多文档时输入长度按 1 增长,而 RAG 按文档长度增长),但论文没有给出这条路径的任何数据。
深度洞察与总结
xRAG 的贡献可以精确地落到一处机制上:它把 RAG 的压缩问题从"如何删减文本"重构为"如何把一个已有模态接入语言模型",从而绕开了软提示方法的激活存储开销与硬提示方法的压缩率上限。这个重构成立的关键不是投影器的结构(两层 MLP),而是两阶段课程所提供的训练信号——复述任务负责表示对齐,自蒸馏负责行为塑造。Table 3 与 Table 4 的证据共同支持这一判断:真正决定性能的是"训练模型如何使用压缩上下文",而非压缩模块本身的复杂度。
局限也应当具体地指出。其一,xRAG 在 HotpotQA 与 FactKG 上的落后是结构性的(Mistral-7b 上分别差 4.74 与 4.68 分),作者归因于训练数据缺少推理样本,但这只是解释而非验证——论文没有做"加入推理数据后差距是否闭合"的对照实验,因此无法排除单 token 信息瓶颈本身就是主因。其二,KL 系数 与 KL 温度的取值在附录 Table 10 中给出,但论文未报告这两个超参是否在验证集上搜索过、也未给出敏感性曲线,这削弱了"自蒸馏是鲁棒性来源"这一结论的可迁移性。其三,所有效率数据在单一硬件(A100 加 EPYC 7V12)与单一 batch 设置下测得,缺少随 batch 与序列长度变化的缩放曲线,因此 1.64 倍的时间加速不宜外推到生产环境。
后续方向有三条是作者自己点明的,也有技术含量:一是把单向量扩展为多向量以恢复推理所需的可操作结构,这也直接对应 HotpotQA 的短板;二是把 top-1 扩展为 top-K 的文档集成,此时 xRAG 的输入长度按 token 数线性增长而 RAG 按文档长度增长,理论上优势会放大;三是把稀疏检索与稠密检索结合,让互补信息进入同一个投影空间。除此之外,一个作者未提及但值得追问的方向是:既然用了自蒸馏,教师分布本身是否可以被更强的教师(例如带推理链的 RAG)替代,从而把推理能力蒸馏进单 token——这或许是弥补推理差距比堆数据更直接的路径。