
人格测量的 AI 革命:Zero-shot 评分让日常语言揭示你的灵魂
Assessing Personality Using Zero-Shot Generative AI Scoring of Brief Open-Ended Text
本文验证了使用商用生成式大语言模型(LLMs)对简短开放式文本进行 "Zero-shot" 人格特质评分的可行性。通过对“思维流”和“视频日记”两种非结构化文本进行分析,研究发现多模型平均得分与自报告的人格特质(Big-Five)具有高度相关性,其表现达到或超过了现有的机器学习基线和人类同伴评分标准。
TL;DR
顶尖心理学家与 AI 研究者的最新跨界研究表明:不需要你填写成百上千道问卷题,只需要你“随便聊聊”或者录一段简短的视频日记,GPT-4 和 Claude 3.7 等大模型就能以不亚于你的亲密好友的准确度,识别出你的 Big-Five(大五人格) 特质。这种 Zero-shot(零样本) 评分法在无需任何针对性训练的情况下,展现出了惊人的效度和跨场景泛化能力。
核心速览:心理学的“语言学回归”
传统的心理测评一直处于两难境地:要么用死板的量表(效率高但丢失细节),要么用昂贵的人工临床访谈(细腻但难以规模化)。本文在 Nature Human Behaviour 发布的成果宣告了一个新时代的到来——大模型能够透过非结构化的“思维流”(Stream of Thoughts),精准捕捉人格的底色。
1. 痛点:为什么我们不再相信死板的问卷?
传统量表(如 NEO-PI-R)存在 “题项受限” 的缺陷。你只能回答研究者想问的问题,而无法表达对你而言真正重要的东西。
过去的研究曾尝试用计算机自动评分,但面临两大壁垒:
- 浅层分析:LIWC 等方法依赖词频计数,无法理解“我今天没去派对”在不同语境下究竟代表内向还是单纯的忙碌。
- 专家壁垒:定制化的机器学习模型需要数万条带有标注的数据和高深的编程能力,普通心理学研究者难以企及。
2. 实验设计:从“思维流”到“视频日记”
研究者采用了两种极具挑战性的数据源:
- 思维流(Sample 1):让参与者在安静的房间里大声说出 30 分钟内脑海中闪过的任何念头。
- 视频日记(Sample 2):参与者连续两周每天录制 1 分钟视频,描述当天最有意义的一件事。
核心方法论: 研究者并没有直接问 AI “这个人是什么样的人”,而是采用了一种更精妙的 “角色扮演推断法”:
提示语:“基于这段文本,请你作为这个人,回答以下人格量表题目。你的选项必须是:非常不准确、准确……”
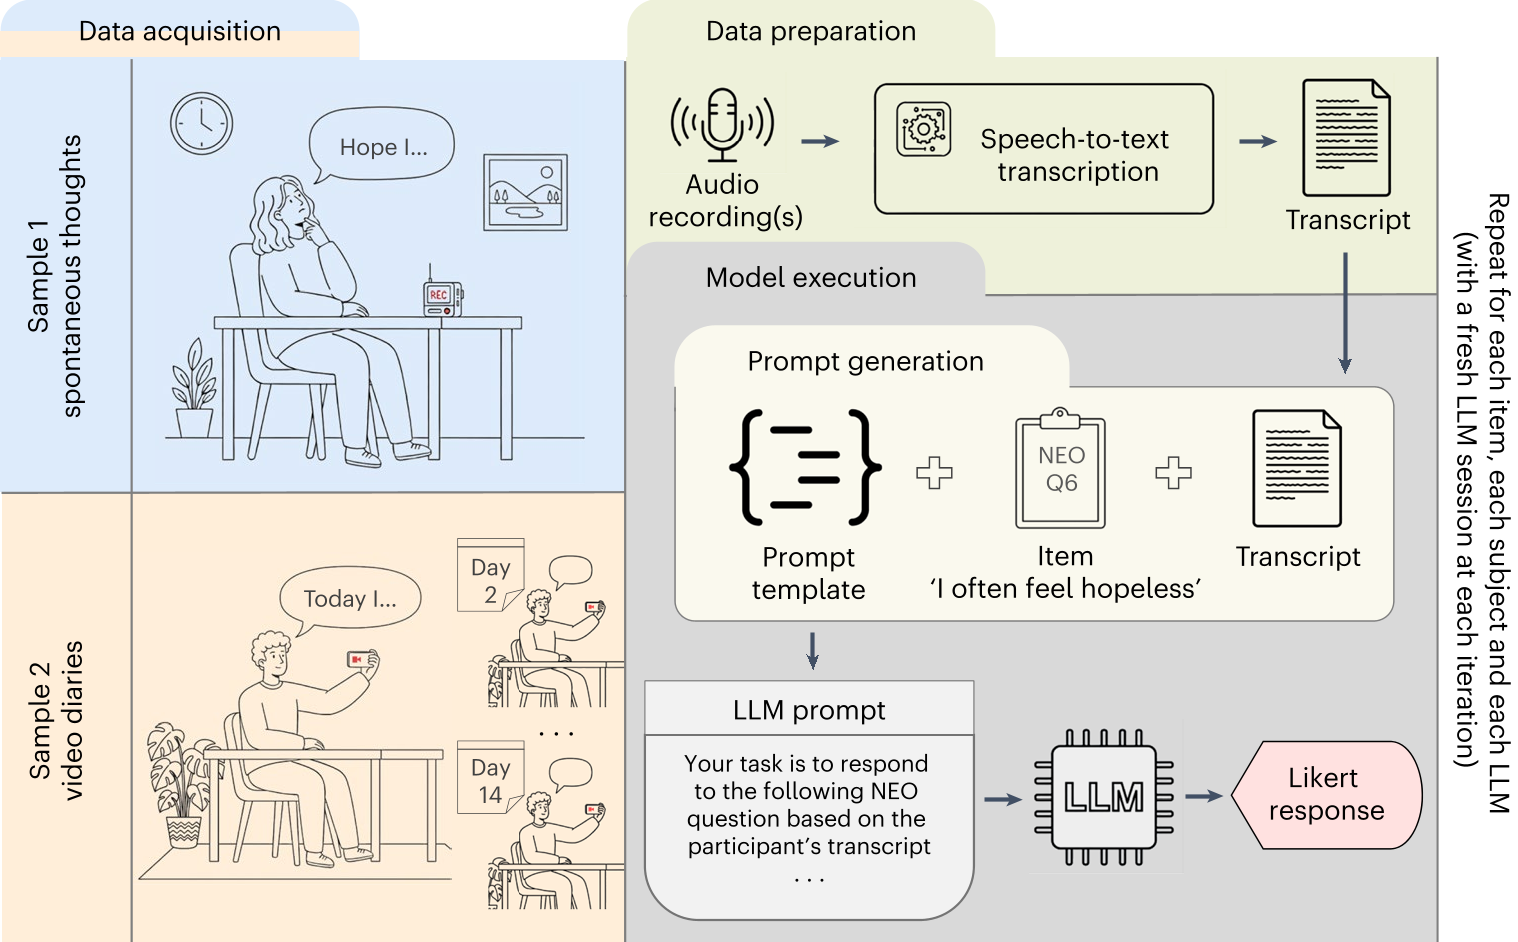 图 1:从文本采集、Whisper 转录到多模型并行评分的自动化流水线
3. 实验结果:群蜂智慧胜过单打独斗
实验测试了包括 GPT-4、Claude 3.7、Gemini 2.5 和 Llama 4 在内的 7 个顶级模型。结果发现:
- 收敛效度强:平均相关系数(r ≈ 0.41)达到了“亲密好友/家人”对受试者评价的水平。
- 模型平均(Ensemble)效应:就像人类评定员需要多人加权一样,取 7 个 LLM 的平均分能显著消除单个模型的偏见,获得最接近真实自报告的效果。
- 深度解析:AI 不仅给出一个分数,还能从文本中提取证据。例如,它能从受试者的一句“我总是在冲刺,却总是迟度”中精准给 “尽责性(Conscientiousness)” 打出低分。
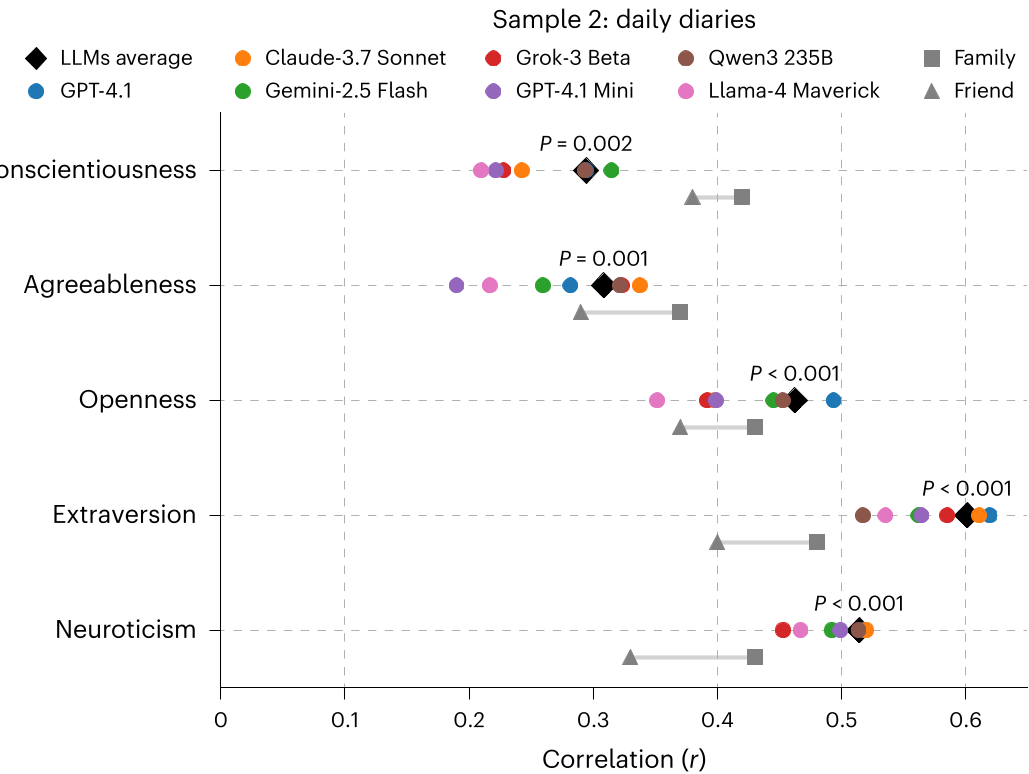 图 2:LLM 评分与自我报告的收敛相关度,灰色阴影区域为人类家人的评分基准,可见 AI 表现已进入该区间。
4. 深度洞察:为什么 AI 能读懂我们?
本文的成功在于证明了:人格是泛在的(Ubiquitous)。正如“词汇假设”所言,人格沉淀在日常语言中。 相比前人研究,本文的本质提升在于:
- 语义嵌入(Contextual Embedding):LLM 理解的是逻辑和情感倾向,而非简单的关键词。
- 零样本灵活性:无需特定领域的 Fine-tuning,意味着这种方法可以立即迁移到临床焦虑诊断、员工招聘评估等任何领域。
5. 局限性与未来
虽然结果惊人,但作者也保持了客观:
- 解释性黑箱:AI 给出的理由是后验的(Post-hoc),它内部真实的权重分配仍不可知。
- 文化偏差:AI 训练数据可能存在西方文化中心偏见。
- 隐私挑战:使用商用模型处理敏感数据(如自杀倾向)需要极其严苛的合规审查。
总结: 这项研究不仅为心理学家提供了一把利剑,更启示我们:在生成式 AI 时代,我们与机器的每一次对话,都在无形中绘制着我们的心理画像。
Takeaway for Tech-Leaders: 如果您正在开发招聘辅助、心理健康 App 或个性化推荐系统,本文提供的“Zero-shot 量表模拟法”是一种极低成本且高回报的特征工程方案。