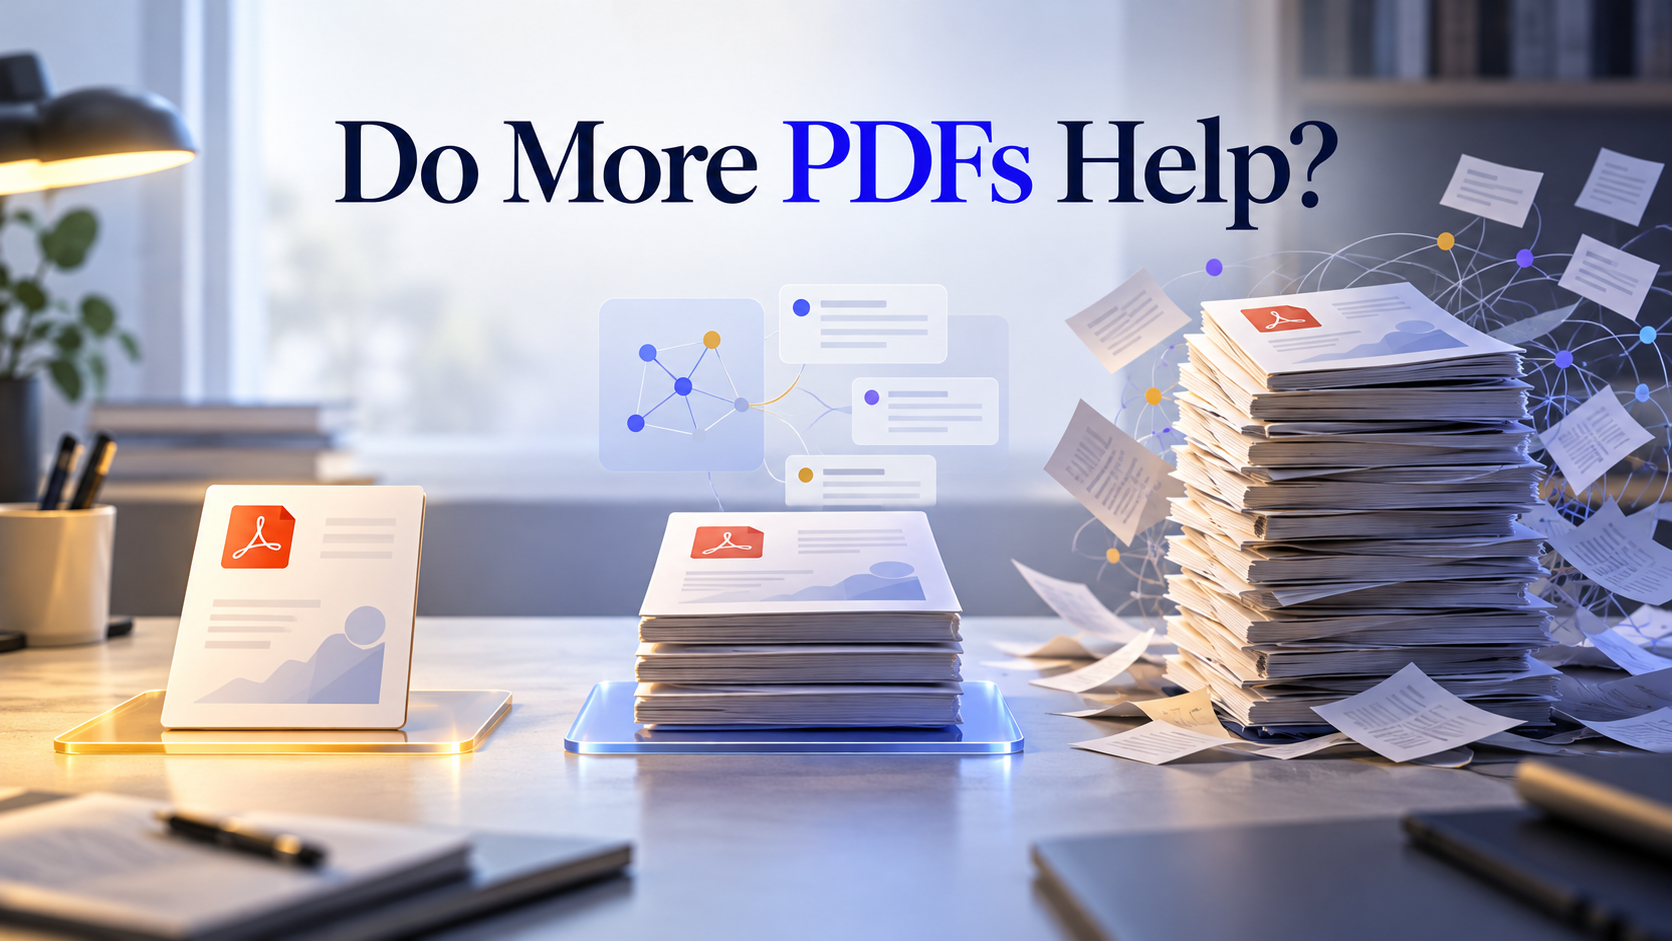
在这次测试中,增加 PDF 的确提升了覆盖面,但只持续到新论文不再回答同一个问题为止。此后,答案变得更宽、更顺,却更难看清核心比较。
我建立了三组材料:一篇高度相关的随机试验、三篇学生干预研究,以及十条搜索结果。最后一组还包含综述、评论和其他人群研究。
从一篇增加到三篇,发生了什么?
只有一篇时,答案很精确但也很脆弱。它能描述干预、主动对照、完成率和结果,却无法判断这个发现是否常见。
增加到三篇直接相关研究后,答案明显改善。它可以比较网页和邮件等不同交付方式、主动与较弱对照,以及不同睡眠结局,也暴露出一个需要进一步核查的表面分歧。
这是最大的一次有效提升。额外论文把问题从“这项试验发现了什么”推进到“这些试验为什么看起来不同”。
增加到十篇后呢?
十篇材料带来更多词汇和背景,但有些来源不可直接比较:人群不同,或者本身是综述和评论。如果提示词不要求区分来源类型,答案会把它们合成一个连贯故事。
结果听起来更全面,精确性却下降。更多上下文增加了 AI 可以写出的主张,不一定增加由可比证据支持的主张。
应该怎样增加 PDF?
按角色添加:
- 直接回答问题的核心研究
- 检查边界的对照研究
- 用于描绘领域的综述
- 用于解释方法或背景的论文
明确告诉 AI 每篇论文的角色,不要只要求“使用全部来源”。一篇论文可以作为有用背景,却不应该在结论中获得与直接证据相同的权重。
每次新增后追问:
加入这些论文后,哪些新主张才变得可能?
哪些来源不能与核心研究直接比较,原因是什么?
如果工具无法回答第二个问题,继续加文件很可能只会增加叙事噪音。
在 WisPaper 中整理来源角色
把工作集合放入 My Library。先用 Library QA 按人群、设计和用途分类,再对真正相关的子集提出综合问题。
最好的来源集合不是最大的,而是足以支持主张、包含有意义反例,并且能解释两者的最小集合。
常见问题
先从 3–8 篇直接相关论文开始,小批量增加,观察每一批究竟改变了证据还是只改变了措辞。