
当你把AI笔记当作一份待验证的声明清单,而非成稿的散文时,它们才能发挥最大作用。最快且可靠的方法是:先抽样风险最高的声明,将每条声明追溯到特定论文中的具体位置,确认其描述的数字和总体,并将任何无法确认的内容记录到更正队列中。本文提供这一流程、一个截止日期下的实例、一份可重复使用的清单,以及关于何时停止核查、何时上报的明确规则。
为什么抽样优于逐行阅读
你很少有时间重新阅读每个句子背后的所有来源。抽样之所以有效,是因为风险分布不均:有些声明容易正确且修正成本低,而另一些一旦出错则损害最大。Cochrane关于检索和筛选研究的指南基于同样的逻辑——依据明确标准制定计划,记录过程,分阶段筛选,而非将所有内容视为同等紧急。将这种分阶段思维应用于验证:分轮次筛选你的笔记,从最高风险到最低风险。
第1步:核查前先建立声明清单
将笔记拆分为原子声明——每行一个事实、数字或发现。一个包含两个数字的句子是两个声明。一个将结果与解释结合的句子是两个不同类型的声明。
为每个声明标注类型:
- 数字——统计量、样本量、效应或百分比。
- 总体——发现所描述的对象或人群。
- 归属——声明被归功于哪篇论文或作者。
- 推断——你或AI得出的、来源中未陈述的结论。
这份清单是你的工作队列。下游所有操作都基于行,而非段落。
第2步:优先抽样高风险声明
在截止日期前你无法验证所有内容,因此要排序。当声明符合以下条件时优先处理:
- 定量——任何数字都是高风险声明,因为数字容易颠倒或脱离上下文。
- 承重——如果声明错误,你段落中的论证就会崩溃。
- 归属具体——它指明读者可以查证的论文、作者或年份。
- 总体偏移——它将发现推广到实际研究群体之外。
- 不熟悉——它引用了你未曾亲自阅读的论文。
一个实用的抽样:核查每个数字和每个具名归属,然后在各章节中分散核查其余声明。如果笔记较短,全部核查;如果较长,这一排序仍能告诉你在时间紧迫时先核查哪些行。
第3步:将每条声明追溯到位置,而不仅是论文
“它在论文某处”不是验证。对于每个抽样声明,记录确切位置:章节、段落、表格或图号,以及页码(如有)。Cochrane强调记录检索和筛选过程,这同样适用——无法复现的追溯不是追溯。
如果声明没有可定位的来源,那是一个发现,而非死胡同。直接将其移至更正队列,状态标记为“无来源”。
当你首先需要找到基础论文时,使用学术搜索界面而非通用网络搜索。WisPaper搜索让你直接查找学术论文;一旦有了候选论文,将你实际会引用的论文保存下来,以便追溯目标集中在一处,使用我的文库。
第4步:同时验证数字和总体
数字只有相对于其所描述的总体才是正确的。将它们作为一对来核查:
- 数字是否与来源完全一致——相同单位、相同分母、相同舍入?
- 你笔记中的总体是否与研究中的总体一致?
- 数字来自研究自身的结果,还是来自其引言中引用的另一项研究?
最后一点能捕捉一个常见错误:论文背景部分引用的数字可能完全属于另一项研究。如果你的句子将其归因于你正在阅读的论文,请追溯到原始研究。
第5步:明确标记推断
将来源所述与你得出的结论分开。推断在论文中是合理的——只是需要可见。用“这表明”、“综合来看”或“我们将其解释为”等标记重写推断句子,并使其远离任何读起来像报告发现的句子。
一个有用的测试:读者能否仅从你的句子判断出是作者说的还是你说的?如果不能,就标记出来。
第6步:运行更正队列,而非心理记录
每个失败的核查都成为一行,带有状态和行动。将队列与声明清单放在同一文档中,以免在会话之间丢失。
| 声明ID | 声明(简) | 类型 | 来源+位置 | 核查结果 | 状态 | 行动 |
|---|---|---|---|---|---|---|
| C1 | 样本量数字 | 数字 | 论文A,方法,第4页 | 匹配 | 已验证 | 无 |
| C2 | “大多数参与者” | 总体 | 论文A,结果,表2 | 总体比笔记更窄 | 修正 | 重写以匹配研究群体 |
| C3 | 效应方向 | 归属 | 未定位 | 未找到来源 | 无来源 | 查找来源或删除 |
| C4 | “这表明……” | 推断 | 我的综合 | 来源中无 | 标记 | 添加推断标记 |
一致使用的状态:已验证、修正、无来源、标记为推断、上报。仅当行动完成时才关闭行,而非当你决定要做什么时。
实例:四天后到期的课程论文
假设你有一篇四天后到期的2500字课程论文,评分标准高度重视“证据使用”,图书馆访问权限覆盖部分但非全部来源。你的AI辅助笔记包含约40条声明。
第1天——清单和抽样。 你将笔记拆分为40行并标注类型。你标记了9个数字、6个具名归属和5个读起来像发现但可能是你自己推断的句子。这就是你的20条高风险集合。
第2天——追溯。 你将20行追溯到位置。12条干净验证。3个数字原来来自你来源引言中引用的另一项研究——你重新追溯至原始研究或删除它们。2个归属没有可定位来源,作为无来源进入队列。3个总体陈述比研究群体更宽泛,需要重写。
第3天——推断和缺口。 你标记5个推断句子。对于2个无来源行,你搜索基础论文;如果找到,将其添加到文库并重新追溯。如果无法定位,则删除声明而非任其无支持。当你需要询问已保存的论文时,文库问答让你基于上传到我的文库或从搜索结果添加的论文提问,这有助于你在记录位置前定位声明背后的段落。
第4天——关闭队列并决定。 你只重读标记为修正或标记的行,确认每个行动已完成,并检查没有推断句子仍读起来像报告发现。然后做出下面的提交决定。
诊断检查点
在固定点运行这些检查,以便问题在复合前浮现:
- 清单后: 每个段落是否至少有一行?没有来源的行已经可见。
- 追溯后: 抽样声明中有多少比例有位置?任何没有位置的声明都进入队列,而非被原谅。
- 数字/总体核查后: 笔记中是否有数字出现在多个地方?重复的数字会漂移——核查每次出现。
- 提交前: 每个队列行是否关闭?推断标记是否出现在句子属于你的地方?
停止和上报规则
在开始前设定这些规则,以免午夜时与自己讨价还价。
停止核查一条声明当: 它有定位来源,数字和总体匹配,归属正确。记录为已验证并继续。
上报给导师或讲师当:
- 经过真正搜索后,承重声明仍无法找到来源。
- 两个来源在你论证所依赖的数字上似乎冲突。
- 声明的总体与你论文的范围差异太大,重写它会改变你的论证。
- 你不确定改写是否越界为错误归属。
停止会话当: 队列增长速度快于你关闭的速度。这是缩减范围的信号——删除最弱的声明,而非浅层验证所有内容。
可重复使用的提交前清单
- 笔记拆分为原子声明并分配类型
- 已选择高风险样本(所有数字、所有具名归属、其余分散)
- 每个抽样声明都有来源和位置(章节、表/图、页码)
- 数字完全匹配,包括单位和分母
- 笔记中的总体与研究中的总体匹配
- 从论文背景引用的数字追溯到原始研究
- 推断句子标记为推断
- 更正队列没有开放行
- 已发送上报并纳入回复
做出提交决定
当每个高风险行已验证或关闭,每个推断已标记,且承重句子中无无来源声明时提交。如果无来源行仍存在于低风险支持句子中,删除那些句子并提交。如果无来源或冲突声明是承重的且你未收到导师回复,不要按原样提交该部分——删除声明,调整论证,并记录更改。决策规则关乎队列状态,而非笔记初读时的自信程度。
常见问题
继续阅读
如何检查论文是否被更正、更新或撤稿
更正、更新和撤稿是三种不同的事件,它们以三种不同的方式改变你从论文中可以负责任地主张的内容。如果你正在撰写决策备忘录、尽职调查说明或客户简报,并且有截止日期,那么实际问题不仅是“这篇论文是否仍然有效?”,而是“到底发生了什么变化,以及我草稿中的哪些句子受到了影响?” 本指南为你提供一个可重复的流程:解析标识符,阅读出版商通知,检查元数据关系,对事件进行分类,然后决定你的主张是继续成立、需要限定,还是必须撤回。最后附有一个示例、一份可重复
如何检查研究结果是否适用于你的人群
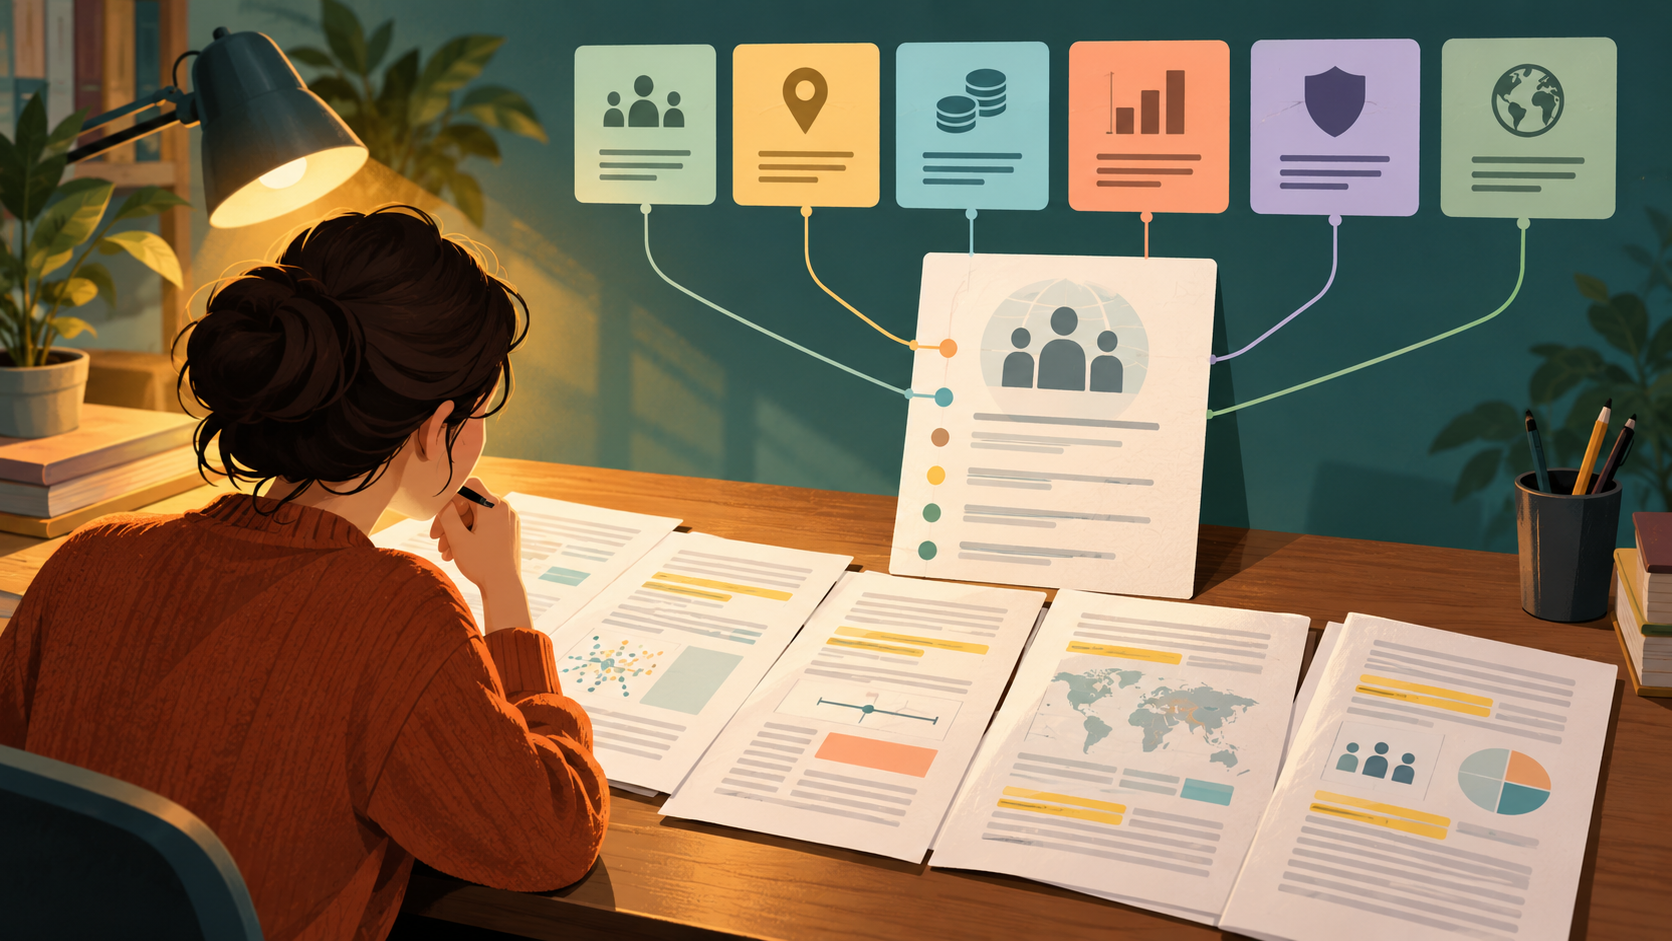
你面前有一篇很有前景的论文,日历上有一个截止日期,还有一个挥之不去的问题:这些结果真的适用于你正在撰写的人群、环境或问题吗?适用性是你一步步构建的判断,而不是从摘要中得到的感觉。实用的答案是,在六个维度上将研究与你的目标进行比较——资格、基线风险、环境、干预实施、结局和随访——并在每个检查点记录决定。 本指南为你提供这个顺序、一个在截止日期压力下的工作示例,以及一个可重复使用的清单。它还展示了像 WisPaper 这样的研究助手在工作流
如何检查你的文献综述是否遗漏了近期研究
一篇文献综述在你运行检索的那天可能是全面的,但在你提交的那天可能就不完整了。实用的解决方法不是从头重做整个检索,而是定义一个截止日期,重新运行日期限定的检索,跟踪提醒和引文更新,并且只整合那些会改变你的覆盖范围或解释的研究。本文提供了一个完整的流程,包括诊断检查点、一个实例、一个可重复使用的清单,以及明确的停止和升级规则,以便你的方法轨迹保持可审计。