
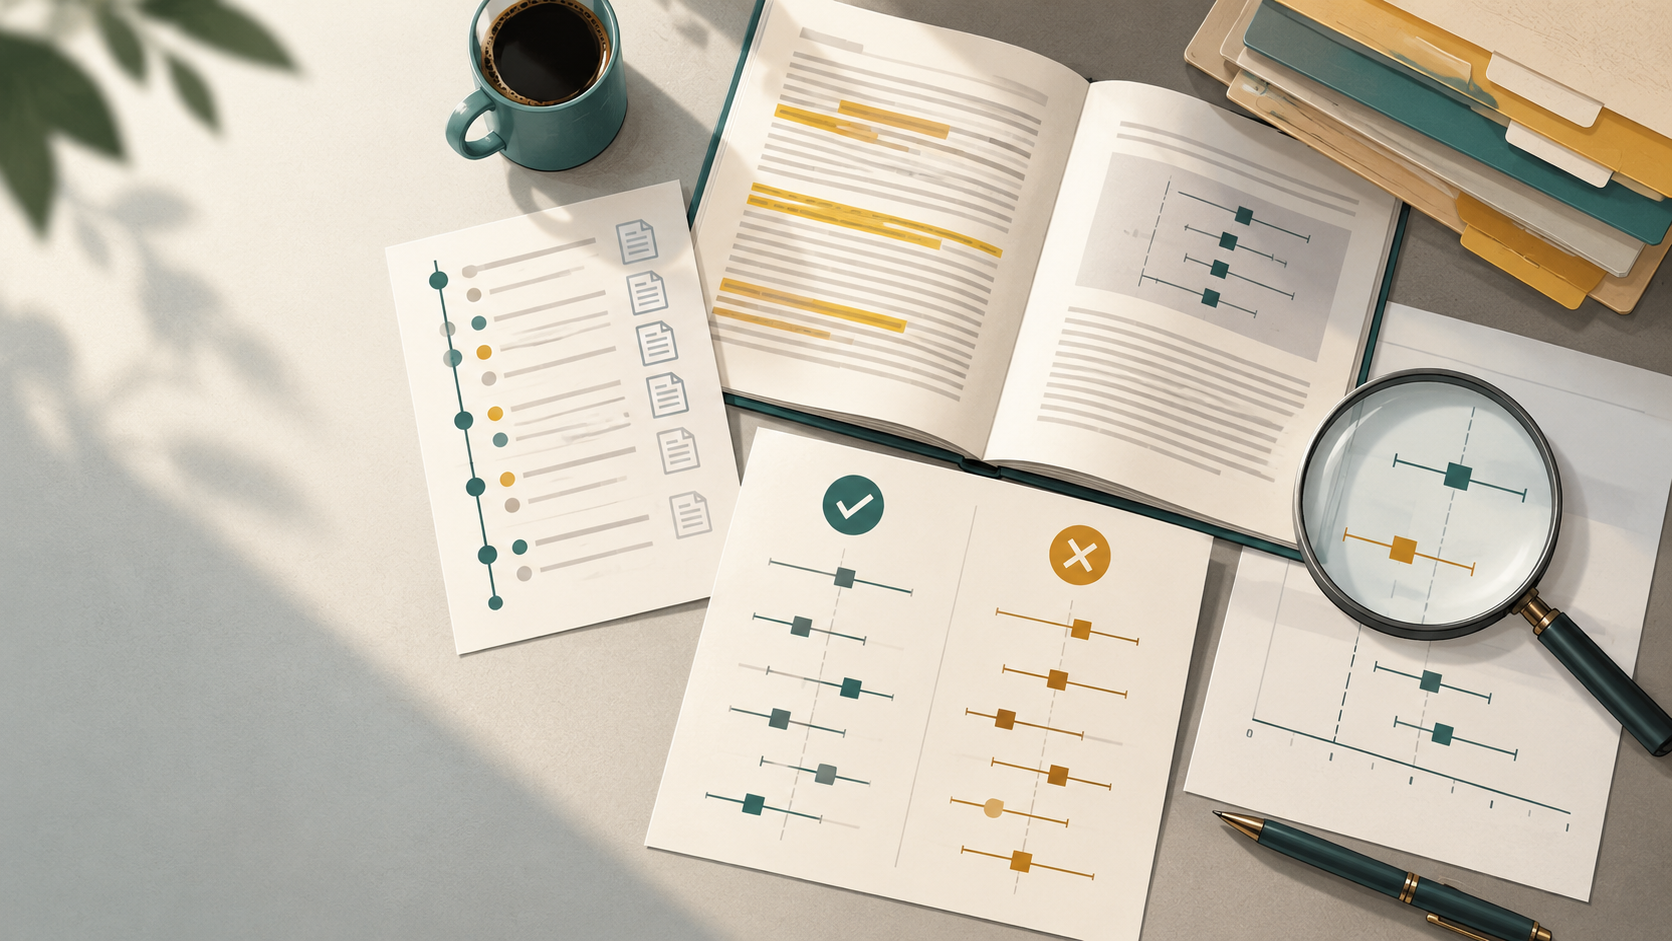
零结果或阴性发现不是需要掩盖的缺口——它是改变你的证据总结能主张什么的结果。实际挑战有三方面:找到那些未能证实你假设的研究,仔细阅读它们以区分真正的无效应和不精确,然后整合它们,使总结反映证据的平衡,而不是强结果和弱结果之间的虚假对称。
本指南为这项工作提供了完整的顺序,包括诊断检查点、一个工作示例、一个可重复使用的清单,以及关于何时停止搜索或升级判断的明确规则。它面向准备手稿、综述、修订或基金相关证据总结的研究人员。
从基于纳入标准构建的搜索计划开始
在搜索之前,写下什么算作相关证据。Cochrane关于搜索和选择研究的指南始于根据纳入标准规划搜索,然后使用多个来源,将自由文本词与主题词结合,记录过程,去重记录,并分阶段筛选。这种结构对零结果和阴性发现最为重要,因为你需要的研究往往是假设驱动的搜索永远不会浮现的。
你的纳入标准应明确说明报告无显著差异、非证实性结果或不确定结果的研究是合格的。如果你的标准只描述阳性发现,你就建立了一个过滤器,排除了你试图纳入的证据。
检查点: 读者能否从你的书面标准中看出零结果会符合条件?如果不能,在搜索前修订标准。
有意识地搜索非证实性证据
围绕你预期效应构建的单一搜索字符串往往会返回发现该效应的研究。要找到非证实性证据,计划针对结果而非结论的搜索:搜索暴露、干预和结果术语,而不使用预设结果的方向性语言。
Cochrane推荐的做法直接适用:使用多个来源,将自由文本词与主题词结合,并随时记录过程。记录不是行政开销——它让共同作者或审稿人看到你的搜索旨在找到否定性结果,而不仅仅是肯定性结果。
当你需要在广泛的文献中定位学术论文时,WisPaper 搜索 提供了一个学术搜索界面,你可以将其作为来源之一。记录界面、日期和你使用的术语,以便搜索保持可审计。
检查点: 你的搜索日志是否显示至少一个旨在独立于你的假设检索零结果或阴性结果的查询?如果没有,添加一个并记录。
分阶段筛选并链接同一研究的多份报告
Cochrane建议分阶段筛选并链接同一研究的多份报告。这一步是许多证据总结悄悄丢失阴性发现的地方:一项试验可能出现在会议摘要、全文和二次分析中,如果你将每个都视为单独的研究,你就会过度加权最常报告的结果。
先筛选标题和摘要,然后全文。在全文阶段,将描述同一研究的报告分组,并提取一次结果,注明所有链接的报告。在补充文件或亚组分析中报告的阴性结果属于其主要报告的同一研究。
检查点: 对于每个纳入的研究,你能列出你找到的所有报告并确认你提取了一次结果吗?
区分不精确与无效应
这是核心诊断步骤,也是虚假平衡最常进入的地方。报告宽置信区间跨越零的研究并未证明不存在效应;它未能排除一系列效应,包括可能重要的效应。围绕零的窄区间研究提供了更强的小或无效应的证据。
当你阅读每个非证实性研究时,记录:
- 效应估计及其置信区间,而不仅仅是p值。
- 样本量和估计的精确度。
- 研究是否设计和有足够功效来检测你关心的效应。
- 测量的结果是否与你的总结中的结果匹配。
描述为“无显著差异”的结果可能意味着效应接近零,也可能意味着研究太小或噪声太大,无法检测存在的效应。这些是不同的主张,你的总结不应将它们视为可互换。
检查点: 对于每个零发现,写一句话说明证据指向无效应还是不精确估计。如果你无法决定,标记给第二读者。
比较证实性和非证实性研究的报告质量
报告质量不是你只应用于不方便结果的决胜局。对证实你假设的研究和不证实的研究应用相同的质量评估。PRISMA 2020提供了报告清单、扩展解释、摘要清单和系统评价的流程图模板,包括搜索、选择和综合方法的透明报告。使用该结构使你的选择和综合可见。
对于每个纳入的研究,注意方法、结果和分析是否报告得足够清晰,以便你判断结果。报告不佳的阳性发现和报告不佳的零发现应受到同样的审查。如果你降低一个,就按相同标准降低另一个。
NIH关于科学严谨性和可重复性的指南将仔细评估先验知识、优势、劣势、知识差距、透明方法、验证和可重复性视为严谨实践的核心部分。该框架支持一个简单规则:你的证据总结应透明地展示自己的方法,包括你如何处理不符合的结果。
检查点: 建立一个两列比较——证实性研究和非证实性研究——并确认对两者应用了相同的质量标准。
整合而不虚假平衡
虚假平衡发生在总结对精确、实施良好的零结果和小型、不精确但恰好发现效应的研究给予同等权重时——或反之。整合应反映证据的强度和精确度,而不是每侧研究的数量。
一种实用方法:
- 按结果和比较分组。 不要合并测量不同事物的研究。
- 按精确度和质量加权。 来自报告良好研究的精确估计比来自小型研究的宽区间携带更多信息。
- 同时陈述证据的方向和不确定性。 “现有估计与很小或无效应一致,尽管两项研究的区间包括中等效应”比“发现混合”更诚实。
- 指出什么会改变结论。 如果更大、更好功效的研究可能合理地改变情况,说明这一点。
避免两种失败模式:只报告证实性研究,以及报告阳性与阴性结果的简单计数,好像计数就能解决问题。
检查点: 阅读你的综合段落,问读者是否能分辨哪些发现是精确的,哪些不是。如果不能,修订。
工作示例:手稿修订
假设你的团队正在修订一份手稿,声称干预改善了结果。审稿人问是否考虑了阴性发现。
- 修订纳入标准,说明报告无显著差异的研究是合格的。
- 运行针对性搜索,使用干预和结果术语而不带方向性术语,使用多个来源并记录每个查询。使用WisPaper 学术搜索作为查找学术论文的入口之一,并记录日期和术语。
- 去重并分阶段筛选。 链接同一试验的多份报告,使每个研究只计数一次。
- 提取估计和区间,针对每个非证实性研究,而不仅仅是显著性陈述。
- 分类每个零发现为无效应证据或不精确估计,使用区间宽度和样本量。
- 应用相同的质量标准于证实性和非证实性研究。
- 重写综合,同时陈述方向和不确定性,并注意什么证据会改变结论。
- 将纳入的论文保存在一个地方,以便共同作者可以审查同一组。 我的文库 允许你保存或上传论文,并在WisPaper库中组织它们。
- 在保存的集合中提出聚焦问题,当你需要检查特定研究如何处理其结果时。 文库问答 支持基于上传到我的文库或从搜索结果添加的论文提问。
- 在提交前更新搜索。 Cochrane建议在发表前重新运行搜索;记录重新运行日期和任何新记录。
对于更长的综合任务——例如起草跨多篇论文的修订文献讨论——学术智能体 是WisPaper中用于更长研究任务的区域,适合其文献综述、灵感或复现用例。保留你自己的提取表作为每个研究报告内容的记录。
可重复使用的清单
| 步骤 | 记录什么 | 停止或升级规则 |
|---|---|---|
| 纳入标准 | 明确声明零/阴性发现符合条件 | 如果标准排除非证实性结果,停止并修订 |
| 搜索 | 来源、日期、术语,包括一个非方向性查询 | 如果没有查询能检索零结果,升级 |
| 筛选 | 分阶段筛选日志;每个研究的链接报告 | 如果一个研究被计数多次,升级 |
| 提取 | 估计、置信区间、样本量、结果 | 如果只记录了p值,升级 |
| 分类 | 每个研究的无效应 vs. 不精确估计 | 如果不清楚,升级给第二读者 |
| 质量 | 对证实性和非证实性研究应用相同标准 | 如果标准因结果方向而异,停止 |
| 综合 | 同时陈述方向和不确定性 | 如果文本读起来像简单计数,修订 |
| 提交前 | 重新运行日期和新记录 | 没有记录的重新运行不要提交 |
停止和升级规则
- 停止搜索当你的记录查询(包括非方向性查询)在你的来源中没有返回新的合格研究,并记录该日期。
- 升级给第二读者当一个零发现可能合理地是无效应或不精确,并且你的分类会改变综合时。
- 升级给团队当证实性和非证实性研究无法在相同的质量标准上比较,因为报告太不均匀时。
- 不要最终确定综合直到搜索在提交前重新运行并记录了重新运行。
常见问题
继续阅读
如何在快速筛选中维护纳入与排除日志
快速筛选容易悄无声息地失败。你读了一个标题,决定“不纳入”,然后继续——三周后,当导师问你为什么提案中引用的一篇论文从未进入综述时,你无法重建这个决定。纳入与排除日志可以解决这个问题。它是一个小型、有条理的记录,将每个筛选决定转化为可辩护、可复查、可报告的内容。 本指南提供一个完整的流程:定义原因代码、一致地应用它们、记录边界情况,并构建一个经得起后续审查的审计轨迹。最后以一个学生实例和具体的提交决定结束。
如何链接报告同一研究的多个论文
一项试验可能在你的搜索结果中以方案、主要结局论文、二次分析、会议摘要和长期随访等形式出现。如果你将每个都视为独立研究,你的证据表会膨胀,偏倚风险评估会碎片化,你的综合会重复计算参与者。解决办法是一个有意的链接步骤:从每个候选报告中提取一小组识别字段,将共享这些字段的报告分组,然后为每个你需要的结果选择信任哪个报告。 本文为你提供该工作的可重复序列,包括诊断检查点、一个工作示例、一个可重复使用的提取表,以及当证据太薄弱无法自信链接时的停止
如何为导师会议准备证据检查
证据检查是一份简短、结构化的简报,你将其带到指导会议中,以便你和导师能在有限时间内对你的论文做出决策。它按顺序回答五个问题:你实际要回答的问题是什么,你找到的最强证据是什么,你的来源在哪里存在冲突,还缺少什么,以及你今天需要导师做出哪些具体决定。 本文为你提供构建该简报的完整流程,包括诊断检查点、一个工作示例、一份可重复使用的清单,以及关于何时停止搜索和何时升级的明确规则。它面向在课程截止日期、评分标准或有限数据库访问条件下工作的学生和