AI 生成的假设很容易在可检验之前,就先显得很“科学”:“自适应 AI 反馈通过提高元认知参与来改善学习。”它包含原因、结果和机制,但每一部分可能依赖完全不同的证据。
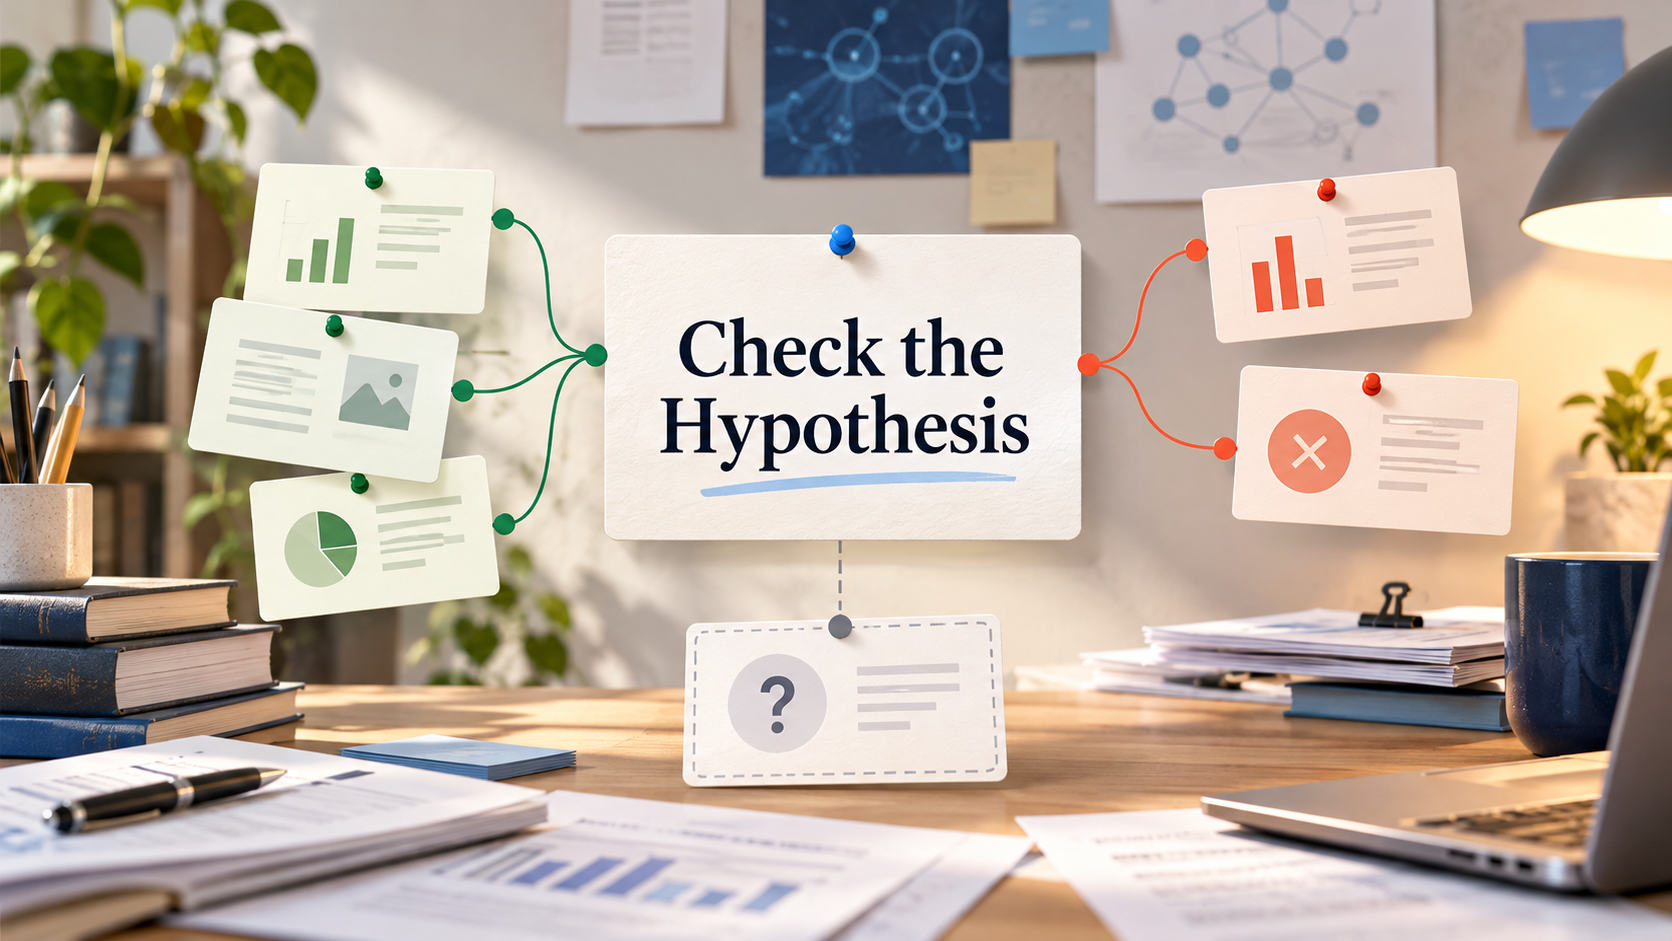
应该把假设当作一组需要分别检查的主张。
先把假设画成因果链
写出它建议的过程:
自适应 AI 反馈 → 更多元认知参与 → 更好的学习结果
然后分别问每个箭头需要什么证据。自适应反馈是否真的改变了元认知行为?这种行为是否预测或导致学习提高?有没有其他因素同时解释两者?
假设只有在能够产生可观察预测时才有用,而不是因为它用了几个听起来专业的词。
为每个连接同时寻找支持和反对证据
分别搜索:
- 直接检验完整假设的研究
- 每个机制环节的证据
- 相近人群和场景中的研究
- 无效或相反发现
- 替代解释
要求 Agent 找到最接近的反面研究,而不是只生成一段“局限”。如果所有论文都是为了同意假设而被挑出来,这个假设并没有真正接受检验。
检查变量能不能被测量
“参与度”“信任”和“批判性思维”都可能有很多含义。必须给出操作性定义:哪一种行为、量表、分数或观察结果代表变化?
还要提前定义什么结果会让你拒绝或修改假设。如果任何结果都能被解释成支持,它就没有发挥科学假设的作用。
比较相互竞争的假设
对同一个现象,至少生成两个替代解释:
- 自适应反馈通过元认知改善学习
- 自适应反馈只是增加了任务投入时间
- 本来就善于自我调节的学生更会使用自适应反馈
接着设计能够区分它们的证据。这往往比围绕原假设再生成十种改写更有价值。
检查可行性、伦理和贡献
一个合理的假设,可能需要无法获得的数据、未经验证的量表,或者不符合伦理的操纵。正式谈创新前,先估算样本、访问权限、时间、技能和风险。
还要问:假设得到支持或被否定后,会改变什么?即使能够检验,如果结果没有重要意义,也未必值得成为研究问题。
用 WisPaper 建立证据链
在 WisPaper Search 中分别搜索每个箭头和每种替代解释。把最接近的研究存进 My Library,再通过 Library QA 确认每篇实际包含哪些变量、人群、设计和结果。
Scholar Agent 可以帮助生成假设与反驳,但最终证据地图应该放在头脑风暴之外,避免漂亮措辞替代真实支持。
常见问题
需要足够依据说明它合理且可检验。创新可以来自新的连接或场景,但组成假设的各部分仍要有理由。